2622个爬虫API,这个仓库全收录了
2622个爬虫API,这个仓库全收录了
做开发的人,十有八九都写过爬虫。写爬虫最烦的不是代码本身,是找接口、处理反爬、解析数据这些琐碎的事。每次接一个新网站,都得从头来一遍。
最近发现一个GitHub仓库,专门干这件事,把市面上能用的爬虫API全收集起来了。Star数3600多,不算特别高,但内容密度很实在。
到底收录了什么
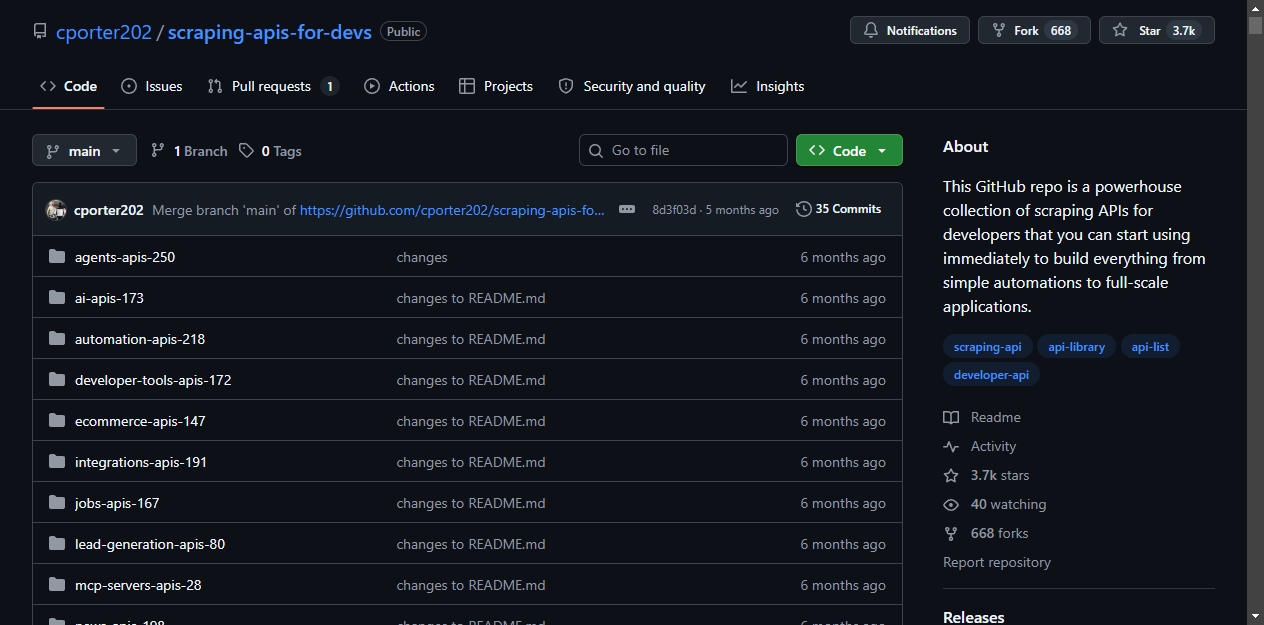
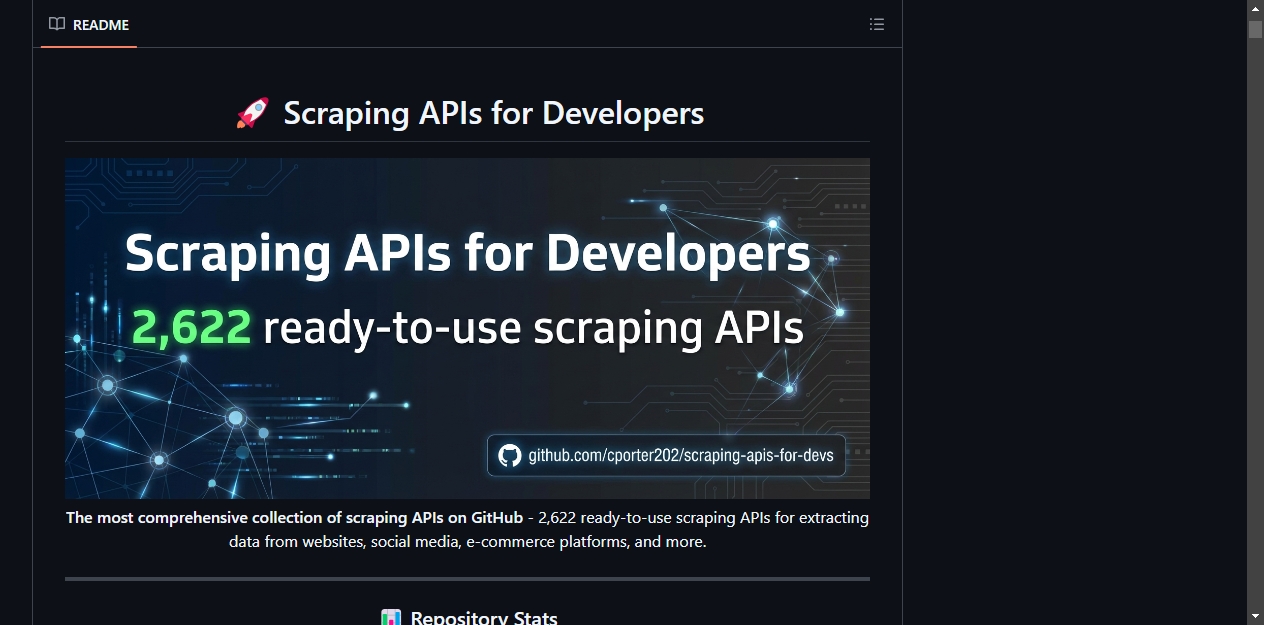
这个仓库叫 Scraping APIs for Developers,目前收录了2622个爬虫API,分成17个类别:
- Agents(250个)
- AI(173个)
- Automation(218个)
- Developer Tools(172个)
- Ecommerce(147个)
- Integrations(191个)
- Jobs(167个)
- Lead Generation(80个)
- MCP Servers(28个)
- News(198个)
- Open Source(216个)
- Real Estate(130个)
- SEO Tools(159个)
- Social Media(73个)
- Travel(139个)
- Videos(148个)
基本上你能想到的数据源,这里都有对应的API。亚马逊商品数据、Google Maps信息、社交媒体帖子、职位列表、房产数据,全在里头。
这些API从哪来
扫了一下内容,大部分API来自Apify平台。Apify是一个专门做网页抓取的云平台,开发者可以在上面发布自己的爬虫工具,其他人直接调用。
这个仓库做的事,就是把Apify上能用的API按类别整理出来,每个API都有名称、简介和链接。相当于做了一个索引,省得你自己去Apify上一个个翻。
实际能用来干嘛
如果你在做这些事,这个仓库会有用:
市场调研:想看某个品类在亚马逊上的竞品情况,直接调API拿数据,不用自己写爬虫处理反爬。
数据采集:需要批量抓取某个网站的信息,比如房产列表、招聘信息,这里有现成的方案。
AI项目:做RAG或者训练模型需要大量网页数据,这些API可以直接输出结构化数据,省掉清洗的步骤。
SEO分析:关键词研究、竞品分析、排名追踪,159个SEO相关的API够用了。
有什么局限
说实话,这个仓库的组织方式有点粗糙。就是一个大列表,每个API一行介绍,没有评分、没有使用体验、没有对比。2622个API堆在一起,想找最适合自己的那个,还得挨个试。
而且大部分API都是Apify上的付费服务,免费额度有限。如果是个人开发者做小项目,成本要考虑进去。
另外,这类API的稳定性是个问题。网站改版、反爬升级,API可能随时失效。仓库说是每天更新,但具体哪些API还活着,得自己验证。
我的看法
这个仓库适合做参考目录,不适合直接拿来用。如果你有明确的需求,比如"我需要抓取亚马逊商品数据",来这里看看有什么选项,比自己去Google搜靠谱。
但如果你指望找到一个万能的爬虫解决方案,这里给不了。2622个API看着多,真正好用的可能也就那么几十个,得自己筛选。
仓库作者每天在更新,说明还在维护。对于经常做数据采集的开发者来说,收藏一下不亏。
,真正好用的可能也就那么几十个,得自己筛选。
仓库作者每天在更新,说明还在维护。对于经常做数据采集的开发者来说,收藏一下不亏。
电商企业物流数字化转型必备!快递鸟 API 接口,72 小时快速完成物流系统集成。全流程实战1V1指导,营造开放的API技术生态圈。
更多推荐
 0
 0
- 0


 已为社区贡献1条内容

所有评论(0)