登录社区云,与社区用户共同成长
邀请您加入社区
第 033 篇 | 物流服务 | 中级本文是“100篇爬虫实战项目设计”的第033篇,主题为公开物流查询结果。项目输出字段包括运单号、承运商、节点时间、节点描述、状态、城市,推荐使用httpx + Pandas + Celery完成。文章将从数据源分析、架构、采集、解析、清洗、存储、异常恢复、测试、部署、合规和发布运营等角度,给出可用于学习和二次开发的完整方案。核心难点是查询频控、状态标准化和隐私
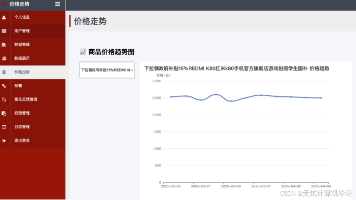
本项目完整实现了京东电商服装数据爬虫采集、数据持久化存储、双端系统开发、多维度数据可视化、智能销量预测、用户与商品运维管理等全流程功能。系统界面简洁美观、操作便捷、运行稳定,有效解决了传统电商数据统计单一、数据更新滞后、趋势分析不直观的问题。
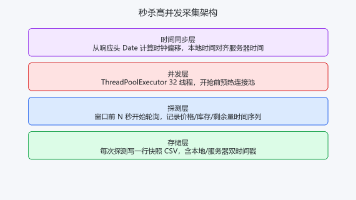
本文详解电商秒杀商品高并发采集实战,解决时间不同步、窗口错过等难题。通过解析HTTP响应头Date校准本地时钟偏移,预热连接池提前5秒准备,使用线程池并发探测多个商品状态,并在秒杀窗口内毫秒级轮询,记录本地与服务器双时间戳快照。最终生成带时间序列的库存变化CSV数据,实现精准分析秒杀全过程。
数据分析这件事,门槛从来不在技术,在于你有没有把它接到一个具体动作上。数据本身不产生价值。数据带来的"比别人早一步的判断",才产生价值。当你要跟踪的范围超出一个人能手动处理的上限时,你用什么来取数?想清楚这个问题,你的数据分析才算真正开始。如果你正在做多平台选品或竞品监控,需要一个稳定的电商平台商品与类目数据源,欢迎交流。
电商履约环节有个很实际的场景:一天几百上千个快递单号,需要批量拉取物流轨迹、识别异常件、按状态分类。逐个手动查不现实,直接并发硬拉又容易触发限流。这篇文章从工程角度拆解一套可落地的批量查询实现,重点讲限速、失败重试和多快递公司状态归一这三块。
"自建 vs 购买"是所有技术团队绕不开的决策。它是一个需要持续对抗的领域,对抗成本会随着平台风控升级而逐年上涨——这意味着自建方案的成本曲线是向上走的,而 API 的价格曲线,随着数据行业规模化,是平的甚至在往下走。方向比努力重要,这笔账早算早止损。想算一算你自己的账?我们整理了一份《电商数据接入成本测算表》(Excel,含自建/API 双方案公式),把你团队的实际参数填进去就能出对比结果。
本系统基于 Python 网络爬虫技术,结合 Flask 轻量级 Web 框架搭建电商价格监控平台,采用 B/S 架构实现商品价格自动化采集、数据分析、异常预警与可视化展示。系统运用 Requests、BeautifulSoup、Selenium 完成静态与动态网页数据抓取,通过模拟浏览器访问策略应对平台基础反爬虫限制,定时采集商品名称、售价、店铺等信息并存储至 SQLite 数据库。系统划分为数
跨平台电商比价爬虫的难点不在于“爬”,而在于“同时爬”——三个平台的反爬策略差异巨大,需要分别适配;IP封禁问题在跨平台场景下更加突出;数据标准化需要建立统一的映射规则。挑战解决方案某宝sign签名加密Cookie池 + 移动端接口 + sign逆向某猫动态令牌+设备指纹Playwright获取指纹 + 令牌定期刷新某东Cookie依赖Session管理 + Cookie池跨平台IP封禁站大爷隧道
电商API已经从单纯的数据接口,演变为连接平台与业务系统的核心基础设施。对于企业和开发者来说,掌握主流平台API的特点、设计合理的聚合架构、并关注AI和无头电商等新趋势,是在数字化运营中保持竞争力的关键。技术落地没有捷径,把签名、重试、限流这些基础打牢,后续的业务创新才能顺畅展开。
AI 时代的电商安全不再是「防不防得住」,而是「如何判断这个 AI 是谁、想干什么」。技术框架上,从静态规则转向动态行为分析、从二元拦截转向连续信任评估;业务上,要将安全策略与转化率对齐。如果你对电商安全工具或 AI 电商工具(包括 Bot 管理、API 防护、智能体接入)有选型需求,可以参考AICommerce 工具导航收录的工具列表,按需试用。数据来源:Akamai《互联网安全态势报告》解读,
我花了半天时间,用Python开发了一个CLI爬虫智能体,可以实现自动化采集Tiktok上公开的商品数据信息,可以通过商品url、店铺url、关键词等进行采集,一行命令直接拿到结果表。用亮数据的好处在于它的接口配置了一整套网页解锁、IP代理服务,能处理各种爬虫限制,包括动态加载、人机验证、浏览器指纹等,非常适合作为智能体的数据采集接口,它还有MCP服务,相当的好用。示例里提供了Python req
我看了它们的Github readme,这个CLI不光可以一键采集任意网页,还能实现谷歌关键词搜索、AI智能查找排序,能提取40多个全球主流电商、社媒网站的结构化数据,比如亚马逊的商品信息、领英的职位信息等。Bright Data CLI最大的好处在于解决了爬虫最难的门槛,那就是反爬限制,你不需要再配置IP池,也不需要去找打码平台,就能采集到各大主流网站的字段数据。到这里你就能看到Bright d
恶意爬虫和刷票行为对电商、票务、金融等行业造成了严重的业务威胁。恶意爬虫批量抓取商品价格、评论数据和用户信息,导致商业机密泄漏和服务器资源消耗;恶意刷票和薅羊毛行为通过自动化工具抢占优惠资源、刷取营销补贴,给企业带来直接经济损失。如何通过WAF有效防护这些业务层面的安全威胁,是企业关注的重点。
日常工作当中,很多岗位都会产生网页数据采集的需求。做市场调研需要收集行业公开资讯,行政运营要整理招投标公告,电商从业者需要整理公开商品信息,内容运营需要批量搜集行业素材。面对大量网页信息,如果依靠手动复制粘贴,不仅耗费大量时间,还很容易出现遗漏、录入错误,整体工作效率很低。提到批量抓取网页数据,大部分人最先想到的就是 Python 爬虫。但编写爬虫代码对普通办公人员并不友好,需要掌握基础编程知识。
【摘要】GofairGEO静态建站方案通过纯静态页面技术显著提升网站性能,实测加载速度较动态页面快70%,更利于搜索引擎抓取。其特色功能包括一键导出静态ZIP文件、自动配置SSL/CDN/防DDoS,以及AI批量发文等工具。典型案例显示,某电商平台使用该方案后,5天内实现多关键词登顶谷歌搜索,并凭借免注册下单等优势提升用户体验。文章指出建站常见误区,强调自主控制权与加载速度的重要性,推荐该方案作为
前面13篇学了一堆零散技能,今天全部串起来。从零搭建一个电商竞品价格监控系统——以当当网图书为例,完整走完"分析页面→编写爬虫→数据存储→AI清洗→生成报告"的全流程。代码模块化拆分成spider/parser/storage/cleaner/report五个模块,加上定时自动运行。这是一套可以直接拿去接私活的完整方案。
在跨境电商广阔的出海赛道中,面对复杂多变的市场环境与业务痛点,不少出海企业都在寻求安全可靠的网络工具,以此化解账号关联、采集受限、访问拦截等各类难题。巨量IP免费体验。
既然提到了八爪鱼,就不得不提后羿,两者逻辑很像,都是可视化操作的爬虫工具,它在跨平台(支持 Mac/Windows/Linux)支持上做得不错,且免费功能的开放度在某些版本上比较良心。八爪鱼是无脑式的数据采集器,通过可视化的拖拉拽操作,实现对网页的数据采集,它的核心逻辑是模拟人的操作(点击、输入和滚动),你打开它的内置浏览器,鼠标点哪里,它就记录哪里。做跨境电商或海外数据抓取的朋友都知道,最痛苦的
本文摘要: 针对新能源汽车市场信息过载问题,本研究开发了一套基于深度学习、爬虫技术和数据可视化的智能推荐系统。系统采用Java+SpringBoot+MySQL技术栈构建,通过爬虫自动采集多源异构数据,利用深度学习模型分析用户偏好实现个性化推荐,并借助交互式可视化界面直观展示车型对比、价格趋势等信息。测试结果表明,该系统能有效提升用户购车决策效率,为汽车经销商和电商平台提供智能化解决方案,具有显著
从“爬虫”思维切换到“API调用”思维,是Python数据获取能力的一次重要进阶。从对抗走向合作:与数据提供方建立合法、可持续的连接。从脆弱走向稳健:依赖规范的接口而非易变的页面结构。从技巧走向工程:更关注身份认证、错误处理、速率限制和系统化数据管道。掌握本文介绍的四步流程(发现、申请、调用、解析)和进阶技巧,你就能合规、高效地获取各大平台的选品数据,为你的电商分析、市场研究或内容创作提供强大的数
轻量化国产免费工具,智能自动识别网页字段,自带内容去重、繁简转换,对国内站点兼容性优秀,无强制采集量门槛,主打轻量日常抓取,学习成本低于火车采集器,适合临时整理表格、公开榜单数据。热门全中文可视化工具,个人免费版可长期使用,内置电商、房产、新闻类现成采集模板,拖拽即可完成翻页、点击、登录流程,支持导出 CSV/Excel,云端基础采集免费开放。免费开源即用即装,页面点选设置采集规则,单次少量抓取直
本文介绍了一种基于网络爬虫技术的个性化图书推荐系统。该系统通过爬虫从电商平台、社交媒体等来源实时抓取图书销量、评分、评论等数据,结合协同过滤、内容推荐等算法实现精准推荐。系统采用Java+SpringBoot+MySQL技术栈开发,具备数据处理、智能推荐等功能模块,解决了传统推荐方式缺乏个性化的问题,提高了图书筛选效率。未来将融合多模态数据并加强隐私保护,进一步提升推荐效果。
本文介绍了如何通过浏览器开发者工具逆向分析电商平台“找小店”页面的数据接口,并用Python实现竞品店铺数据的批量抓取。文章详细演示了抓包定位关键请求、分析加密逻辑、解密函数逆向等步骤,最终通过Python复现AES解密算法获取结构化数据。该方法可帮助电商运营者高效进行竞品调研,但强调需遵守法律法规,仅用于学习交流而非商业用途。核心内容包括网络请求分析、JS逆向调试、Python解密实现三部分,为
电商风控体系依赖Canvas和WebGL设备指纹识别违规行为。传统伪装方式已失效,合规运营需通过可控随机化技术重构指纹特征。Canvas指纹通过微调像素矩阵和字体渲染实现动态变化;WebGL指纹采用硬件信息伪装和渲染参数扰动分层处理。双指纹协同随机化需保持功能兼容性,避免异常参数触发风控。该技术适用于多店铺运营、合规数据采集等场景,但须配合正常用户行为使用。通过底层接口劫持和合理参数扰动,可在保留
跨境电商系统
情感分析是自然语言处理的重要应用领域,通过机器学习算法自动识别文本情感倾向。其核心技术包括文本预处理、特征工程和分类模型构建,其中TF-IDF和词向量是特征提取的经典方法。在电商场景中,情感分析能高效处理海量用户评论,准确识别产品优缺点,为运营决策提供数据支持。本文以京东手机评论为例,详细解析了从数据采集、反爬策略到BERT模型调优的全流程实践,特别针对验证码破解、动态加载处理等工程难题提供了解决
提供 ozon, 速卖通, 1688, wb,yandex,samsclub_px3 电商平台逆向代码。
发送请求 → 获取HTML → 解析数据 → 数据清洗 → 保存Excel| | | | |设置UA 响应文本 提取字段 去重转换 格式化输出设置头 编码处理 结构化 空值处理 自动筛选代理池 超时控制 存储列表 类型转换 列宽设置。
值不值得花那个时间,看你的场景。这就是为啥那群搞跨境电商的宁愿每月花几千刀买指纹浏览器(AdsPower/CloakBrowser),也不自己从头写:因为人家投入了 50 多项指纹参数的持续维护,加行为模型的对抗迭代,自己搞,你改完 Canvas 对面更新了 Audio 指纹算法,没完没了。也只是把分从 0.1 提到 0.3,想过 0.7 的门槛,得让整段会话的行为序列都像真人:包括访问路径,不要
阿里云WAF会采集客户端TLS Client Hello中的密码套件、扩展、椭圆曲线、签名算法等,生成JA3指纹。"Arial", "Helvetica", "Times New Roman", "Calibri", "微软雅黑",阿里使用“极验4代”或“无感验证”,基于鼠标移动的贝塞尔曲线、加速度、点击时的微小抖动、设备加速度计数据。items = ["123", "456", "789"]#
开发者只需调用网页采集 API,页面理解、反爬对抗、动态渲染、结构化输出等环节均由平台自动处理,使团队能够将精力集中于数据本身。产品数据关键指标:商品标题、品牌、价格、评分,配置,描述信息等。页面结构复杂:电商页面并非规范的静态 HTML,核心数据(价格、库存、评分等)通常由 JavaScript 动态注入,DOM 结构碎片化且异步加载。为辅助采购决策,技术部门需要采集市场上主流显示器的价格、配置
最近跟几个做爬虫的老朋友聊天,发现一个挺有意思的现象:大家都会调 API,能跑通 RAG Demo,甚至还能自己微调一个小模型,但一谈到“上线”,就卡住了。不是模型不准,不是检索不匹配,而是权限乱了、日志没了、出了问题根本找不到在哪。这已经不是“能不能跑通”的问题,而是“能不能扛住真实流量”的问题。我最近带了一个小团队,把一个电商比价系统从纯爬虫改造成了基于大模型的智能导购 Agent。
以前写爬虫要三天,现在我只负责提需求,代码让AI写。省下来的时间,我把整个项目架构重写了。事情要从上个月说起。团队接了一个新项目,需要从十几个不同来源采集数据——政府公开数据、电商平台商品信息、行业资讯网站……每个来源的页面结构都不一样,有的还是动态渲染的SPA站点。初步估算,至少要写2000-3000行爬虫代码,外加各种反爬应对、数据清洗、异常处理。按以前的工作流,我得花三天时间:第一天梳理各个
答案基本是可以的,selenium适合动态网页抓取,因为它可以控制浏览器去点击、加载网页,requests则比较适合静态网页采集,它非常轻量化速度快,没有浏览器开销,占用资源少。首先这次测试的采集目标是某跨境电商网站的智能手机商品数据,基于Scraping Browser服务,使用Python Selenium库来请求和解析数据,Selenium是主流的浏览器自动化工具,也支持其API接口,操作起
网站结构分析:了解商品列表页、详情页、分类页和搜索页的结构特点请求参数分析:掌握分页、筛选、排序参数的使用方法数据提取:使用正则表达式、BeautifulSoup和JSON解析等方法提取商品数据价格监控:实现商品价格的实时监控和历史价格追踪实战案例:详细演示了淘宝、京东、拼多多三个电商平台的爬虫实现反爬虫绕过:介绍了常见的反爬虫机制和对应的绕过策略数据清洗与去重:使用Pandas对采集的数据进行清
浏览器方案基于Chromium开源项目,封装成独立的桌面应用。Chromium是Google开源的浏览器内核项目,Chrome、Edge、Opera等浏览器都基于它开发。CEF(Chromium Embedded Framework)是将Chromium嵌入桌面应用的成熟框架。目前采用浏览器方案的代表工具之一是火蚁一键存图,它基于Chromium内核开发,将浏览器直接嵌入桌面应用,在稳定性、图片质
本文从零开始,用Python requests库完成电商数据采集全流程,包括环境搭建、网页抓取、数据保存到Excel、反爬技巧及接单变现指南。适合爬虫初学者,学完即可接单赚钱!
这套京东商品爆款潜力研判与货源筛选落地方案,彻底解决了传统选品凭经验、预判滞后、货源不稳、盈利困难的行业痛点。通过多维度数据化研判,精准捕捉平台增长风口,提前锁定高潜力爆款,避开同质化价格战;通过标准化货源筛选体系,筑牢供应链根基,降低售后风险与库存压力,保障单品稳定起量、长效盈利。对于京东各类商家而言,落地这套选品运营方案,能够实现选品标准化、运营精细化、盈利可持续,真正做到低成本、高效率打造店
泛程序在站群系统中发挥三大核心作用:1)批量内容生成,通过预设规则快速产出主题文章,使电商等站群内容更新效率提升超60%;2)智能关键词布局,精准分析并部署热门及长尾关键词,助力旅游类站点搜索排名提高约30%;3)自动化链接建设,统筹内外链构建,增强教育等站群权威性。这些功能显著提升站群运营效率,帮助系统在流量竞争中脱颖而出。建议合理运用泛程序技术以优化站群表现。(148字)
摘要: 本研究针对笔记本电脑市场价格数据量大、波动频繁、分析维度复杂的特点,设计了一套基于Hadoop与网络爬虫的价格数据分析与可视化系统。系统通过Python爬虫自动化采集电商平台多维度笔记本数据,利用Hadoop分布式架构(HDFS+MapReduce)实现海量数据的存储、清洗与深度分析,包括价格区间分布、配置价格关联、品牌定价差异及时序波动等核心维度,并借助交互式可视化技术直观展示分析结果。
八爪鱼则是完全图形化操作的工具,非常的简单,它有大量的爬虫模板,支持数据类型比较丰富,应用场景更多,从网页登陆到批量获取到数据清洗都有一整套的自动化流程,会更加适合大多数人的数据抓取需求,比如IT工程师、自媒体从业者、商铺管理者、商业分析师等等。不管是文本、图片、视频亦或表格,八爪鱼都能抓,而且它还提供了非常丰富的采集模板,比如电商、新闻、短视频等主流平台全包含,它已经帮你配置好了流程,一键可以实
电商ERP的核心价值,本质是打通多平台订单、库存、物流、财务的数据闭环,而订单自动同步是整个系统的入口基石。如果订单同步不稳定、不实时、不准确,会直接引发漏单、重单、超卖、发货错乱、财务对账异常等一系列线上事故。很多中小ERP项目、自研电商系统在落地时,只简单实现了“定时拉取订单”,却缺失了幂等去重、状态机驱动、增量更新、异常补偿、跨平台适配、状态回写等工程能力,导致上线后维护成本极高。本文将从业
摘要: 量化交易中,传统因子拥挤导致Alpha收益衰减,另类数据(如舆情、电商销量、招聘信息等)成为新信息差来源。网络爬虫是获取这类数据的核心工具,需构建稳定、合规的采集体系,并通过因子预处理、有效性检验等步骤转化为交易信号。合规性至关重要,需避免突破反爬机制、干扰网站运行及采集敏感数据。典型策略包括电商销量选股、舆情反转交易等,但需警惕Alpha衰减,结合大模型提升信息挖掘效率,并坚守合规与风控
电商API
反向海淘架构
《电商全平台价格监控系统设计与实践》摘要:面对电商行业多平台价格管理的复杂性,本文深入剖析了一套从零搭建的高效价格监控系统。系统采用五层分布式架构,融合官方API与智能采集技术,突破多平台异构数据整合难题,独创促销规则引擎实现97.2%的到手价计算准确率。通过分级调度策略和四层反爬体系,实现12万+SKU的分钟级监控,告警响应延迟控制在2分钟内。系统上线后运营效率提升90%,618大促期间成功规避
全网比价系统搭建
异构数据源统一聚合:兼容电商开放API、合规轻量化采集两类数据源,抹平各平台字段差异,统一价格统计口径;分级自动化监控:根据商品热度动态调整轮询频率,兼顾数据实时性与平台限流合规要求;价格欺诈识别:基于历史成交价基线校验,过滤平台原价虚标、大促溢价、临时抬价乱象;同款商品精准匹配:基于分词相似度+规格权重算法,规避不同配置商品误匹配比价;行情可视化复盘:结构化存储价格快照,生成走势图表,支撑采购溯