登录社区云,与社区用户共同成长
邀请您加入社区
毕业设计、课程作业或工作汇报里经常要交「数据分析可视化」作业:给一份订单数据,出清洗逻辑 + 图表 + 结论。本资源给出一套的完整工程:从造数据、清洗脏数据到六维图表与分析报告,全部脚本化,改数据源即可换题复用。
<think>我们根据要求生成≤150字的文章摘要。需要浓缩核心内容:电商订单数据清洗测评,用数以轻舟Agent处理3万行订单表,本地处理、脚本留存可复用,清洗效果、适合人群、边界等。字数限制150字以内。我们组织语言。</think>实测数以轻舟Agent清洗3万行电商订单:数据全程本地处理,一句话指令完成去重、补缺、规范化,约十分钟跑完,脚本留存本地可复用。软件一次买断,模型算力需自购;适合不
本文详细介绍电商评论项目的数据处理流程,包括原始字段解析、去重、中文过滤、规则标注、类别分布、时间切分和数据质量检查,强调数据契约和数据质量对模型效果的影响。
前面学了数据处理、可视化库、AI 辅助分析,这篇全部串起来。模拟一份真实电商销售数据,走完从数据加载→清洗→探索→可视化→生成报告的全流程。最终产出一份包含 6 张图表的完整分析报告(HTML 格式),以及一个可复用的自动化脚本。这就是数据可视化的完整闭环。
本文介绍了Pandas中处理日期时间数据的常用方法。首先使用pd.to_datetime()将字符串转换为日期类型,然后通过dt属性提取年、月、日、星期、季度等时间成分,并判断是否为月末/年末。重点讲解了to_period()方法,它支持按年("Y")、月("M")、季度("Q")、周("W")、日("D")等不同周期进行时间统计。示例代码演示了如何创建一个包含交易日期和GMV的数据框,并进行各种
本教程介绍如何利用智谱GLM-4.7-Flash AI模型辅助电商数据分析。通过Python的pandas处理数据后,将统计摘要输入AI模型,自动生成数据洞察。文章演示了从数据概览、分类统计到相关性分析的全流程,AI能够发现高客单价与高退货率的矛盾、不同渠道和用户等级的销售差异等关键问题。该方法无需复杂编码,以对话方式获取专业分析建议,大幅提升数据分析效率,特别适合非技术背景的运营人员快速掌握数据
数据分析作为从海量信息中提取价值的关键技术,其核心在于将原始数据转化为可指导决策的洞察。这一过程遵循从业务理解、数据清洗、分析挖掘到可视化呈现的标准工作流,其中数据清洗与特征工程是确保分析质量的基础环节。在技术实现上,Python的pandas库提供了高效的数据操作能力,而Jupyter Notebook则成为交互式分析与结果展示的理想环境。数据分析的价值在于解决实际问题,例如通过RFM模型对用户
电商数据分析是商业智能的核心应用场景,通过Python技术栈可以实现从数据清洗到商业洞察的全流程分析。pandas作为数据处理利器,配合mlxtend等库能高效完成销售趋势分析、商品关联规则挖掘等典型任务。RFM用户分层模型和地理热力图等高级分析方法,为电商运营提供可视化决策支持。针对大型数据集,合理使用数据类型转换和分块处理技术可有效解决内存瓶颈。本案例完整展示了电商数据分析的技术实现路径,涵盖
数据分析作为商业智能的核心技术,通过挖掘数据价值帮助企业优化决策。其核心流程包括数据清洗、特征工程和建模分析,其中pandas等Python工具链已成为行业标准。在电商领域,RFM用户分群和购物篮分析等算法能有效识别高价值客户与商品关联规则,直接提升营销转化率。本文以中型电商平台真实数据为例,演示如何用Python处理订单、用户、商品等多维数据,涵盖缺失值处理、销售趋势可视化等实战场景,特别针对双
数据分析作为商业智能的核心技术,通过统计学方法和机器学习算法从海量数据中提取有价值信息。其技术原理涉及数据清洗、特征工程和模式识别等关键环节,在电商领域能有效提升运营效率和用户转化率。以Python技术栈为例,pandas进行数据预处理,matplotlib实现可视化分析,结合RFM用户分群和关联规则挖掘等算法,可构建完整的销售分析解决方案。典型应用场景包括销售趋势预测、用户行为分析和商品推荐系统
数据分析作为数据科学的核心环节,其技术栈构建需要从基础工具链开始。Python凭借NumPy、pandas等科学计算库形成的完整生态,已成为数据分析领域的主流选择。其向量化计算和内存优化机制,相比传统数据处理方式可提升10-100倍效率,特别适合电商日志、用户行为等大规模数据集处理。在工程实践中,Anaconda环境配合VSCode工具链能快速搭建分析平台,而pandas的分组聚合、类型优化等技巧
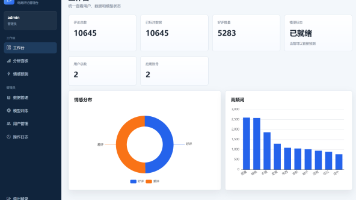
本文介绍了一个基于Flask框架的电商评论情感分析可视化系统的完整实现。该系统采用TF-IDF算法提取文本特征,对比训练了逻辑回归、支持向量机、朴素贝叶斯和随机森林四种机器学习模型,通过四维评估指标自动选择最优模型,在10,645条真实电商评论数据上达到了88%-92%的分类准确率。系统采用B/S三层架构,包含用户认证、数据管理、模型训练、情感预测和可视化分析五大功能模块,支持单条/批量预测和词云
从这篇开始正式画图。`Matplotlib` 是 Python 可视化的一切基础,后面的 `Seaborn`、`Pyecharts` 都是在它之上封装的。本篇用同一份电商销售数据,分别画出四种最常用的基础图表:折线图看趋势、柱状图看对比、饼图看占比、散点图看关系。每种图都给出完整代码和适用场景说明,拿来就能用。
画图的原料是数据,而现实中的数据从来不会整整齐齐等你来画。本篇用一份电商销售数据,手把手带你用 pandas 完成数据读取(CSV/Excel)、字段筛选、条件过滤、分组统计、数据排序和数据变形。每个操作都有真实代码和运行结果。掌握这些,80% 的可视化前准备工作就解决了。
这个案例覆盖了数据清洗、多维度分析、RFM 模型、可视化报告——一条完整的数据分析链路。先看全貌 → 拆维度 → 找规律 → 出结论。下一篇是最后一个实战——分析招聘数据,用 Python 看看什么岗位最有"钱"途。
Pandas GroupBy 全面解析:从基础到实战 摘要:本文深入剖析Pandas中GroupBy的核心机制与应用技巧。GroupBy通过Split-Apply-Combine范式实现数据分组聚合,支持多种分组键形式(列名、函数、多层索引等)和聚合方法(内置函数、自定义函数、命名聚合)。文章详细讲解了transform(组内标准化/填充)和filter(组筛选)的用法,并提供了电商用户分析、金融
2026年,全球每分钟产生的网络数据超过4.7亿GB,但其中高达73%的数据存在不同程度的缺失、异常或结构不一致问题(DataQualityReport 2026)。我见过太多爬虫工程师沉迷于反爬对抗和请求速率优化,却在数据落地的最后一公里折戟沉沙——数据库里躺着几亿条记录,但分析团队根本不敢用,因为NaNNone、空字符串和乱码像地雷一样遍布每个字段。这不是一篇普通的Pandas教程。我将以真实
用户购物习惯:单次下单仅采购单一品类商品,无跨品类共购样本;单品维度过于分散,直接单品建模维度高达 1906 个,几乎无共购组合。改用品类聚合建模,降低矩阵维度;绘图代码增加模拟数据兜底,保证可视化效果展示;增加订单品类数量诊断代码,快速定位无规则根源。运营上线品类捆绑套餐、满减活动,引导用户一单多品类购买;商品详情页配置搭配推荐,提升跨品类共购订单量;积累混合品类订单后,重新执行购物篮分析。
文章摘要 本文介绍了Pandas在电商数据处理中的应用,主要内容包括: Pandas核心功能:解决百万级数据处理、复杂数据清洗和灵活数据聚合问题 安装与准备:详细说明Pandas安装步骤和模拟电商数据生成方法 数据结构:讲解DataFrame和Series两种核心数据结构 数据读取:介绍CSV/Excel文件读取及多文件合并技巧 数据概览:通过head()、shape、info()等方法快速了解数
技术动作业务含义工具groupby('客户名称').fillna()“同一客户的信息应一致”pandasgroupby“这个客户编码不统一,请业务确认”pandasnuniqueIQR异常检测“这笔订单金额偏离常态,需风控复核”pandas 数值计算“每个订单必须且只能关联一个客户”pandasmerge参数🌟终极口诀“空值不是缺陷,是业务未覆盖的盲区;异常不是错误,是系统在发出预警信号;清洗不
电商订单数据清洗是数据分析的关键步骤,本文介绍了常见脏数据处理方法:1)缺失值处理:识别并填充/删除缺失值;2)重复值处理:基于订单号去重;3)异常值处理:识别负值/超大金额订单;4)数据类型转换:规范日期、金额等格式。实操提示包括备份原始数据、根据业务逻辑填充缺失值、谨慎处理异常值等。通过生成模拟脏数据文件(dirty_orders.csv),演示了完整的清洗流程,帮助电商数据分析师提升数据质量
模块化设计:将系统拆分为数据采集、数据处理、数据展示等独立模块,便于团队协作和后期维护。代码规范:坚持使用PEP8规范,配置pre-commit钩子进行代码检查,保证代码质量。自动化部署:使用Docker容器化部署,GitLab CI/CD实现自动化测试和部署。这个Python项目不仅实现了业务需求,更重要的是为团队积累了宝贵的开发经验。通过项目复盘,我们既肯定了成功经验,也识别了改进空间,为后续
本文介绍了Pandas数据分析的五大核心功能:1)loc/iloc数据筛选;2)groupby分组聚合;3)pivot/pivot_table透视表转换;4)merge表连接;5)datetime时间处理。通过电商日志分析案例,演示了如何实现用户行为分析、转化漏斗计算和日级指标统计。文章重点讲解了各功能的实际应用场景和代码实现,并提供了与SQL操作的类比,帮助读者快速掌握Pandas核心数据分析技
数据清洗是数据分析的关键步骤,电商行为日志等大规模数据常存在缺失值、重复记录、类型错误等问题。本文以Pandas工具为例,系统介绍了电商日志的清洗流程:包括缺失值识别与分层处理(如删除无效订单、标记缺失商品)、基于业务规则的去重(事件ID或时间窗口去重)、数据类型校正(数值、时间、类别字段处理)、文本标准化(统一格式与映射枚举值)以及异常值检测(统计法和业务规则)。最后建议将清洗流程函数化,形成可