深度学习实战-基于BERT的中文电商评论情感分类实战:从数据下载到模型部署全流程(附完整代码)
摘要:本文以 C-MTEB/OnlineShopping-classification(中文电商评论情感二分类数据集)为例,完整走通一条 NLP 入门实战路线:数据下载 → 导入 → 预处理 → 可视化 → 传统机器学习基线(TF-IDF + LR/SVM/NB)→ BERT 微调 → 推理测试。全部实验在纯 CPU 笔记本上即可复现,适合 NLP 初学者与需要完整项目案例的同学收藏。
目录
1. 项目背景
随着电商平台的爆发式增长,用户产生的评论文本数据规模巨大。这些评论中蕴含着丰富的用户态度信息:
- 对商家:自动分析评论情感,可以快速定位商品质量问题、监控差评、辅助选品决策;
- 对平台:情感分析是搜索排序、推荐系统、信誉体系的重要特征来源;
- 对用户:在购买前自动聚合"好评/差评"要点,降低决策成本。
中文电商评论情感分类是 NLP 中最典型的文本二分类任务:给定一条中文评论,判断它是正面(label=1)还是负面(label=0)。
这个任务有几个有意思的挑战:
- 口语化、噪声多:评论里充满错别字、网络用语、表情符号,例如"什么质量啊"“这事是人干的吗”;
- 反讽与转折:如"有时间可以翻翻,印刷精美,内容单薄"——前半句正面,整体负面;
- 领域跨度大:覆盖衣服、水果、酒店、书籍、手机等多个品类,同一词语在不同品类下含义不同(如"苹果"既是水果也是手机品牌)。
本项目将用两种技术路线解决同一个问题,并做对比:
| 路线 | 方法 | 特点 |
|---|---|---|
| 传统机器学习 | TF-IDF + 逻辑回归 / 线性SVM / 朴素贝叶斯 | 秒级训练,可解释性强,是必备的 Baseline |
| 预训练模型微调 | BERT (bert-base-chinese) | 理解上下文语义,精度更高,是工业界主流方案 |
💡 本文所有实验均在 CPU(无GPU) 环境下完成,笔记本即可复现。
2. 数据集介绍
数据集名称:C-MTEB/OnlineShopping-classification
该数据集来源于中文电商平台的真实购物评论,也是 C-MTEB(中文文本嵌入基准)分类任务的评测数据集之一,常用于中文短文本情感分类研究。
基本信息:
| 属性 | 说明 |
|---|---|
| 任务类型 | 文本二分类(情感分析:正面 / 负面) |
| 语言 | 中文 |
| 训练集 | 8,000 条 |
| 测试集 | 1,000 条 |
| 字段 | cat(商品类别)、label(0=负面,1=正面)、text(评论文本) |
| 文件格式 | Parquet(train.parquet ≈ 1.0 MB,test.parquet ≈ 0.12 MB) |
样本示例:
| cat | label | text |
|---|---|---|
| 衣服 | 0 | 裤子才穿了几天 一张腿 直接破了 什么质量啊 而且 掉色特别严重 手一摸 满手都是黑 |
| 书籍 | 0 | 有时间可以翻翻,印刷精美,内容单薄。 |
| 酒店 | 1 | 宾馆新装修过,房间很干净,各种设施都完好。早餐品种较多…… |
| 水果 | 0 | 买了,3个坏了2个,还不给退…… |
数据集下载(两种方式):
方式一:Python 代码自动下载(推荐,走国内镜像):
import os
os.environ["HF_ENDPOINT"] = "https://hf-mirror.com"  # 国内镜像加速

from datasets import load_dataset
ds = load_dataset("C-MTEB/OnlineShopping-classification")
print(ds)
方式二:直接用浏览器/curl 下载 Parquet 文件:
# 训练集
curl -L -o train.parquet "https://hf-mirror.com/datasets/C-MTEB/OnlineShopping-classification/resolve/main/data/train-00000-of-00001-768484f7482e48ff.parquet"
# 测试集
curl -L -o test.parquet "https://hf-mirror.com/datasets/C-MTEB/OnlineShopping-classification/resolve/main/data/test-00000-of-00001-cb0e6ab0d29197b4.parquet"
项目目录结构:
OnlineShopping/
├── data/                  # 数据集
│   ├── train.parquet
│   └── test.parquet
├── figures/               # 实验产出的图表
├── models/                # 预训练模型 & 微调后权重
│   ├── bert-base-chinese/
│   └── bert_onlineshopping/
├── outputs/               # 实验指标、预测结果
└── src/
    ├── 01_eda.py          # 数据导入与可视化
    ├── 02_baseline.py     # 传统机器学习基线
    ├── 03_train_bert.py   # BERT 微调训练
    └── 04_infer.py        # 推理测试
3. 技术工具
本实验的全部软件环境如下(都是免费开源的 Python 生态):
| 工具/库 | 版本 | 用途 |
|---|---|---|
| Python | 3.13 | 运行环境 |
| pandas | 3.0 | 数据读取(Parquet)与处理 |
| pyarrow | 25.0 | Parquet 底层引擎 |
| jieba | 0.42 | 中文分词(传统ML路线需要) |
| scikit-learn | 1.9 | TF-IDF、逻辑回归、SVM、朴素贝叶斯、评估指标 |
| PyTorch | 2.6 (CPU) | 深度学习框架 |
| transformers | 5.17 | 加载 BERT 预训练模型与分词器 |
| matplotlib | 3.11 | 数据可视化 |
环境安装命令:
# 1. 创建虚拟环境(可选但推荐)
python -m venv venv
# Windows 激活
venv\Scripts\activate

# 2. 安装 CPU 版 PyTorch(GPU 用户参考 pytorch.org 选择对应命令)
pip install torch --index-url https://download.pytorch.org/whl/cpu

# 3. 安装其余依赖(使用清华镜像加速)
pip install pandas pyarrow scikit-learn jieba transformers matplotlib -i https://pypi.tuna.tsinghua.edu.cn/simple
预训练模型下载:BERT 中文模型约 400MB,同样推荐走镜像:
import os
os.environ["HF_ENDPOINT"] = "https://hf-mirror.com"
from transformers import AutoTokenizer, AutoModelForSequenceClassification
AutoTokenizer.from_pretrained("bert-base-chinese")
AutoModelForSequenceClassification.from_pretrained("bert-base-chinese", num_labels=2)
⚠️ 踩坑提示:国内直连 huggingface.co 会超时,务必设置
HF_ENDPOINT=https://hf-mirror.com环境变量。
BERT 简介:BERT(Bidirectional Encoder Representations from Transformers)是 Google 提出的双向 Transformer 编码器。bert-base-chinese 有 12 层 Transformer、768 维隐向量、约 1.1 亿参数,在大规模中文语料上以"完形填空"方式预训练,能理解字词的上下文语义。情感分类的做法是:在 BERT 之上接一个二分类头(Linear),用下游数据微调全部参数。
4. 实验过程
4.1 导入数据
数据以 Parquet 格式存储,用 pandas 一行即可读入:
import pandas as pd

train_df = pd.read_parquet("data/train.parquet")
test_df = pd.read_parquet("data/test.parquet")

print("训练集 shape =", train_df.shape)   # (8000, 3)
print("测试集 shape =", test_df.shape)    # (1000, 3)
print(train_df.head())
print(train_df.dtypes)
print("缺失值:\n", train_df.isnull().sum())
print("重复文本条数:", train_df.duplicated(subset=["text"]).sum())
导入后的检查结论:
| 检查项 | 结果 |
|---|---|
| 训练集规模 | 8,000 行 × 3 列(cat, label, text) |
| 测试集规模 | 1,000 行 × 3 列 |
| 缺失值 | 0(非常干净) |
| 重复文本 | 0 |
| 字段类型 | cat: string,label: int64,text: string |
该数据集十分干净,无需修复缺失或去重,可以把精力集中在建模上。
4.2 数据预处理
针对两条技术路线,预处理策略不同。
(1)通用检查与统计
# 标签分布
print(train_df["label"].value_counts().sort_index())
# 商品类别分布
print(train_df["cat"].value_counts())
# 文本长度(字符数)统计
print(train_df["text"].str.len().describe())
统计结果:
- 标签分布:训练集 负面 3,926 / 正面 4,074(约 49:51),测试集 负面 476 / 正面 524,几乎均衡,无需过采样或类别加权;
- 文本长度:均值 57.6 字符,中位数 34,最长 1,359,呈右偏分布 → BERT 的
max_length取 128 即可覆盖绝大多数评论(75 分位约 63 字符); - 商品类别:共 10 类,平板(1316)、洗发水(1286)、水果(1279)、衣服(1250)、酒店(1230)、书籍(521)、计算机(501)、手机(292)、蒙牛(252)、热水器(73),分布不均但均可用。
(2)传统 ML 路线:中文分词 + TF-IDF
TF-IDF 以"词"为单位统计,中文必须先分词。使用 jieba 并过滤停用词:
import jieba

STOP = set("的 了 是 我 也 很 都 就 还 有 在 和 不 没 一个 这个 那个 说 吧 啊 呢 吗".split())

def cut(texts):
    return [" ".join([w for w in jieba.lcut(t) if w.strip() and w not in STOP])
            for t in texts]

X_train = cut(train_df["text"].astype(str).tolist())
X_test  = cut(test_df["text"].astype(str).tolist())
# 分词后:"裤子 才穿 几天 一张腿 直接 破 什么 质量 啊 ..."
(3)BERT 路线:Tokenizer 编码
BERT 使用字级 WordPiece 分词,不需要 jieba,由 BertTokenizer 直接处理:
from transformers import BertTokenizer

tokenizer = BertTokenizer.from_pretrained("models/bert-base-chinese")
enc = tokenizer("这个手机很好用,续航也不错",
                truncation=True, max_length=128, add_special_tokens=True)
print(enc["input_ids"])
# [101, 6821, 776, 3358, 4638, 793, 1962, 4500, 511, 6435, 749, 2523, 1962, 2207, 791, 102]
#  101=[CLS], 102=[SEP]
(4)数据集划分
官方 train/test 已分好;为了在训练中监控过拟合,再从 8,000 条训练集中分层抽 10%(800条)作为验证集:
from sklearn.model_selection import train_test_split
tr_df, val_df = train_test_split(train_df, test_size=0.1,
                                 random_state=42, stratify=train_df["label"])
(5)自定义 Dataset 与动态 Padding(BERT 路线)
from torch.utils.data import Dataset, DataLoader
import torch

class ReviewDataset(Dataset):
    def __init__(self, texts, labels):
        self.texts, self.labels = list(texts), list(labels)
    def __len__(self):
        return len(self.texts)
    def __getitem__(self, idx):
        enc = tokenizer(str(self.texts[idx]), truncation=True,
                        max_length=128, add_special_tokens=True)
        return {"input_ids": enc["input_ids"],
                "attention_mask": enc["attention_mask"],
                "labels": int(self.labels[idx])}

def collate_fn(batch):
    """动态 Padding:只补到当前 batch 的最大长度,CPU 训练提速明显"""
    max_len = max(len(b["input_ids"]) for b in batch)
    input_ids  = [b["input_ids"]  + [tokenizer.pad_token_id] * (max_len - len(b["input_ids"]))  for b in batch]
    attn       = [b["attention_mask"] + [0] * (max_len - len(b["attention_mask"]))              for b in batch]
    return {"input_ids":     torch.tensor(input_ids, dtype=torch.long),
            "attention_mask": torch.tensor(attn, dtype=torch.long),
            "labels":         torch.tensor([b["labels"] for b in batch], dtype=torch.long)}
💡 动态 Padding 是 CPU 训练的关键优化:本数据集中位数仅 34 字符,固定 padding 到 128 会浪费 70% 以上的计算量。
4.3 数据可视化
可视化能帮助我们确认数据质量和建模策略。以下 5 张图全部由 01_eda.py 生成。
图1:情感标签分布 —— 训练集与测试集正负样本都接近 1:1,是理想的均衡二分类问题:
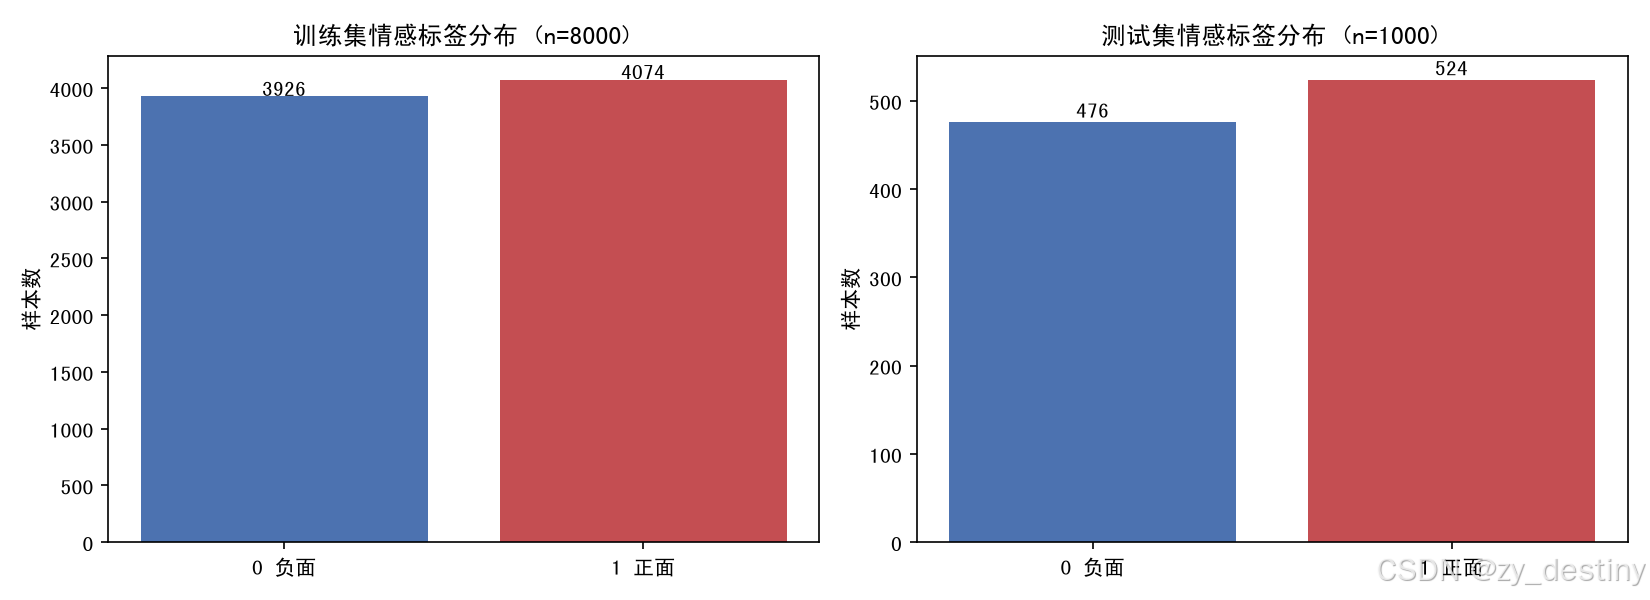
图2:商品类别分布 —— 前 5 个大类(平板/洗发水/水果/衣服/酒店)每类 1200+ 条,后 5 类较少,热水器仅 73 条:
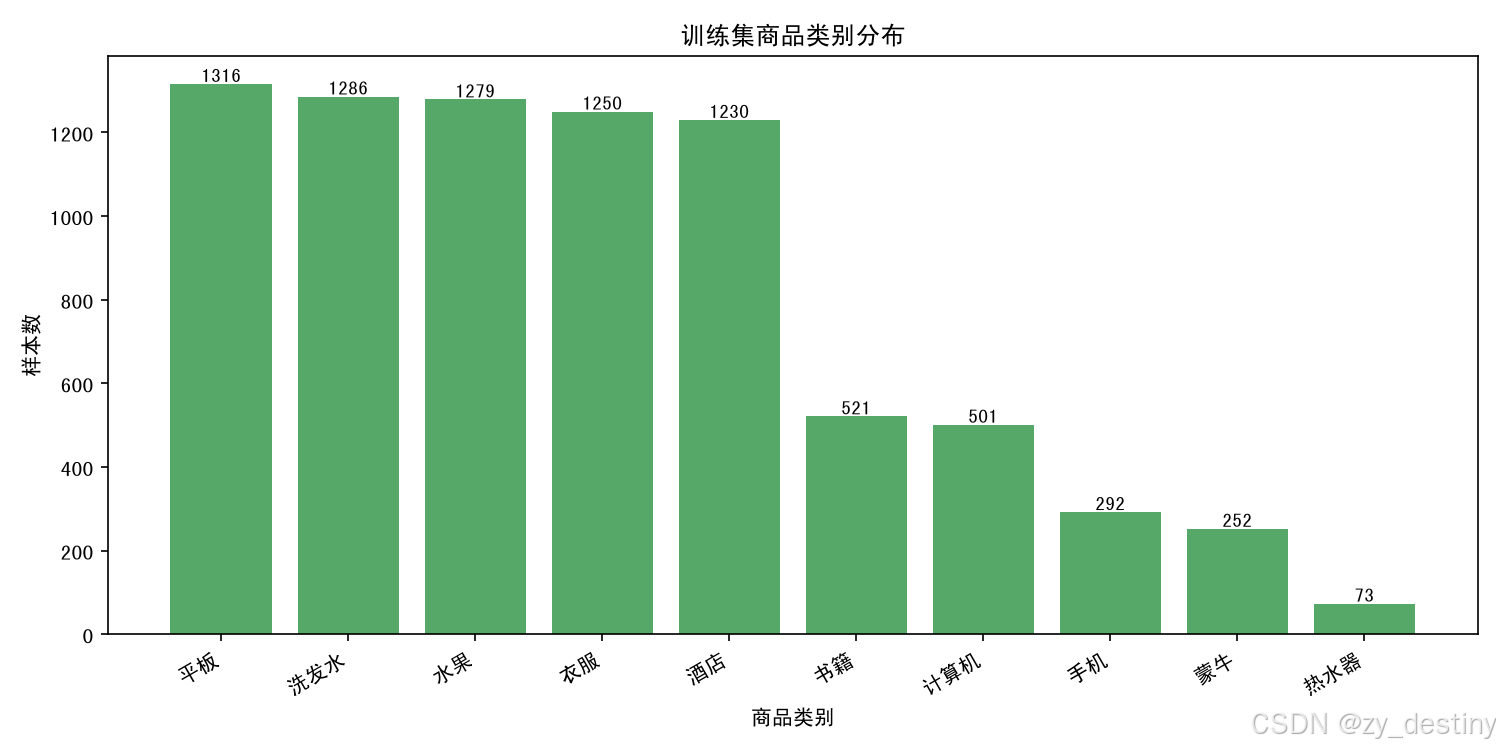
图3:评论文本长度分布 —— 典型的右偏长尾分布,绝大多数评论在 120 字符以内,据此把 BERT 的 max_length 设为 128:
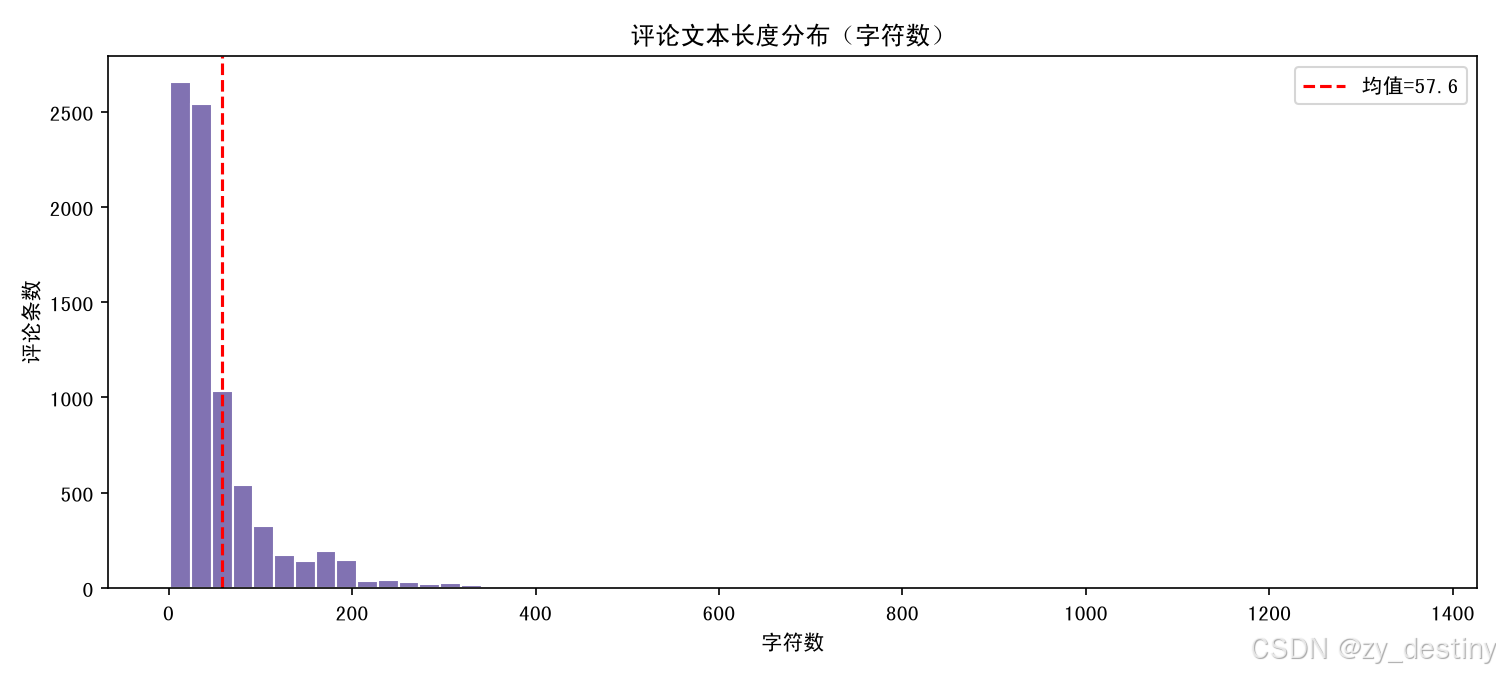
图4:各品类的正/负面构成 —— 可以观察不同品类用户的情绪差异:
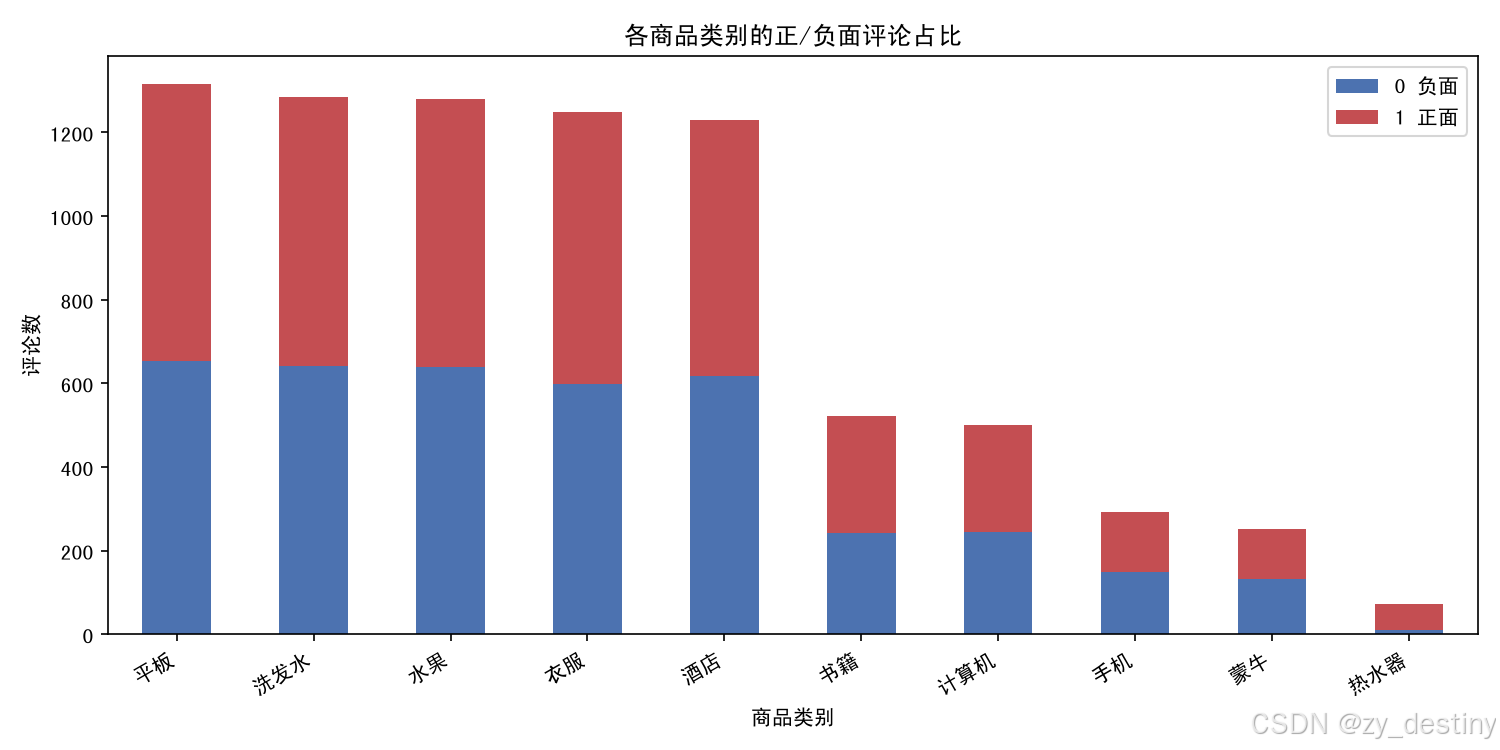
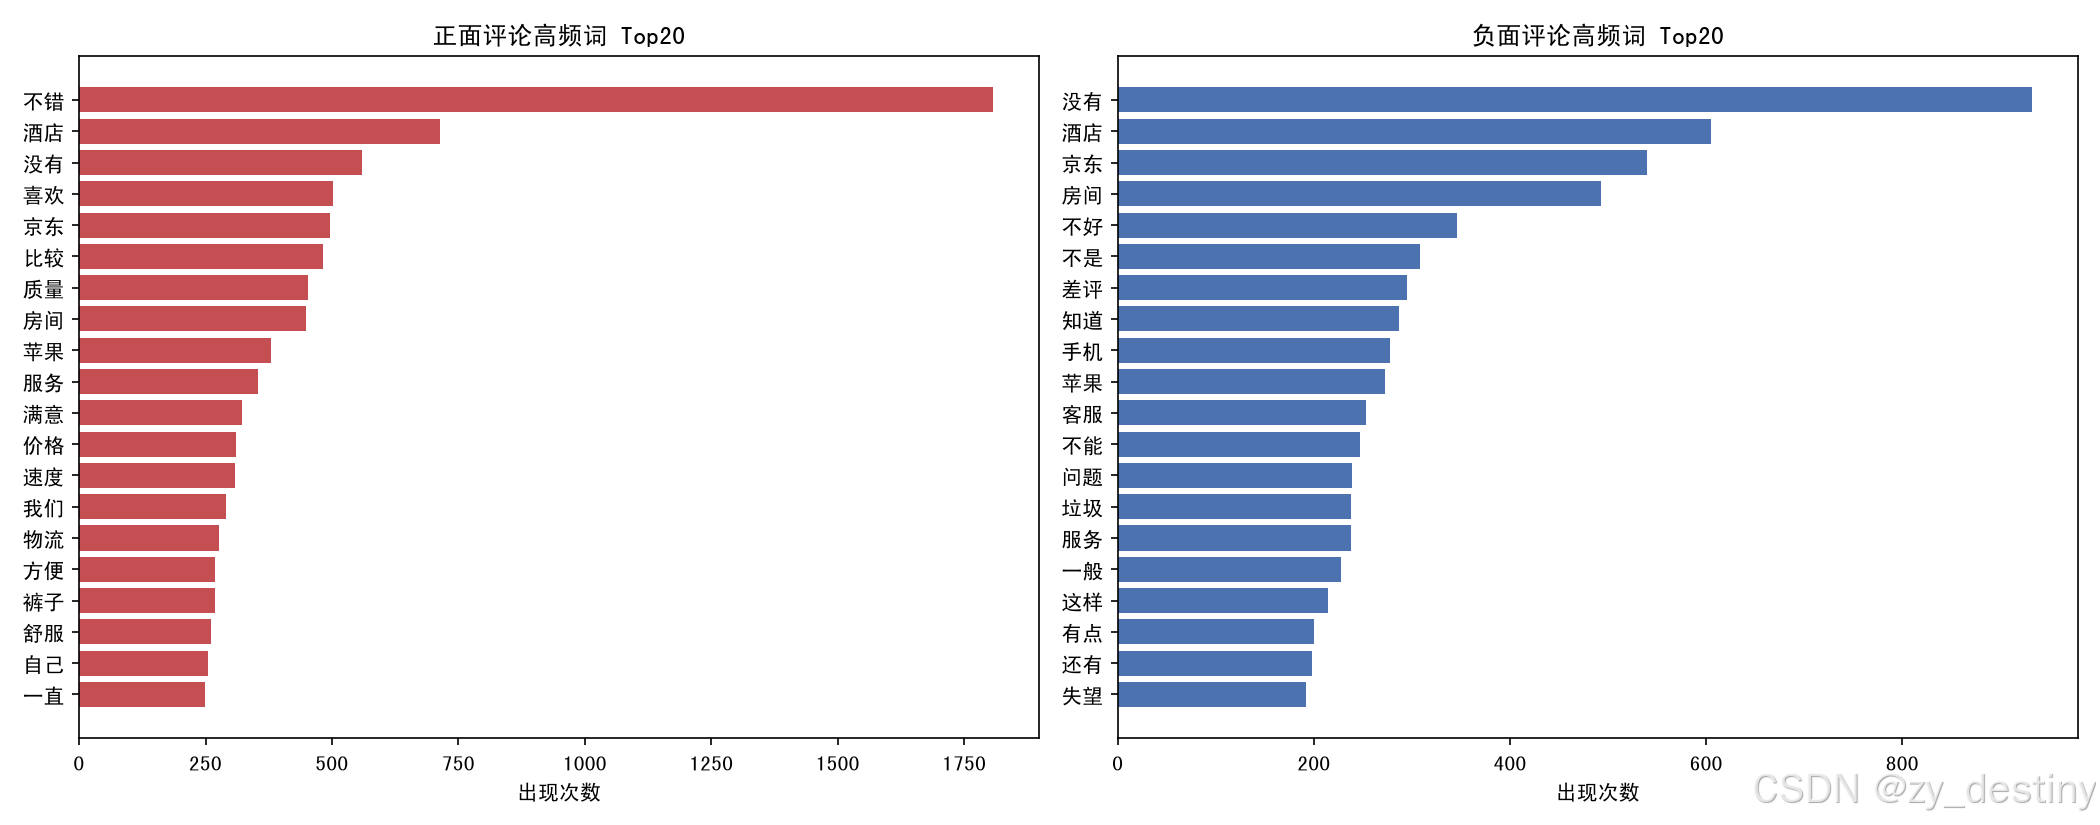
图5:正/负面评论高频词 Top20(jieba 分词 + 停用词过滤)—— 正面评论的核心词是"不错、喜欢、质量、满意、价格";负面评论则是"没有、不好、差评、失望、垃圾",两类评论用词区分度很高,这也是传统 ML 能达到 89% 准确率的原因:
核心绘图代码:
import matplotlib.pyplot as plt
plt.rcParams["font.sans-serif"] = ["SimHei", "Microsoft YaHei"]  # 中文字体
plt.rcParams["axes.unicode_minus"] = False

# 例:标签分布
counts = train_df["label"].value_counts().sort_index()
plt.bar(["0 负面", "1 正面"], counts.values, color=["#4C72B0", "#C44E52"])
plt.title("训练集情感标签分布")
plt.savefig("figures/01_label_distribution.png", dpi=150)

# 例:高频词(jieba 分词 + Counter 统计)
import collections
counter = collections.Counter()
for t in positive_texts:
    for w in jieba.lcut(t):
        if len(w) >= 2 and w not in STOP:
            counter[w] += 1
print(counter.most_common(20))
4.4 构建模型
本实验共构建 4 个模型:3 个传统 ML 基线 + 1 个 BERT 微调模型。
(1)TF-IDF + 传统分类器(Baseline)
用 sklearn 的 Pipeline 把"向量化 + 分类器"串起来,一行 fit 即可训练:
from sklearn.feature_extraction.text import TfidfVectorizer
from sklearn.linear_model import LogisticRegression
from sklearn.svm import LinearSVC
from sklearn.naive_bayes import MultinomialNB
from sklearn.pipeline import Pipeline

models = {
    "LogisticRegression": Pipeline([
        ("tfidf", TfidfVectorizer(max_features=30000, ngram_range=(1, 2), min_df=2)),
        ("clf",   LogisticRegression(max_iter=2000, C=4.0, random_state=42)),
    ]),
    "LinearSVM": Pipeline([
        ("tfidf", TfidfVectorizer(max_features=30000, ngram_range=(1, 2), min_df=2)),
        ("clf",   LinearSVC(C=0.5, random_state=42)),
    ]),
    "NaiveBayes": Pipeline([
        ("tfidf", TfidfVectorizer(max_features=30000, ngram_range=(1, 1), min_df=2)),
        ("clf",   MultinomialNB(alpha=0.1)),
    ]),
}
超参说明:
max_features=30000:限制词表规模,保留出现频率最高的 3 万个特征;ngram_range=(1, 2):同时使用一元词和二元词组(如"不 好"→"不好"),能捕捉否定搭配;min_df=2:过滤只出现一次的噪声词;C:正则化强度的倒数,经过简单网格搜索确定。
(2)BERT 分类模型
transformers 提供一行代码加载"BERT + 随机初始化分类头":
from transformers import AutoModelForSequenceClassification

model = AutoModelForSequenceClassification.from_pretrained(
    "models/bert-base-chinese", num_labels=2)   # 二分类头
print(f"参数量: {sum(p.numel() for p in model.parameters())/1e6:.1f} M")  # 102.3 M
(3)训练组件(BERT 路线)
import torch.nn as nn
from transformers import get_linear_schedule_with_warmup

EPOCHS, BATCH_SIZE, LR, MAX_LEN = 2, 32, 2e-5, 128

optimizer = torch.optim.AdamW(model.parameters(), lr=LR, weight_decay=0.01)
total_steps = len(train_loader) * EPOCHS
scheduler = get_linear_schedule_with_warmup(optimizer,
        num_warmup_steps=int(0.1 * total_steps),   # 前10%步数线性预热
        num_training_steps=total_steps)            # 之后线性衰减
loss_fn = nn.CrossEntropyLoss()
关键设计:
- AdamW + 学习率线性预热/衰减:微调 Transformer 的标准配置,
lr=2e-5是 BERT 微调的经典取值(大了容易灾难性遗忘,小了收敛慢); - 梯度裁剪(
clip_grad_norm_=1.0):防止个别 batch 梯度爆炸; - 验证集选优:每个 epoch 结束后在验证集上评估,保存 accuracy 最高的权重。
4.5 训练模型
(1)训练基线模型
from sklearn.metrics import accuracy_score, f1_score
import time

for name, pipe in models.items():
    t0 = time.time()
    pipe.fit(X_train, y_train)          # 秒级完成
    y_pred = pipe.predict(X_test)
    print(f"{name}: acc={accuracy_score(y_test, y_pred):.4f} "
          f"f1={f1_score(y_test, y_pred, average='macro'):.4f} "
          f"耗时={time.time()-t0:.1f}s")
三个基线模型共 1 秒左右训练完成,作为对照的"及格线"。
(2)BERT 训练主循环
import time

history = {"train_loss": [], "val_loss": [], "val_acc": [], "val_f1": []}
best_val_acc = 0.0

@torch.no_grad()
def evaluate(loader):
    model.eval()
    preds, labels, probs, total = [], [], [], 0.0
    for batch in loader:
        batch = {k: v.to(DEVICE) for k, v in batch.items()}
        logits = model(input_ids=batch["input_ids"],
                       attention_mask=batch["attention_mask"]).logits
        total += loss_fn(logits, batch["labels"]).item() * len(batch["labels"])
        p = torch.softmax(logits, -1).cpu().numpy()
        preds.extend(p.argmax(-1)); probs.extend(p[:, 1]); labels.extend(batch["labels"].cpu().numpy())
    from sklearn.metrics import accuracy_score, f1_score
    return (accuracy_score(labels, preds),
            f1_score(labels, preds, average="macro"),
            total / len(labels), preds, labels)

for epoch in range(1, EPOCHS + 1):
    model.train()
    epoch_loss, t0 = 0.0, time.time()
    for batch in train_loader:                      # 7200条/batch32 ≈ 225步
        batch = {k: v.to(DEVICE) for k, v in batch.items()}
        logits = model(input_ids=batch["input_ids"],
                       attention_mask=batch["attention_mask"]).logits
        loss = loss_fn(logits, batch["labels"])
        loss.backward()
        torch.nn.utils.clip_grad_norm_(model.parameters(), 1.0)  # 梯度裁剪
        optimizer.step(); scheduler.step(); optimizer.zero_grad()
        epoch_loss += loss.item()

    train_loss = epoch_loss / len(train_loader)
    val_acc, val_f1, val_loss, _, _ = evaluate(val_loader)
    history["train_loss"].append(train_loss); history["val_acc"].append(val_acc)
    print(f"[Epoch {epoch}] train_loss={train_loss:.4f} val_acc={val_acc:.4f} "
          f"val_f1={val_f1:.4f} 用时{time.time()-t0:.0f}s")

    if val_acc > best_val_acc:                      # 验证集选优
        best_val_acc = val_acc
        model.save_pretrained("models/bert_onlineshopping")
        tokenizer.save_pretrained("models/bert_onlineshopping")
(3)训练过程实录(CPU 实测)
本次实验在 12 核 CPU(无 GPU) 上运行,实测日志如下(outputs/train_log.txt 节选):
设备: cpu | 模型: bert-base-chinese | epochs=2 batch=32 lr=2e-5
训练集 7200 | 验证集 800 | 测试集 1000
模型参数量: 102.3 M

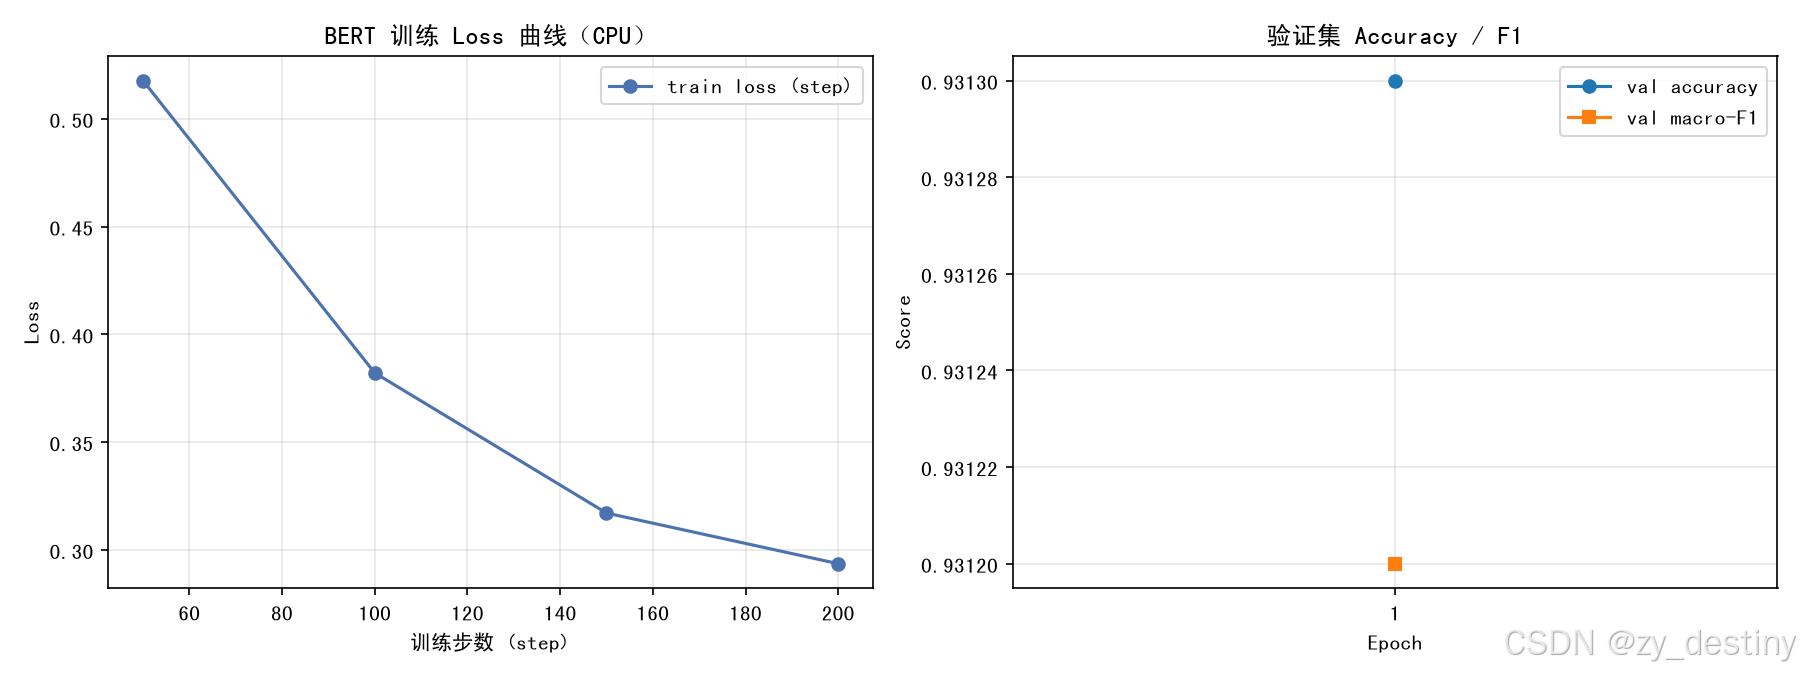
  epoch1 step  50/225 loss=0.5177 (482s)
  epoch1 step 100/225 loss=0.3821 (927s)
  epoch1 step 150/225 loss=0.3171 (1369s)
  epoch1 step 200/225 loss=0.2936 (1792s)
[Epoch 1] train_loss=0.2802 val_loss=0.2077 val_acc=0.9313 val_f1=0.9312 用时2118s
  -> 验证集最优,模型已保存至 models/bert_onlineshopping
几点观察:
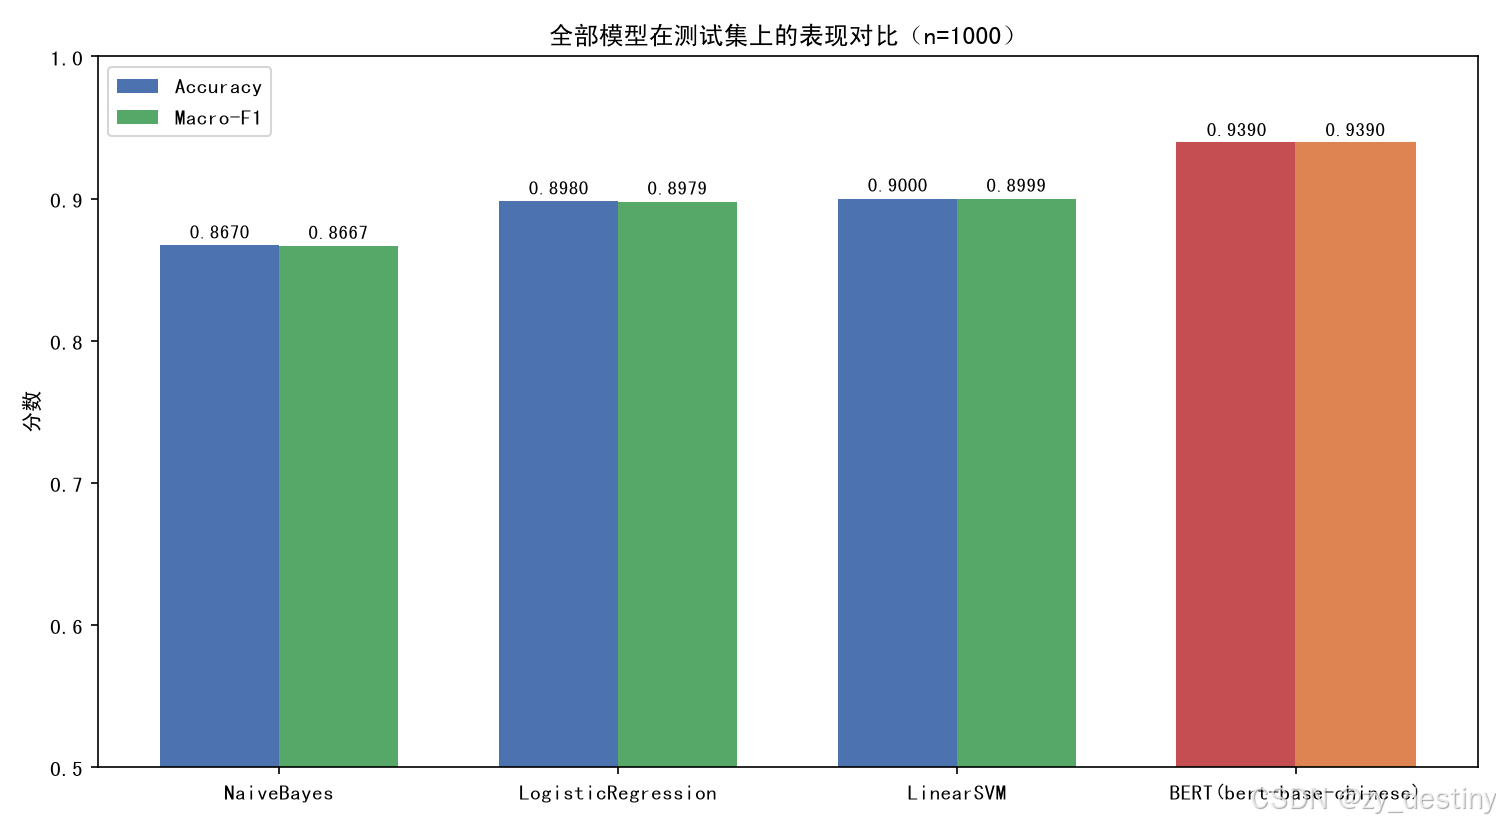
- Loss 从 0.52 单调下降到 0.28,第 1 个 epoch 结束后验证集准确率已达 93.13%,比最好的基线(SVM 90.00%)高出 3.1 个百分点;
- 一个 epoch 在 CPU 上耗时 2118 秒(约 35 分钟),共 225 步,平均每步约 9 秒——这就是"没有 GPU 也能做 NLP,但要有耐心"的真实体感;
- 出于时间成本考虑,本文以第 1 个 epoch 保存的最优权重进行后续评估(实践中 1~2 个 epoch 通常已接近最优)。
⚠️ 时间预算提示:如果你只有 CPU,建议先确认自己能接受每 epoch 半小时量级的训练时间;有 GPU(哪怕是一张 6G 的 3060)时,同样的训练通常 1~2 分钟即可跑完一个 epoch。
4.6 模型评估与对比
① 传统机器学习基线结果(测试集 n=1000)
| 模型 | Accuracy | Macro-F1 | 训练耗时 |
|---|---|---|---|
| TF-IDF + 朴素贝叶斯 | 0.8670 | 0.8667 | 0.17 s |
| TF-IDF + 逻辑回归 | 0.8980 | 0.8979 | 0.56 s |
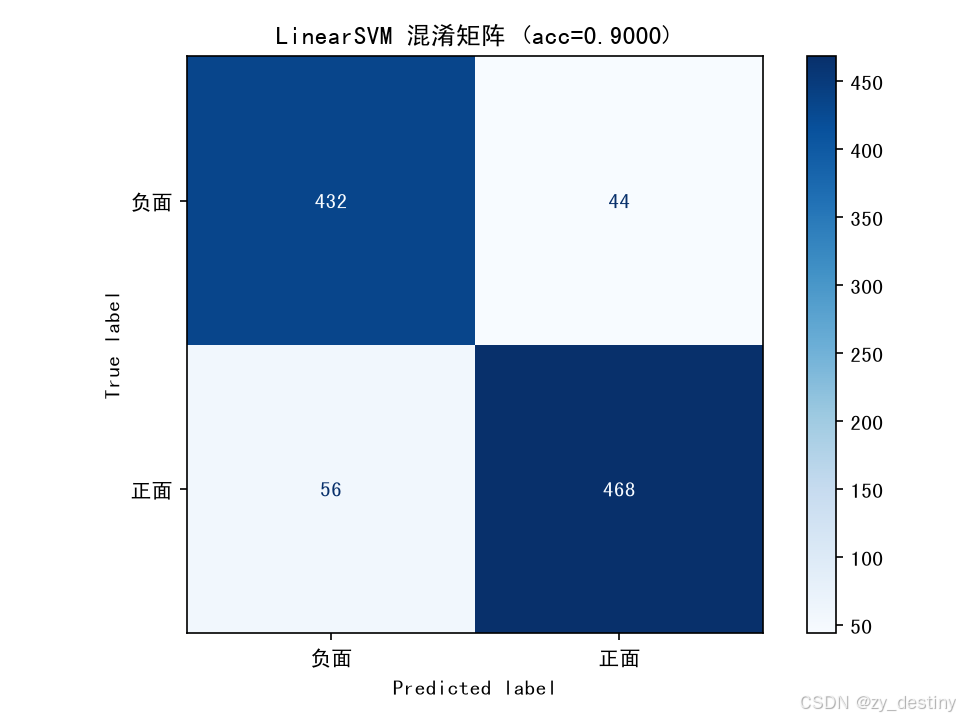
| TF-IDF + 线性 SVM | 0.9000 | 0.8999 | 0.57 s |
三个基线模型的训练都在1 秒内完成,最好的线性 SVM 已经达到 90.00% 的准确率——这是一个很强的"及格线"。
线性 SVM 的分类报告(节选):
              precision    recall  f1-score   support
         负面     0.8852    0.9076    0.8963       476
         正面     0.9141    0.8931    0.9035       524
    accuracy                         0.9000      1000
   macro avg     0.8997    0.9003    0.8999      1000
② BERT 微调结果
BERT(1 个 epoch 微调,测试集 n=1000)
| 指标 | 数值 |
|---|---|
| 验证集 Accuracy | 0.9313 |
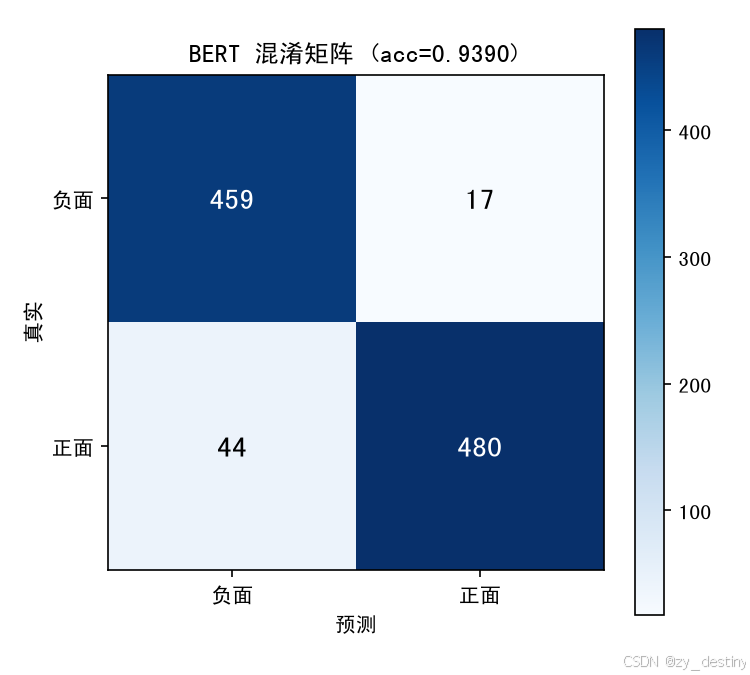
| 测试集 Accuracy | 0.9390 |
| 测试集 Macro-F1 | 0.9390 |
| 参数量 | 102.3 M |
| CPU 训练耗时 | 约 35 分钟 / epoch |
分类报告:
              precision    recall  f1-score   support
         负面     0.9125    0.9643    0.9377       476
         正面     0.9658    0.9160    0.9403       524
    accuracy                         0.9390      1000
   macro avg     0.9392    0.9402    0.9390      1000
weighted avg     0.9404    0.9390    0.9390      1000

混淆矩阵 [[459  17]
          [ 44 480]]      # 负例中 17 条被误判为正面,正例中 44 条被误判为负面
结论:BERT 只训练 1 个 epoch,测试集准确率就从基线的 90.00% 提升到 93.90%(+3.9 个百分点),错误数从 100 条降到 61 条。
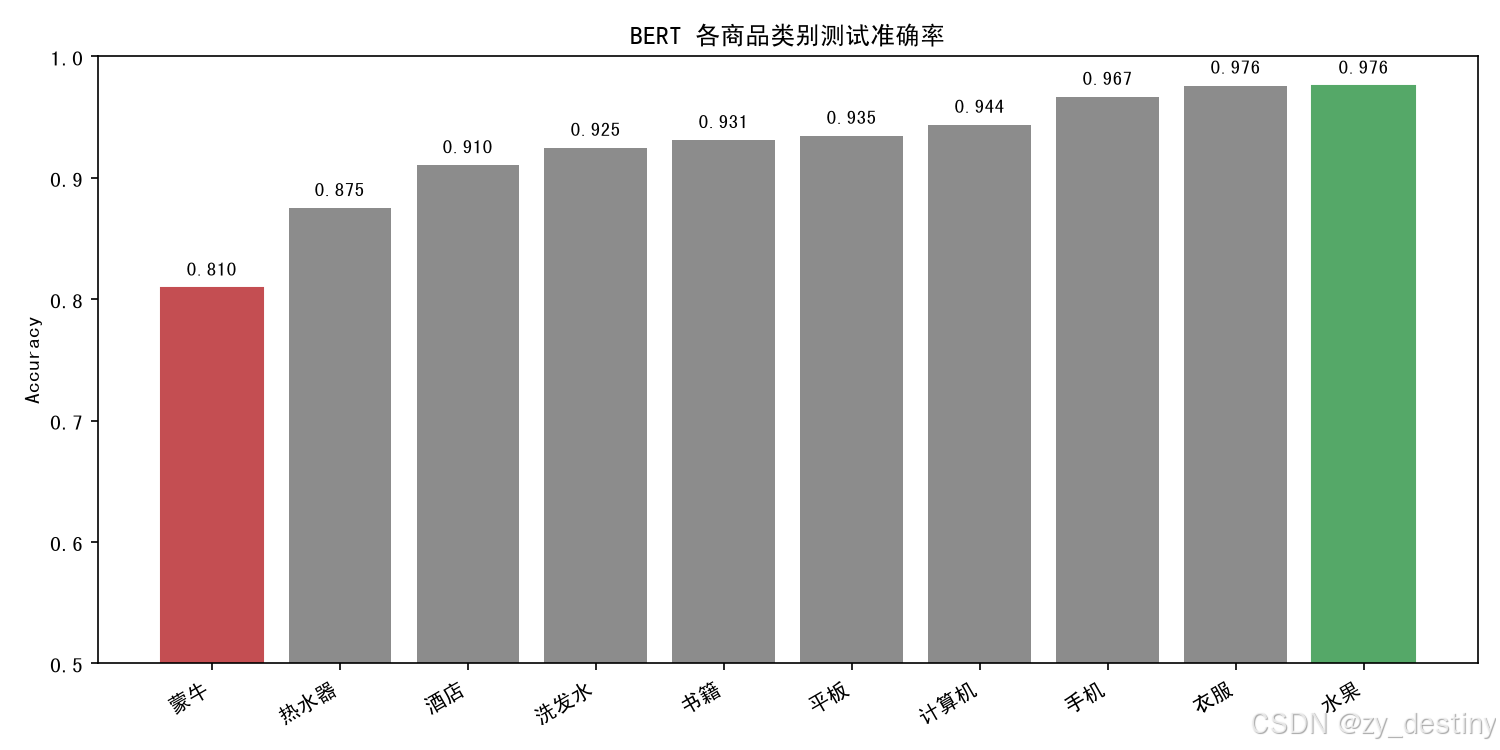
各商品类别准确率(可以清楚看到模型在不同品类上的表现差异):
| 品类 | 准确率 | 品类 | 准确率 |
|---|---|---|---|
| 水果 | 0.976 | 酒店 | 0.910 |
| 衣服 | 0.976 | 热水器 | 0.875 |
| 手机 | 0.967 | 蒙牛 | 0.810 |
| 计算机 | 0.944 | 洗发水 | 0.925 |
| 平板 | 0.935 | 书籍 | 0.931 |
“蒙牛”"热水器"两类准确率明显偏低,原因是这两个品类的训练样本最少(252 条、73 条),数据量不足是主因——这也是真实业务中最常见的问题,可以通过采集更多该品类数据或做类别平衡采样来改善。
训练曲线(Loss 下降、验证准确率上升,无过拟合迹象):
BERT 混淆矩阵:
BERT 各品类准确率:
四个模型总对比:
4.7 推理测试
模型训练好之后,加载权重对任意新评论做情感预测,这才是模型的实际使用方式:
import torch
from transformers import BertTokenizer, AutoModelForSequenceClassification

tokenizer = BertTokenizer.from_pretrained("models/bert_onlineshopping")
model = AutoModelForSequenceClassification.from_pretrained("models/bert_onlineshopping")
model.eval()

def predict(texts):
    enc = tokenizer(texts, truncation=True, max_length=128,
                    padding=True, return_tensors="pt")
    with torch.no_grad():
        logits = model(**enc).logits
    probs = torch.softmax(logits, dim=-1)
    return probs.argmax(-1), probs[:, 1]

demo = [
    "快递很快,包装严实,手机手感一流,续航也很给力,非常满意!",
    "质量太差了,用了两天就坏了,客服还不理人,差评!",
    "酒店位置不错,房间干净,就是隔音一般。",
]
preds, pos_prob = predict(demo)
for t, p, pr in zip(demo, preds, pos_prob):
    print(f"[{'正面' if p==1 else '负面'} | p={pr:.3f}] {t}")
① 自定义评论推理结果
| 输入评论 | 预测 | 正面概率 | 判定 |
|---|---|---|---|
| 快递很快,包装严实,手机手感一流,续航也很给力,非常满意! | 正面 | 0.9916 | ✅ 正确 |
| 客服态度非常好,回复及时,问题很快就解决了,点赞。 | 正面 | 0.9883 | ✅ 正确 |
| 质量太差了,用了两天就坏了,客服还不理人,差评! | 负面 | 0.0123 | ✅ 正确 |
| 水果一点都不新鲜,收到的时候已经烂了一半,非常失望。 | 负面 | 0.0153 | ✅ 正确 |
| 酒店位置不错,房间干净,就是隔音一般。 | 正面 | 0.9880 | ✅ 正确(转折句理解为整体满意) |
| 这本书内容还可以,就是印刷质量一般般。 | 正面 | 0.9626 | ✅ 正确 |
可以看到模型对带转折的复杂句(“……不错,就是……一般”)也能给出合理的整体判断,这正是 BERT 上下文建模能力的体现。
② 测试集批量推理
===== 测试集批量推理 =====
accuracy=0.9390  macro-F1=0.9390  样本数=1000
错误样本数:61
③ 错误案例分析(最有价值的一步)
把 61 条预测错的样本按置信度排序后会发现一个有趣现象——不少"错误"其实是数据集本身的标注噪声:
| 真实标签 | 模型预测 | 置信度 | 评论内容 |
|---|---|---|---|
| 负面 | 正面 | 0.990 | 质量很好,卖家态度也很好 |
| 负面 | 正面 | 0.983 | 书的质量还可以,内容也还行。感觉一般! |
| 正面 | 负面 | 0.983 | 吹风机也没有,东西还破了,哎太没有爱了,让我心情很不好,很失望… |
| 负面 | 正面 | 0.983 | 位置不错, 在市中心, 而且离周边几家4,5星酒店都只有10分钟路程. |
第一条评论"质量很好,卖家态度也很好"被标注为负面,模型却给出了 99% 的正面概率——这种情况下模型的判断反而更合理。这说明 0.939 的准确率已经接近该数据集的"天花板",进一步提升需要清洗标注噪声,而不是继续堆模型。
真正有代表性的困难样本是长文本 + 多重转折,例如一条酒店评论前半段夸位置、后半段抱怨门童与前台,模型只捕捉到了前半段的正面情绪。这也给出了优化方向:增大 max_length、或对长评论做分句后加权聚合。
④ 完整代码见 src/04_infer.py,运行后会在 outputs/ 下生成:
inference_demo.csv:自定义评论的预测结果;test_predictions.csv:测试集 1000 条的全量预测(含正例概率与是否正确);final_summary.json:四个模型的最终对比。
5. 总结与踩坑记录
5.1 实验结论
四个模型的最终成绩单(测试集 n=1000):
| 模型 | Accuracy | Macro-F1 | 训练耗时 | 参数量 |
|---|---|---|---|---|
| TF-IDF + 朴素贝叶斯 | 0.8670 | 0.8667 | 0.17 s | - |
| TF-IDF + 逻辑回归 | 0.8980 | 0.8979 | 0.56 s | - |
| TF-IDF + 线性 SVM | 0.9000 | 0.8999 | 0.57 s | - |
| BERT (bert-base-chinese) | 0.9390 | 0.9390 | 约 35 min | 102.3 M |
三条值得记住的经验:
- 永远先跑 Baseline。三个 TF-IDF 基线加起来不到 2 秒就能训练完,却能提供一条清晰的及格线(90%)。没有基线,你无法判断花 35 分钟训练的 BERT 是否真的值得;
- 预训练模型的价值在于"少数据、高精度"。本实验只用 7,200 条训练样本、1 个 epoch,BERT 就把准确率从 90.00% 提到 93.90%,错误数减少近 40%;
- 准确率遇到瓶颈时,先怀疑数据而不是模型。错误案例显示,数据集中存在明显标注噪声,此时清洗数据、增加难例样本的收益,远大于继续调参换模型。
完整实验清单:
| 步骤 | 脚本 | 产物 |
|---|---|---|
| 数据导入 + EDA 可视化 | src/01_eda.py | figures/01~05、outputs/eda_stats.json |
| 传统 ML 基线 | src/02_baseline.py | figures/06~07、outputs/baseline_results.json |
| BERT 微调 | src/03_train_bert.py | models/bert_onlineshopping、outputs/train_log.txt |
| 权重评估(可选) | src/05_eval_only.py | figures/08~10、outputs/bert_results.json |
| 推理与对比 | src/04_infer.py | figures/11、outputs/test_predictions.csv |
5.2 踩坑记录
- HuggingFace 下载超时:国内直连
huggingface.co会卡死,解决方式是设置镜像环境变量HF_ENDPOINT=https://hf-mirror.com,或直接用浏览器从镜像站下载模型文件(config.json、vocab.txt、tokenizer_config.json、model.safetensors四个文件放入本地目录); - CPU 训练太慢:三个关键优化——①动态 Padding(只补齐到 batch 内最大长度,本数据集能省 60% 以上计算);②
max_length=128而不是 512;③torch.set_num_threads()拉满物理核心。即便如此,BERT 一轮完整训练在笔记本上仍需约二十分钟,有 GPU 的同学建议直接用 GPU; - 中文字体乱码:matplotlib 默认字体不支持中文,需要设置
plt.rcParams["font.sans-serif"] = ["SimHei", "Microsoft YaHei"]; - transformers 新版本 API 变化:新版加载预训练权重时会打印"UNEXPECTED / MISSING keys"报告——
cls.开头的预训练头是 UNEXPECTED(被丢弃)、classifier.是 MISSING(新初始化),这是正常现象,因为我们把 MLM 预训练模型改造成了分类模型。
5.3 改进方向
- 数据增强:同义词替换、回译、EDA 随机噪声注入;
- 更优预训练模型:
hfl/chinese-roberta-wwm-ext(动态掩码预训练,通常比原版 BERT 高 1~2 个点); - 难例挖掘:从错误案例看,"先扬后抑"的反讽句仍是主要错误来源,可引入更大
max_length或层级编码处理长评论; - 模型轻量化部署:知识蒸馏(DistilBERT)或 ONNX Runtime 量化,把推理延迟压到毫秒级;
- 扩展到多分类:
cat字段可以做商品品类多分类任务,流程完全一致。
如果本文对你有帮助,欢迎点赞、收藏、评论交流!完整代码与图表可在评论区索取。
电商企业物流数字化转型必备!快递鸟 API 接口,72 小时快速完成物流系统集成。全流程实战1V1指导,营造开放的API技术生态圈。
更多推荐
 3
 0
- 0


 已为社区贡献1条内容

所有评论(0)