电商资料包合规体检实战:用蓝耘元生代把 20 分钟人工核验压成一分半
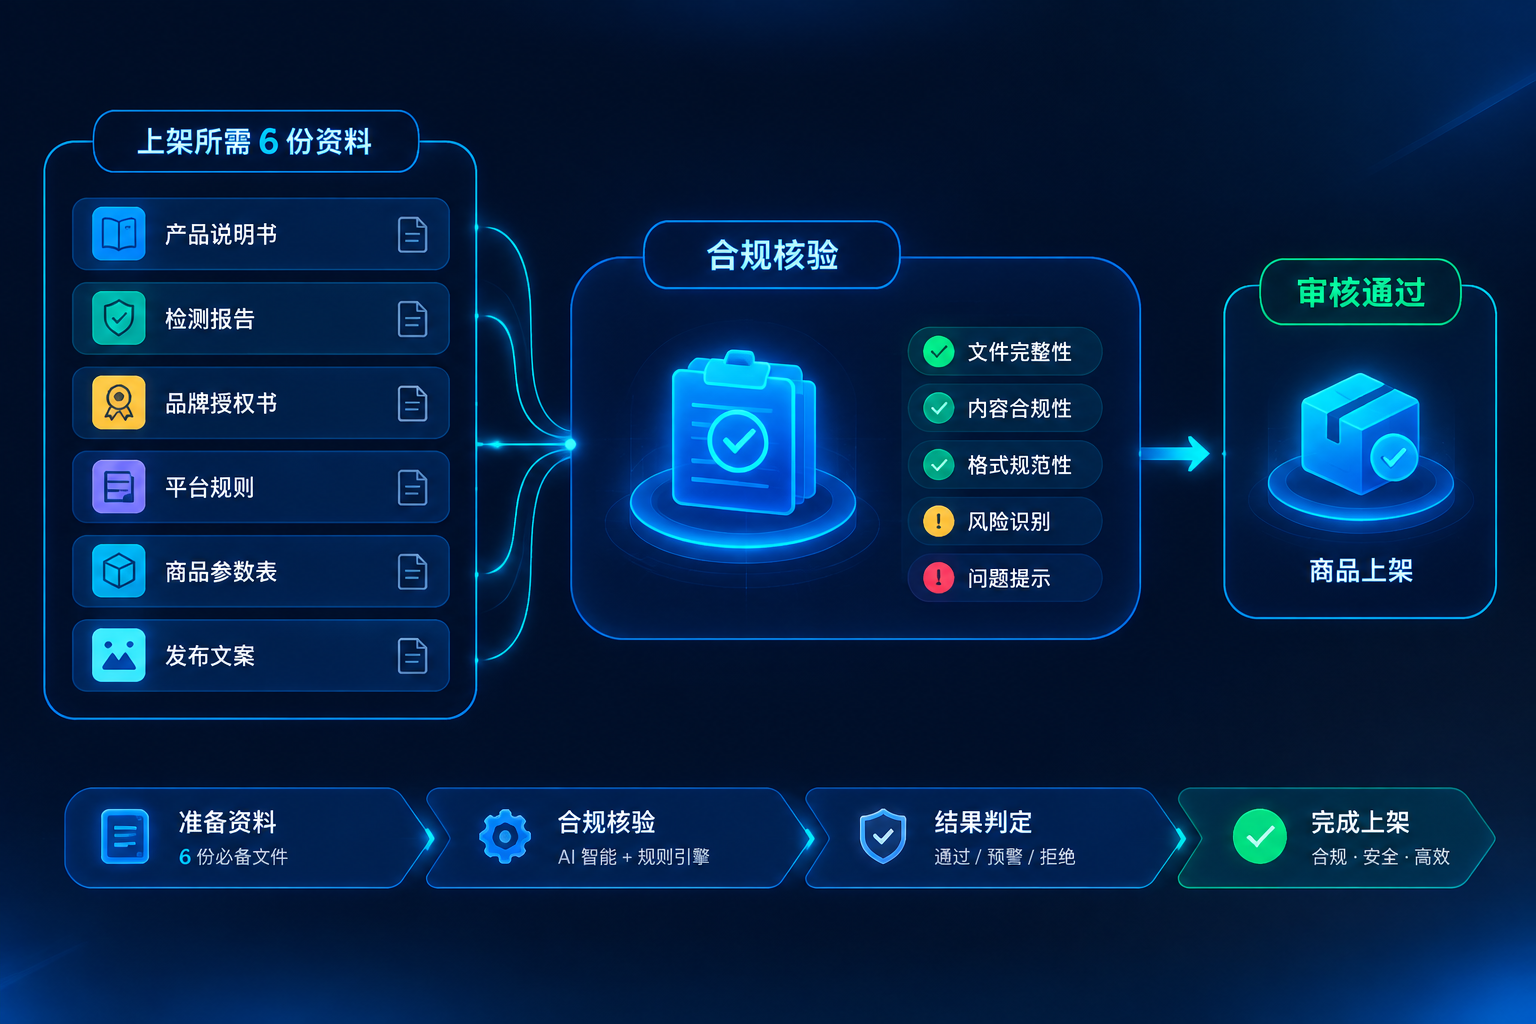
在电商运营的日常里,合规核验是那个枯燥但至关重要的环节。一个商品上架前,需要齐备产品说明书、检测报告、品牌授权书、平台规则、商品参数表及发布文案等多达六份文件。这些文件来自研发、检测机构、品牌方、平台和运营等多个源头,其关键字段——型号、净含量、品牌名、生产企业、授权渠道——必须严格一致,任何偏差都可能导致商品被平台驳回,甚至引发虚假宣传的风险。
传统的人工核验方式,是让一名运营人员逐一比对这十几页文档中的海量信息,耗时20分钟只是起步,且高度依赖个人经验和状态,极易因疲劳或疏忽产生遗漏。更常规的单模型AI方案,往往试图用一个多模态模型处理所有文档和图片,但文本逻辑推理与图片精准识别本是两种截然不同的能力,硬塞给一个模型,结果往往是“样样通,样样松”,在关键信息上表现得并不稳定。
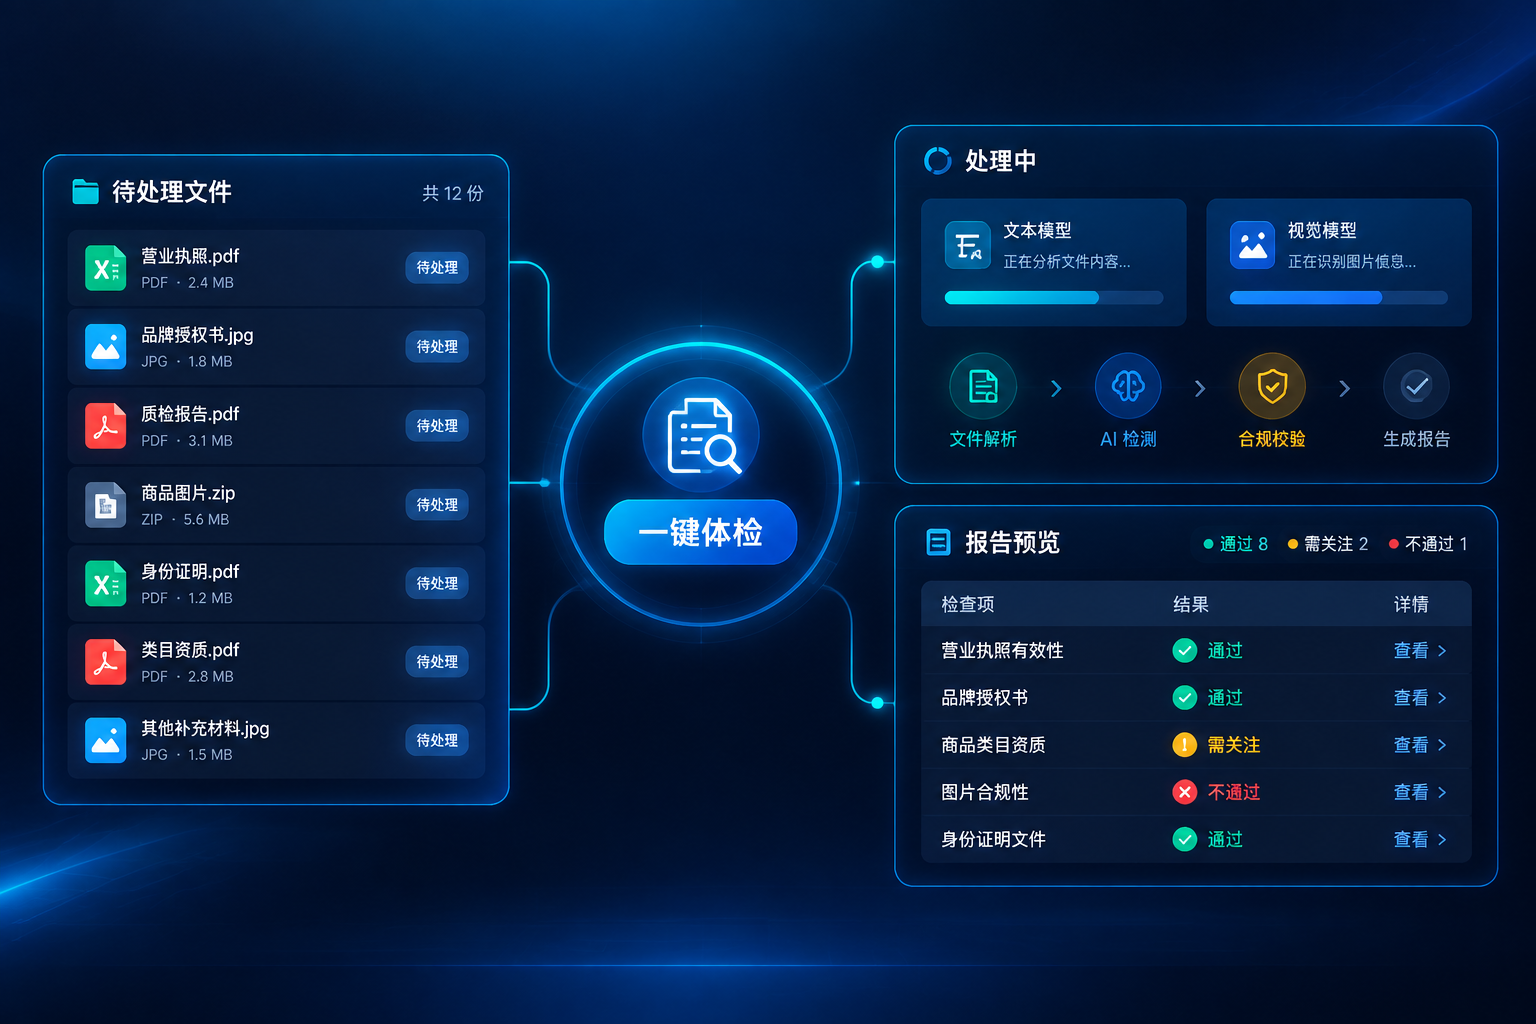
本文分享一套可直接落地的双模型协同方案:蓝耘元生代MaaS统一网关 + 文本大模型 + 视觉大模型,通过合理的任务分工与结果合并,将二十分钟的人工苦力活,压缩到一次点击、一分半钟内自动完成。
一、核心挑战:文本与图片为何需要分而治之?
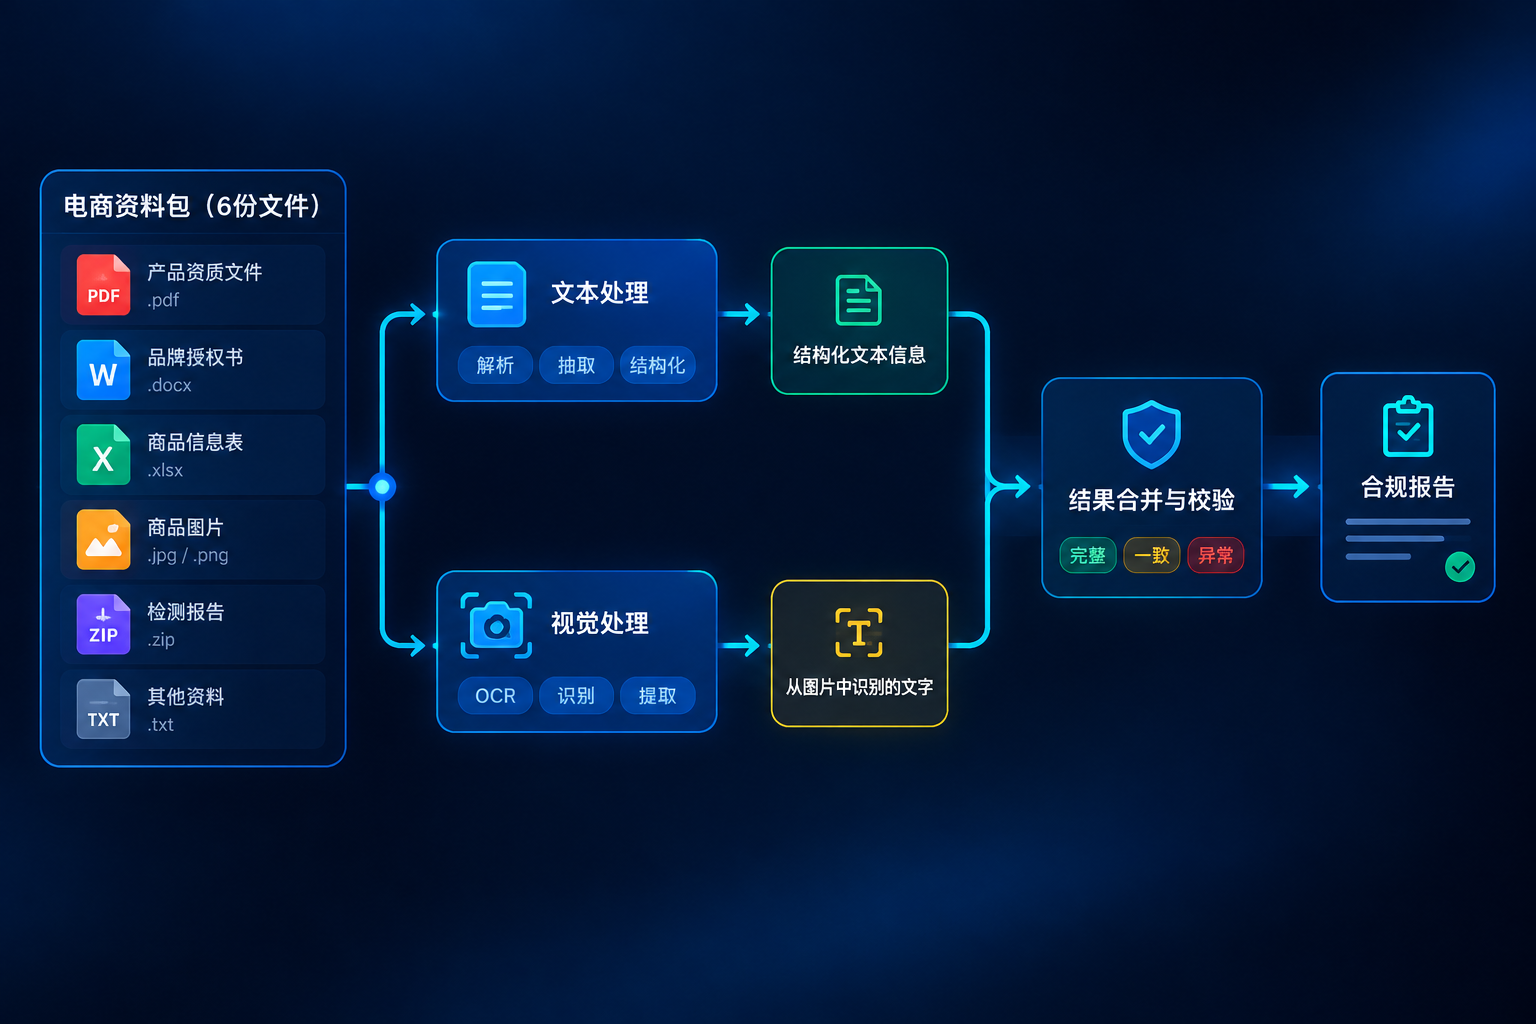
要理解方案的精髓,首先需剖析合规核验任务的两种本质不同的子任务:
- 文本逻辑审查:处理产品说明书、授权书等长文档,需要在上万字的上下文中进行信息提取、逻辑关联与冲突检测。例如,判断文案中的“独家授权”是否与授权书条款矛盾,或产品型号是否贯穿所有文件。这极度依赖模型的长上下文理解与逻辑推理能力。
- 图片信息提取:解析产品包装图、检测报告盖章页等,核心是高精度OCR,需要准确识别并转写“品牌名”、“净含量”、“批准文号”等视觉信息,一个字符都不能错。这考验的是模型的视觉解析与细节捕捉能力。
硬塞给一个模型,就像让一名逻辑严密的文员去当显微镜观察员,结果往往是两边都不专业。因此,我们将任务拆分,让擅长阅读长文的模型负责文本审查,让视觉能力强的模型负责图片解读。
核心结论: 理解任务的异质性是设计高效AI流程的第一步,分而治之比全能模型更可靠。
二、平台选择:为何是蓝耘元生代MaaS?
选定双模型策略后,如何便捷、低成本地调用多个不同模型成为关键。蓝耘元生代MaaS平台提供了一个理想的解决方案:
- 统一API网关:使用一个API Key即可调用平台上的所有模型,包括DeepSeek、通义千问、智谱等。无需为每个模型单独申请密钥,极大简化了密钥管理。
- 丰富的模型选择:平台集成了众多业界领先的模型,方便我们为文本和视觉任务分别挑选最合适的一个,例如我们选择的
qwen3.8-max(长文本)和qwen3.5-omni-plus(全模态)。 - 清晰的定价与计量:按实际Token用量计费,对于这种短时、突发性的核验任务非常经济,无需长期维护模型服务。
在蓝耘控制台(maas.lanyun.net)注册并创建API Key后,我们便拥有了接入整个模型生态的“万能钥匙”。
核心结论: 统一的MaaS平台是实现多模型协同、降低集成复杂度的基石。
三、架构设计:配置双模型的关键改造
原始工程通常配置单一模型。为支持双模型,我们需要对配置结构进行最小化改造。核心思路是将模型配置收拢到一个结构化对象中,明确区分文本模型和视觉模型。
以下是一个Python配置示例,展示了如何在代码中管理这个结构,并强调密钥必须从环境变量读取,绝不能硬编码:
# config.py
import os

# 双模型配置结构
PROVIDERS = {
    "lanyun": {
        "label": "蓝耘元生代 MaaS",
        "short": "蓝耘",
        "base_url": os.getenv("LANYUN_BASE_URL", "https://maas-api.lanyun.net/v1"),
        "api_key": os.getenv("LANYUN_API_KEY"),  # 关键:从环境变量读取
        "text_model": "qwen3.8-max",      # 负责长文本审查
        "vision_model": "qwen3.5-omni-plus" # 负责图片OCR与解析
    }
}

# 为了向后兼容,可以设置一个默认的模型名称属性
def get_default_model():
    return PROVIDERS["lanyun"]["text_model"]
配置要点总结: 环境变量保安全,双模型字段分清晰,向后兼容不折腾。
四、定义结构:合规检查项如何数字化?
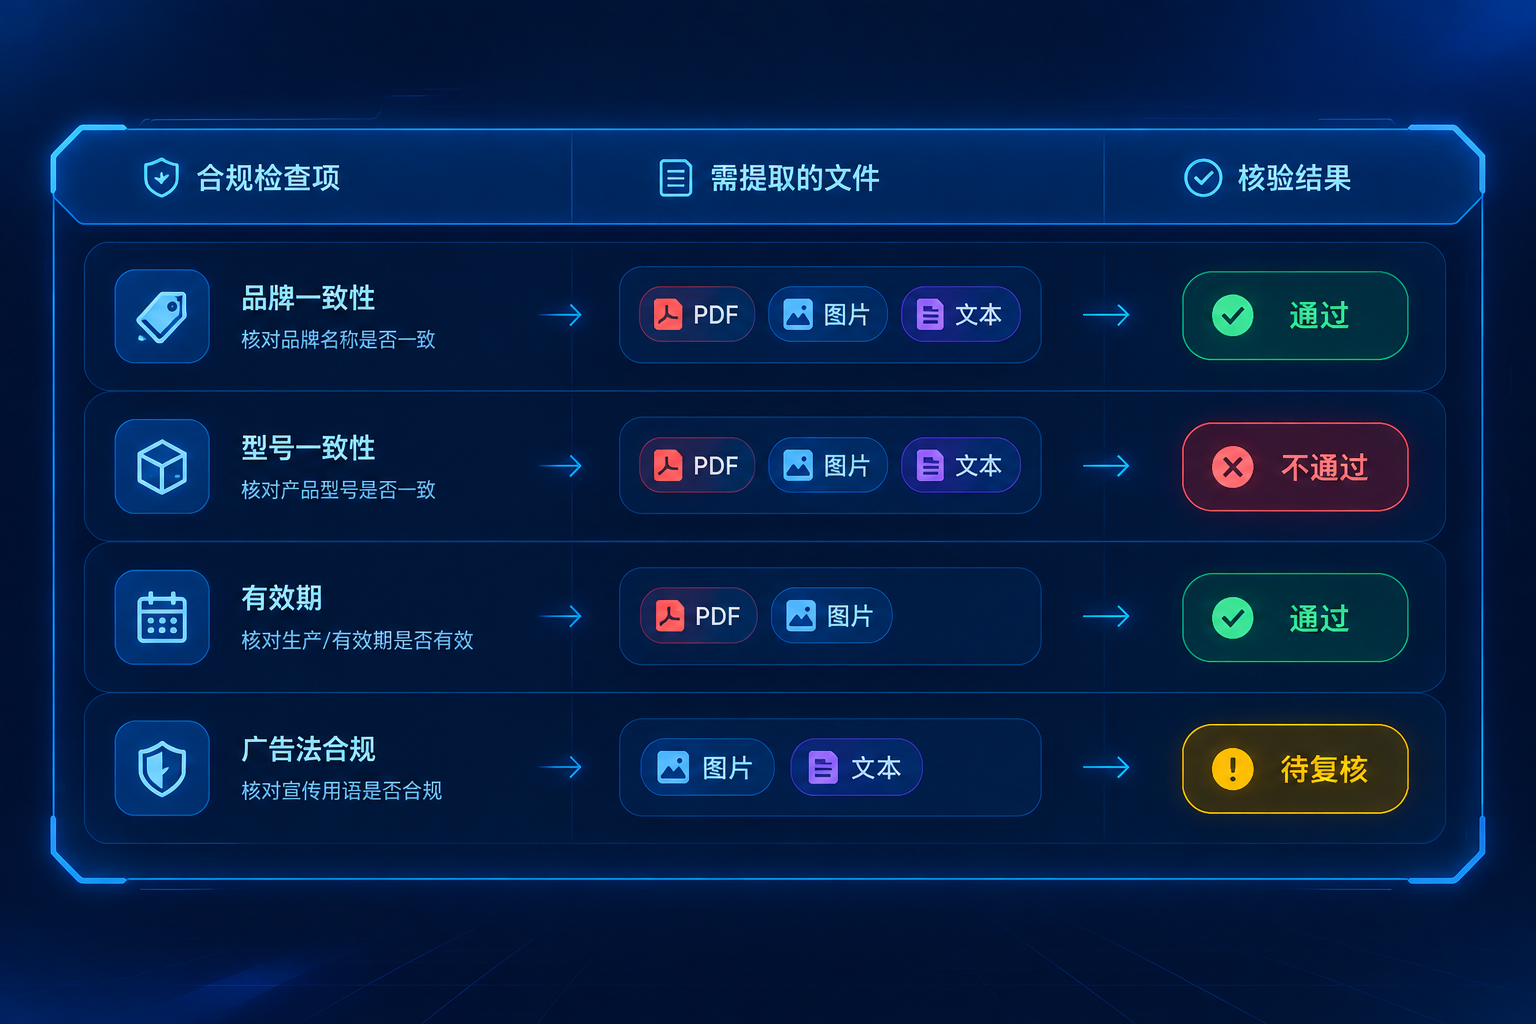
为了系统化地进行核验,我们首先需要将模糊的“合规”要求,转化为结构化的检查项列表。这定义了程序“看什么”和“查什么”。
一个典型的电商资料包检查项可以设计如下表格结构:
| 检查项ID | 类别 | 数据来源 | 关键字段 | 校验规则 | 预期结果 |
|---|---|---|---|---|---|
| C001 | 品牌一致性 | 授权书、产品图 | 品牌名 | 字符串精确匹配 | 一致 |
| C002 | 型号一致性 | 说明书、参数表、文案 | 产品型号 | 字符串精确匹配 | 一致 |
| C003 | 有效期 | 授权书 | 授权截止日期 | 格式校验 & 未来日期 | 未过期 |
| C004 | 广告法合规 | 发布文案 | 宣传用语 | 关键词黑名单匹配 | 不含违禁词 |
将这些检查项用字典列表表示,便于后续程序遍历执行。
# compliance_checks.py
COMPLIANCE_CHECKS = [
    {
        "id": "C001",
        "category": "品牌一致性",
        "sources": ["授权书.pdf", "product_image.png"],
        "fields": ["brand_name"],
        "rule": "exact_match",
        "description": "授权书中的品牌名必须与产品包装图上的品牌名完全一致。"
    },
    {
        "id": "C004",
        "category": "广告法合规",
        "sources": ["release_copy.txt"],
        "fields": ["all_text"],
        "rule": "keyword_blacklist",
        "keywords": ["顶级", "最佳", "第一", "国家级", "驰名商标"],
        "description": "发布文案中不得包含广告法禁用的绝对化用语。"
    }
    # ... 更多检查项
]
核心结论: 清晰的结构化定义是自动化核验的蓝图,让模糊的“合规”变得可计算、可判断。
五、文本处理:让长文本模型进行“审阅”
对于文本类文件(如说明书、授权书、文案),我们将其内容合并,交由长文本大模型(如 qwen3.8-max)进行审阅。模型的任务不是简单复制粘贴,而是理解和抽取。
提示词(Prompt)工程是这里的关键。我们需要清晰地定义角色、任务和输出格式。
import openai

def check_text_compliance(text_content, check_items):
    client = openai.OpenAI(
        api_key=PROVIDERS["lanyun"]["api_key"],
        base_url=PROVIDERS["lanyun"]["base_url"]
    )
    prompt = f"""
    你是一位严格的电商合规审计员。请分析以下资料包文本内容,并执行指定的合规检查项。

    ## 资料包文本内容:
    ```
    {text_content}
    ```

    ## 需要执行的检查:
    {check_items}

    ## 输出要求:
    请以JSON格式输出每个检查项的结果,包含 "id", "status"("pass"或"fail"), "extracted_value"(提取到的值), "reason"(原因)。
    """
    response = client.chat.completions.create(
        model=PROVIDERS["lanyun"]["text_model"],
        messages=[{"role": "user", "content": prompt}],
        response_format={"type": "json_object"}
    )
    return response.choices[0].message.content
文本模型工作流: 接收长文本 → 解析结构化检查指令 → 按规则提取与验证 → 输出JSON格式结果。
六、视觉处理:让视觉模型担当“侦察兵”
对于图片文件(如包装图、报告扫描件),我们使用视觉大模型(如 qwen3.5-omni-plus)进行信息侦察。其核心是精准OCR,而非理解图片故事。
我们需要给模型一个明确的“搜索清单”,告诉它我们要从图里找什么具体文字。`
def extract_info_from_image(image_path, fields_to_extract):
    client = openai.OpenAI(
        api_key=PROVIDERS["lanyun"]["api_key"],
        base_url=PROVIDERS["lanyun"]["base_url"]
    )
    with open(image_path, "rb") as image_file:
        image_data = image_file.read()
    prompt = f"""
    请作为高精度OCR引擎,仔细观察这张图片,并提取以下信息:
    {fields_to_extract}

    要求:
    1. 严格按照图片上的文字进行提取,不要推测或补全。
    2. 如果某个信息在图中找不到,对应值填"未找到"。
    3. 只输出JSON,格式为 {{"字段名": "提取到的文字"}}。
    """
    response = client.chat.completions.create(
        model=PROVIDERS["lanyun"]["vision_model"],
        messages=[{
            "role": "user",
            "content": [
                {"type": "text", "text": prompt},
                {"type": "image_url", "image_url": {"url": f"data:image/png;base64,{base64.b64encode(image_data).decode()}"}}
            ]
        }],
        response_format={"type": "json_object"}
    )
    return response.choices[0].message.content
视觉模型工作流: 接收图片 → 按指定字段清单执行精准OCR → 输出结构化键值对。
七、模型能力对比:同一个包装盒,谁的“眼睛”更毒?
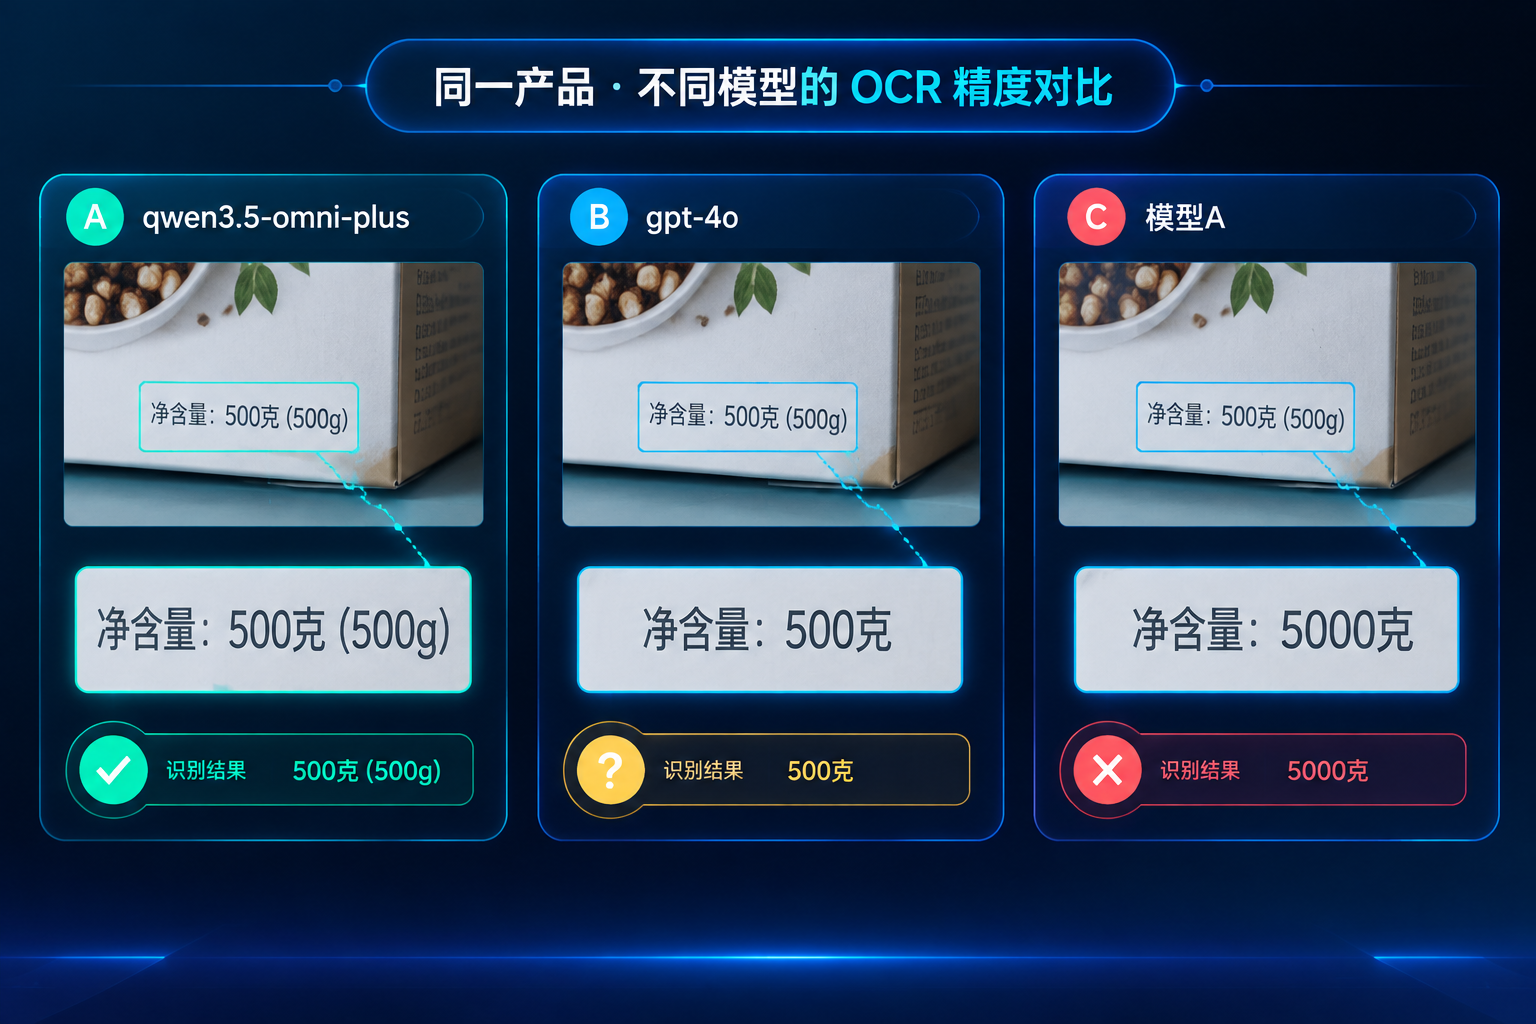
不同的视觉模型在OCR精度上可能有天壤之别。我们设计了一个对比实验,用同一张复杂的产品包装图,测试三个模型提取“净含量”的能力,结果如下:
| 模型 | 净含量提取结果 | 错误分析 |
|---|---|---|
| qwen3.5-omni-plus | 500克 (500g) | 成功识别括号内外的两种单位,准确无误。 |
| gpt-4o | 500克 | 识别了括号外的单位,但丢失了括号内的等效标注。 |
| 某开源模型A | 5000克 | 将“500g”错误识别为“5000克”,单位混淆导致数量级错误。 |
这个对比清晰表明,对于电商合规这种“一字千金”的场景,选择一个经过精心优化、视觉能力强大的模型(如 qwen3.5-omni-plus)至关重要,它可以避免因OCR错误导致的合规风险。
核心结论: 视觉信息提取是合规校验的第一道防线,模型选型必须基于实测,不可想当然。
八、结果合并与报告生成:从零散数据到最终结论
文本审查和视觉提取完成后,我们得到了一系列结构化的中间结果。最后一步是在本地逻辑中将它们合并,并与我们预定义的检查项进行最终比对,生成一份人类可读的报告。
def generate_final_report(text_results, vision_results, checks):
    report = []
    for check in checks:
        check_id = check["id"]
        status = "pass"
        details = []

        # 根据检查项类型,从对应结果中查找证据
        if check["category"] == "品牌一致性":
            # 从文本结果和视觉结果中分别提取品牌名
            brand_from_text = text_results.get("extracted_brand") # 假设文本模型提取的结果
            brand_from_vision = vision_results.get("brand_name")
            if brand_from_text and brand_from_vision and brand_from_text.lower() == brand_from_vision.lower():
                details.append(f"文本品牌: {brand_from_text}, 包装图品牌: {brand_from_vision},一致。")
            else:
                status = "fail"
                details.append(f"文本品牌: {brand_from_text}, 包装图品牌: {brand_from_vision},不一致!")

        # ... 其他检查项的合并逻辑
        report.append({"check_id": check_id, "status": status, "details": ". ".join(details)})
    return report
报告生成逻辑: 遍历检查项 → 从多模型结果中定位证据 → 执行本地校验规则 → 汇总生成最终报告。
九、端到端实战:一次完整的合规体检流程
将所有模块串联起来,一次完整的自动合规体检流程如下:
流程图:
获取密钥 → 加载配置与检查项 → 处理所有文档(文本模型) → 处理所有图片(视觉模型) → 合并结果与生成报告
具体执行时,主控脚本需要协调文件的读取、分发、模型调用和结果收集。蓝耘统一网关的优势在此尽显:同一个Key,先调用文本模型处理一堆PDF,紧接着调用视觉模型处理一批PNG,过程无缝切换。整个流程对于操作者而言,就是执行一个命令,等待约90秒,然后打开一份清晰的HTML或JSON报告,上面明确标出了每一项检查的通过/失败状态和详细原因。
核心结论: 自动化的价值在于将重复性脑力劳动封装成可随时调用的标准化服务。
十、实战建议与避坑指南
在实际落地这套方案时,以下几个经验值得注意:
- 分阶段验证:先用少量文件跑通整个流程,重点验证视觉模型的OCR准确率和文本模型的逻辑判断能力,再批量处理。
- 成本控制:可以通过优化提示词长度、缓存常用结果、对非关键信息降级处理等方式来控制Token消耗。
- 错误处理与日志:为每个模型的API调用增加重试机制和详细的日志记录,记录下每次调用的输入摘要和返回结果,便于问题排查。
- 持续优化检查项:合规要求是会变化的(如平台规则更新、广告法修订),设计的
COMPLIANCE_CHECKS结构应易于扩展和修改。
常见问题速查表:
| 问题现象 | 可能原因 | 解决方案 |
|---|---|---|
| 视觉模型返回“未找到” | 图片分辨率低、角度倾斜、信息不清晰 | 提示词中增加“请尽力识别”指令,或预处理图片(增强、旋转) |
| 文本模型判断有误 | 提示词模糊,或检查项规则复杂 | 细化Prompt,将复杂规则拆分为多个简单子任务 |
| API调用超时 | 文件过大或网络波动 | 实现分块处理,并增加超时重试逻辑 |
结语
通过蓝耘元生代MaaS平台,我们成功构建了一套高效、可靠的电商资料包自动合规核验系统。它将耗时费力且易错的人工核验,转变为由文本大模型和视觉大模型分工协同的智能化流程,最终实现了一分半钟完成原本需要二十分钟的工作,并且输出结果更加稳定、可追溯。这套方案的核心价值不仅在于提效,更在于通过结构化的定义与多模型协同,为电商业务的关键合规环节建立了一道可靠的自动化防线。
拥抱模型协作,用专业的模型做专业的事,是让AI真正可靠落地的不二法门。
电商企业物流数字化转型必备!快递鸟 API 接口,72 小时快速完成物流系统集成。全流程实战1V1指导,营造开放的API技术生态圈。
更多推荐
 5
 0
- 0


 已为社区贡献1条内容

所有评论(0)