面向电商冷启动与数据稀疏性的协同过滤算法优化研究
随着电子商务的快速发展,推荐系统已成为提升用户体验和平台交易转化率的关键技术。然而,在实际应用场景中,新用户和新物品的冷启动问题以及用户物品交互矩阵的极端稀疏性严重制约了传统协同过滤算法的性能。本文针对电商场景下的冷启动与稀疏性问题,提出一种融合混合填充、注意力机制与场景感知协同的改进协同过滤算法。以 Amazon Fashion 公开数据集为实验基础,通过数据清洗、用户画像构建、时间序列切分等预处理手段,构建了传统协同过滤、基于内容推荐与改进算法三组对照实验。实验采用准确率、召回率和运行时间作为评价指标,并在整体、冷启动用户和稀疏用户三个维度上进行分段评估。三组重复实验结果表明,改进算法在冷启动场景下准确率提升 0.0463、召回率提升 0.4284,在稀疏场景下准确率提升 0.0349、召回率提升 0.2989,验证了所提方法在解决冷启动与稀疏性问题上的有效性。
关键词:推荐系统;协同过滤;冷启动;数据稀疏性;注意力机制
With the rapid development of e-commerce, recommender systems have become a key technology for improving user experience and platform transaction conversion rates. However, in practical application scenarios, the cold-start problem of new users and new items, as well as the extreme sparsity of user-item interaction matrices, severely restrict the performance of traditional collaborative filtering algorithms. This paper proposes an improved collaborative filtering algorithm that integrates hybrid imputation, attention mechanism, and context-aware fusion to address the cold-start and sparsity issues in e-commerce scenarios. Based on the Amazon Fashion public dataset, three sets of comparative experiments are constructed: traditional collaborative filtering, content-based recommendation, and the improved algorithm. Precision, recall, and runtime are used as evaluation metrics, and segmental evaluations are conducted across overall, cold-start, and sparse user dimensions. The results of three repeated experiments show that the improved algorithm achieves an increase of 0.0463 in precision and 0.4284 in recall in cold-start scenarios, and 0.0349 in precision and 0.2989 in recall in sparse scenarios, verifying the effectiveness of the proposed method in addressing cold-start and sparsity issues.
Keywords: Recommender System; Collaborative Filtering; Cold Start; Data Sparsity; Attention Mechanism
第一章 绪论
1.1 研究背景
随着互联网技术的飞速发展和电子商务平台的日益繁荣,全球在线零售市场规模持续扩大。在商品种类和数量呈指数级增长的背景下,用户面临着严重的信息过载问题,如何从海量商品中快速发现符合个人兴趣的产品成为亟待解决的挑战。推荐系统作为信息过滤的重要手段,能够根据用户的历史行为、偏好特征和上下文环境,主动为用户提供个性化的商品推荐,有效缓解信息过载,提升用户体验和平台黏性。在电商场景中,推荐系统的应用不仅有助于提高用户的购买转化率,还能促进长尾商品的曝光,实现用户与平台的互利共赢。
在众多推荐技术中,协同过滤因其原理直观、实现简单且效果稳定而成为应用最广泛的算法之一。协同过滤基于“物以类聚,人以群分”的假设,通过分析用户之间的相似性或物品之间的相似性来生成推荐。其核心思想是:如果两个用户在过去对某些物品的评分相似,那么他们在未来对其他物品的评分也会相似。这种基于群体智慧的推荐方法无需依赖物品的内容属性,仅凭用户的历史交互行为即可产生高质量的推荐,因此在许多工业界推荐系统中得到广泛应用。
然而,在实际电商场景中,协同过滤面临着两个核心挑战:冷启动问题与数据稀疏性问题。冷启动问题指当新用户或新物品加入系统时,由于缺乏足够的历史交互数据,算法难以准确建模用户的兴趣或物品的特征,从而无法提供有效的推荐。对于新用户,系统没有任何评分记录,无法计算其与其他用户的相似度,也无法通过协同过滤进行个性化推荐;对于新物品,没有用户对其评分,无法被任何用户的邻居所覆盖,导致其永远不会出现在推荐列表中。冷启动问题严重影响了新用户的体验和新物品的曝光机会,是推荐系统部署初期最棘手的难题之一。
数据稀疏性问题则源于现实推荐系统中用户物品交互矩阵的极端稀疏性。在典型的电商平台中,用户与物品的交互数量往往仅占潜在交互总数的极小比例。以 Amazon 数据集为例,用户数通常数以万计,物品数同样庞大,但每个用户平均仅与极少数物品发生过交互,导致用户物品矩阵中绝大部分元素为零。这种稀疏性使得相似度计算失真,用户之间的共同评分物品极少,难以可靠地度量相似性。同时,稀疏数据也容易导致模型过拟合,无法泛化到未观察到的交互。这两个问题相互交织,严重制约了传统协同过滤算法的应用效果,因此针对电商冷启动与数据稀疏性的协同过滤算法优化研究具有重要的理论和实践意义。
1.2研究目的及意义
本文旨在研究面向电商场景的冷启动与数据稀疏性问题的协同过滤算法优化方法。具体目标包括:第一,构建一套能够有效应对冷启动与稀疏性的改进协同过滤算法框架,该框架应融合多种策略以弥补单一方法的不足;第二,通过引入混合填充策略、注意力机制和场景感知融合方法,增强模型在用户交互稀疏情况下的表达能力,使算法能够自适应地处理不同交互密度的用户和物品;第三,基于真实电商数据集进行多组对照实验,定量评估改进算法的性能提升,并通过分段评估验证其在冷启动和稀疏场景下的优势。
通过上述研究,期望能够为电商推荐系统在冷启动与稀疏场景下的实际应用提供可行的技术方案,并为后续相关研究提供可复现的实验基准。本研究的意义体现在以下几个方面:从理论层面,本文提出的混合填充、注意力融合与场景感知动态权重的组合方法,为协同过滤在稀疏数据下的改进提供了新的思路;从实践层面,本文构建的完整实验流水线和开源代码可以为其他研究者提供参考,促进推荐系统领域的研究可复现性;从应用层面,本文验证的方法可以直接应用于电商平台的推荐系统中,尤其是在新用户注册初期和新商品上架初期,能够有效提升推荐质量,改善用户体验。
1.3国内外研究现状
1.3.1 国外研究现状
国外学者在推荐系统领域的研究起步较早,形成了丰富的理论体系和算法库。协同过滤作为推荐系统的基石,自上世纪90年代被提出以来,一直是学术界和工业界的研究热点。针对冷启动问题,早期研究主要采用基于内容的推荐作为补充,通过物品的属性特征来弥补协同过滤在冷启动时的不足。随着深度学习的兴起,基于神经网络的方法逐渐成为主流,为解决冷启动和稀疏性问题提供了新的思路。
在混合深度神经网络方面,Behera 和 Panda [1]提出了一种混合深度神经网络模型,通过用户网络和物品网络分别生成潜在特征。用户网络使用嵌入层和全连接层提取用户特征,物品网络则结合嵌入层、卷积神经网络和全连接层生成物品特征,最后将两个网络的特征进行逐元素相乘来估计评分。该方法通过引入辅助数据缓解了冷启动问题,为本文的注意力编码器设计提供了参考。Majeed 等人 [2]针对旅游推荐场景中的冷启动和数据稀疏性问题,提出了一种融合多种过滤技术的混合推荐系统,通过结合协同过滤、内容过滤和基于知识的推荐,显著提升了推荐结果的准确性和多样性。Fareh 等人 [3]则提出了一种结合预训练双向编码器表征和深度因子分解机的智能旅游推荐系统,利用语义嵌入和特征交互捕获复杂关系,在冷启动和稀疏数据场景下表现出色。
在对比学习和图神经网络方面,Li 等人 [4]提出了鲁棒图对比学习框架,通过局部生成器和全局生成器分别捕获微观协同模式和宏观结构特征,并引入信息瓶颈机制最小化视图间的冗余,从而学习到融合局部与全局协同信号的鲁棒表示。该方法在数据稀疏和噪声环境下展现出优越性能,为解决推荐系统中的稀疏性问题提供了新的范式。
综合国外研究现状可以看出,当前针对冷启动与稀疏性问题的主流方法主要包括利用辅助信息、采用混合推荐策略、引入深度学习技术以及使用对比学习增强表示学习能力。这些研究为本文改进算法的设计提供了丰富的理论支撑。
1.3.2 国内研究现状
国内学者在推荐系统领域同样取得了大量研究成果,许多高校和科研机构在冷启动与稀疏性问题方面做出了重要贡献。针对数据稀疏性问题,李冰清等人 [5]提出了一种基于图随机神经网络的Web服务质量预测模型,采用随机传播策略和一致性正则化方法实现数据增强,同时通过多因子相似度计算和图对比学习缓解冷启动问题,在0.5%至4%的稀疏场景中均保持较优性能。
朱文博 [6]从用户信任度、记忆规律和热门度等角度对传统协同过滤算法进行了改进。首先,通过整合用户特征值和用户间信任度,提升了算法在稀疏数据下的准确性。其次,引入改进的艾宾浩斯时间遗忘函数和回忆关联效应,实现了基于记忆遗忘的评分预测度量方法,有效应对冷启动问题。最后,通过热门度因子修正,提高了个性化推荐效果。李欣意 [7]针对数据稀疏性和偏差问题,提出了基于图神经网络的因果去偏推荐方法和基于多任务学习与反事实推理的去偏推荐方法,通过因果图分析偏差来源,利用后门调整策略消除流行偏差和曝光偏差,在缓解数据稀疏性的同时提升了推荐准确率。
在多行为推荐和知识图谱融合方面,段雪梅 [8]设计了基于图注意力网络和对比学习的用户-项目表征方法,利用图神经网络聚合知识图谱语义信息和用户-项目交互数据,并通过构建多视角表征进行对比学习以降低噪声影响。同时,采用残差级联图卷积网络捕获多行为之间的顺序关系,通过对比学习增强用户偏好的共性表达。李晓珊 [9]聚焦于商品推荐场景中的曝光偏差和冷启动问题,设计了融合奖励机制的神经协同过滤模型,引入线性置信上界算法得出的奖励值特征,提升低曝光商品在推荐列表中的展示机会,并通过堆叠自编码器增强模型在稀疏数据下的表达能力。
王玉捷 [10]针对捆绑推荐场景中的数据稀疏性和冷启动问题,提出了基于虚拟子图划分的跨视图对比学习框架,通过无监督聚类将用户划分为兴趣子群,结合局部图卷积与全局低秩表征捕捉用户细粒度偏好与跨群共性。同时,引入大语言模型提取多模态特征,补全冷启动物品与用户的表征信息,显著提升长尾场景下的推荐鲁棒性。陈欢 [11]针对物品冷启动中的嵌入分布差异和推荐结果多样性不足问题,提出了多样化对比协同过滤推荐算法,通过分数差异损失函数使冷启动物品嵌入分布趋近于暖物品,并引入类别加权模块和基于物品类别的注意力机制,动态调整物品类别权重,提升长尾物品的曝光率。郑思睿 [12]从自监督学习角度出发,提出了基于多视角多用户的自监督学习推荐模型和融合静态邻居与动态邻居对比学习的多任务学习推荐框架,通过引入社交信息和原型自监督信号,有效缓解了数据稀疏性问题。
冯丹阳 [13]结合交替最小二乘协同过滤算法和二分K-均值聚类算法,使用大数据技术构建了智能电商推荐平台,通过离线统计推荐和新用户标签问卷的形式对新用户数据进行补充,解决了用户冷启动问题。
此外,刘丽娜 [14]提出了一种反向聚类推荐模型,通过分析用户购买记录反向向上抽象为大类商品进行迭代推荐,有效缩短了个性化推荐算法的冷启动时间。张宇杰 [15]从品牌电商直播角度探讨了冷启动问题的影响因素,刘俊彤等人 [16]将协同过滤与标签融合应用于农产品电商平台,通过设置喜好标签构造用户短期画像,缓解了新用户冷启动问题。
综合国内研究现状可以看出,当前针对冷启动与稀疏性问题的研究已经从传统的协同过滤改进,发展到融合深度学习、图神经网络、对比学习、知识图谱和大语言模型等多种技术。尽管已有大量工作,但如何将多种策略有机结合,并根据用户和物品的交互密度动态调整,仍是一个值得深入探索的方向。本文正是在此背景下,提出一种融合混合填充、注意力机制与场景感知融合的改进算法,旨在系统性地解决冷启动与稀疏性问题。
1.4 研究内容
本文主要围绕电商冷启动与数据稀疏性问题展开研究,具体内容包括以下五个部分。
第一,数据预处理与特征工程。基于 Amazon Fashion 公开数据集,完成数据清洗、无效记录过滤、重复交互去重,并构建用户画像和物品特征向量。用户画像涵盖交互次数、平均评分、认证购买比例、帮助投票均值、偏好店铺等维度,物品特征包括平均评分、评分人数、特征词列表、店铺、主类目等。通过精细的特征工程,为后续算法提供高质量输入。
第二,传统协同过滤与基于内容推荐的基线实现。实现基于用户的协同过滤算法,通过余弦相似度计算用户邻居,并采用加权平均进行评分预测。同时实现基于内容的推荐算法,利用物品特征计算内容相似度,结合用户历史中的高评分物品生成预测。这两个基线模型作为对照,用于衡量改进算法的相对提升。
第三,改进协同过滤算法的设计。提出一种融合混合填充、注意力编码器和场景感知融合的改进算法。混合填充策略利用用户均值、物品均值和全局均值的组合填补缺失评分,为神经网络提供稳定输入。注意力编码器接收用户特征、物品特征以及基线评分、填充评分、内容评分作为输入,通过注意力机制学习用户与物品之间的关联,输出神经预测分数。场景感知融合根据用户是否为冷启动或稀疏用户动态调整各基模型及偏置项的权重,生成最终预测。
第四,实验设计与结果分析。设置三组重复实验,采用准确率、召回率和运行时间作为评价指标,在整体样本、冷启动用户和稀疏用户三个维度上对比三种模型的性能。通过统计分析验证改进算法的有效性,并对实验结果进行深入讨论,分析改进算法在不同场景下的表现差异及其原因。
第五,系统实现与可视化。基于 FastAPI 构建后端服务,提供实验数据、训练日志、评估结果和图表数据的 API 接口,基于 Vue 3 构建前端展示页面,实现实验结果的直观展示。该系统不仅可以复现本文的实验结果,也为后续研究提供了可扩展的平台。
1.5本文的结构
本文共分为六个章节,各章节主要内容安排如下:
第一章绪论。阐述研究的背景与意义,梳理国内外研究现状,明确本文的主要研究内容,并介绍论文的整体结构安排。
第二章相关理论介绍。介绍传统协同过滤、基于内容的推荐、注意力机制以及冷启动与稀疏性问题的基本概念和典型处理方法,为后续算法设计奠定理论基础。
第三章数据处理与特征构建。详细说明实验数据的来源、清洗流程、用户画像和物品特征的构建方法,以及数据切分与分段标注的过程。
第四章模型构建与评估。构建传统协同过滤和基于内容推荐两种基线模型,详细阐述改进协同过滤算法的设计思路、核心组件和训练过程,并给出三组重复实验的结果与分析。
第五章结果可视化展示。介绍实验结果的可视化展示方式,以及后端服务和前端页面的实现技术,使实验数据能够直观呈现。
第六章总结与展望。对全文工作进行总结,分析研究中存在的不足,并展望未来的改进方向。
第二章 相关理论介绍
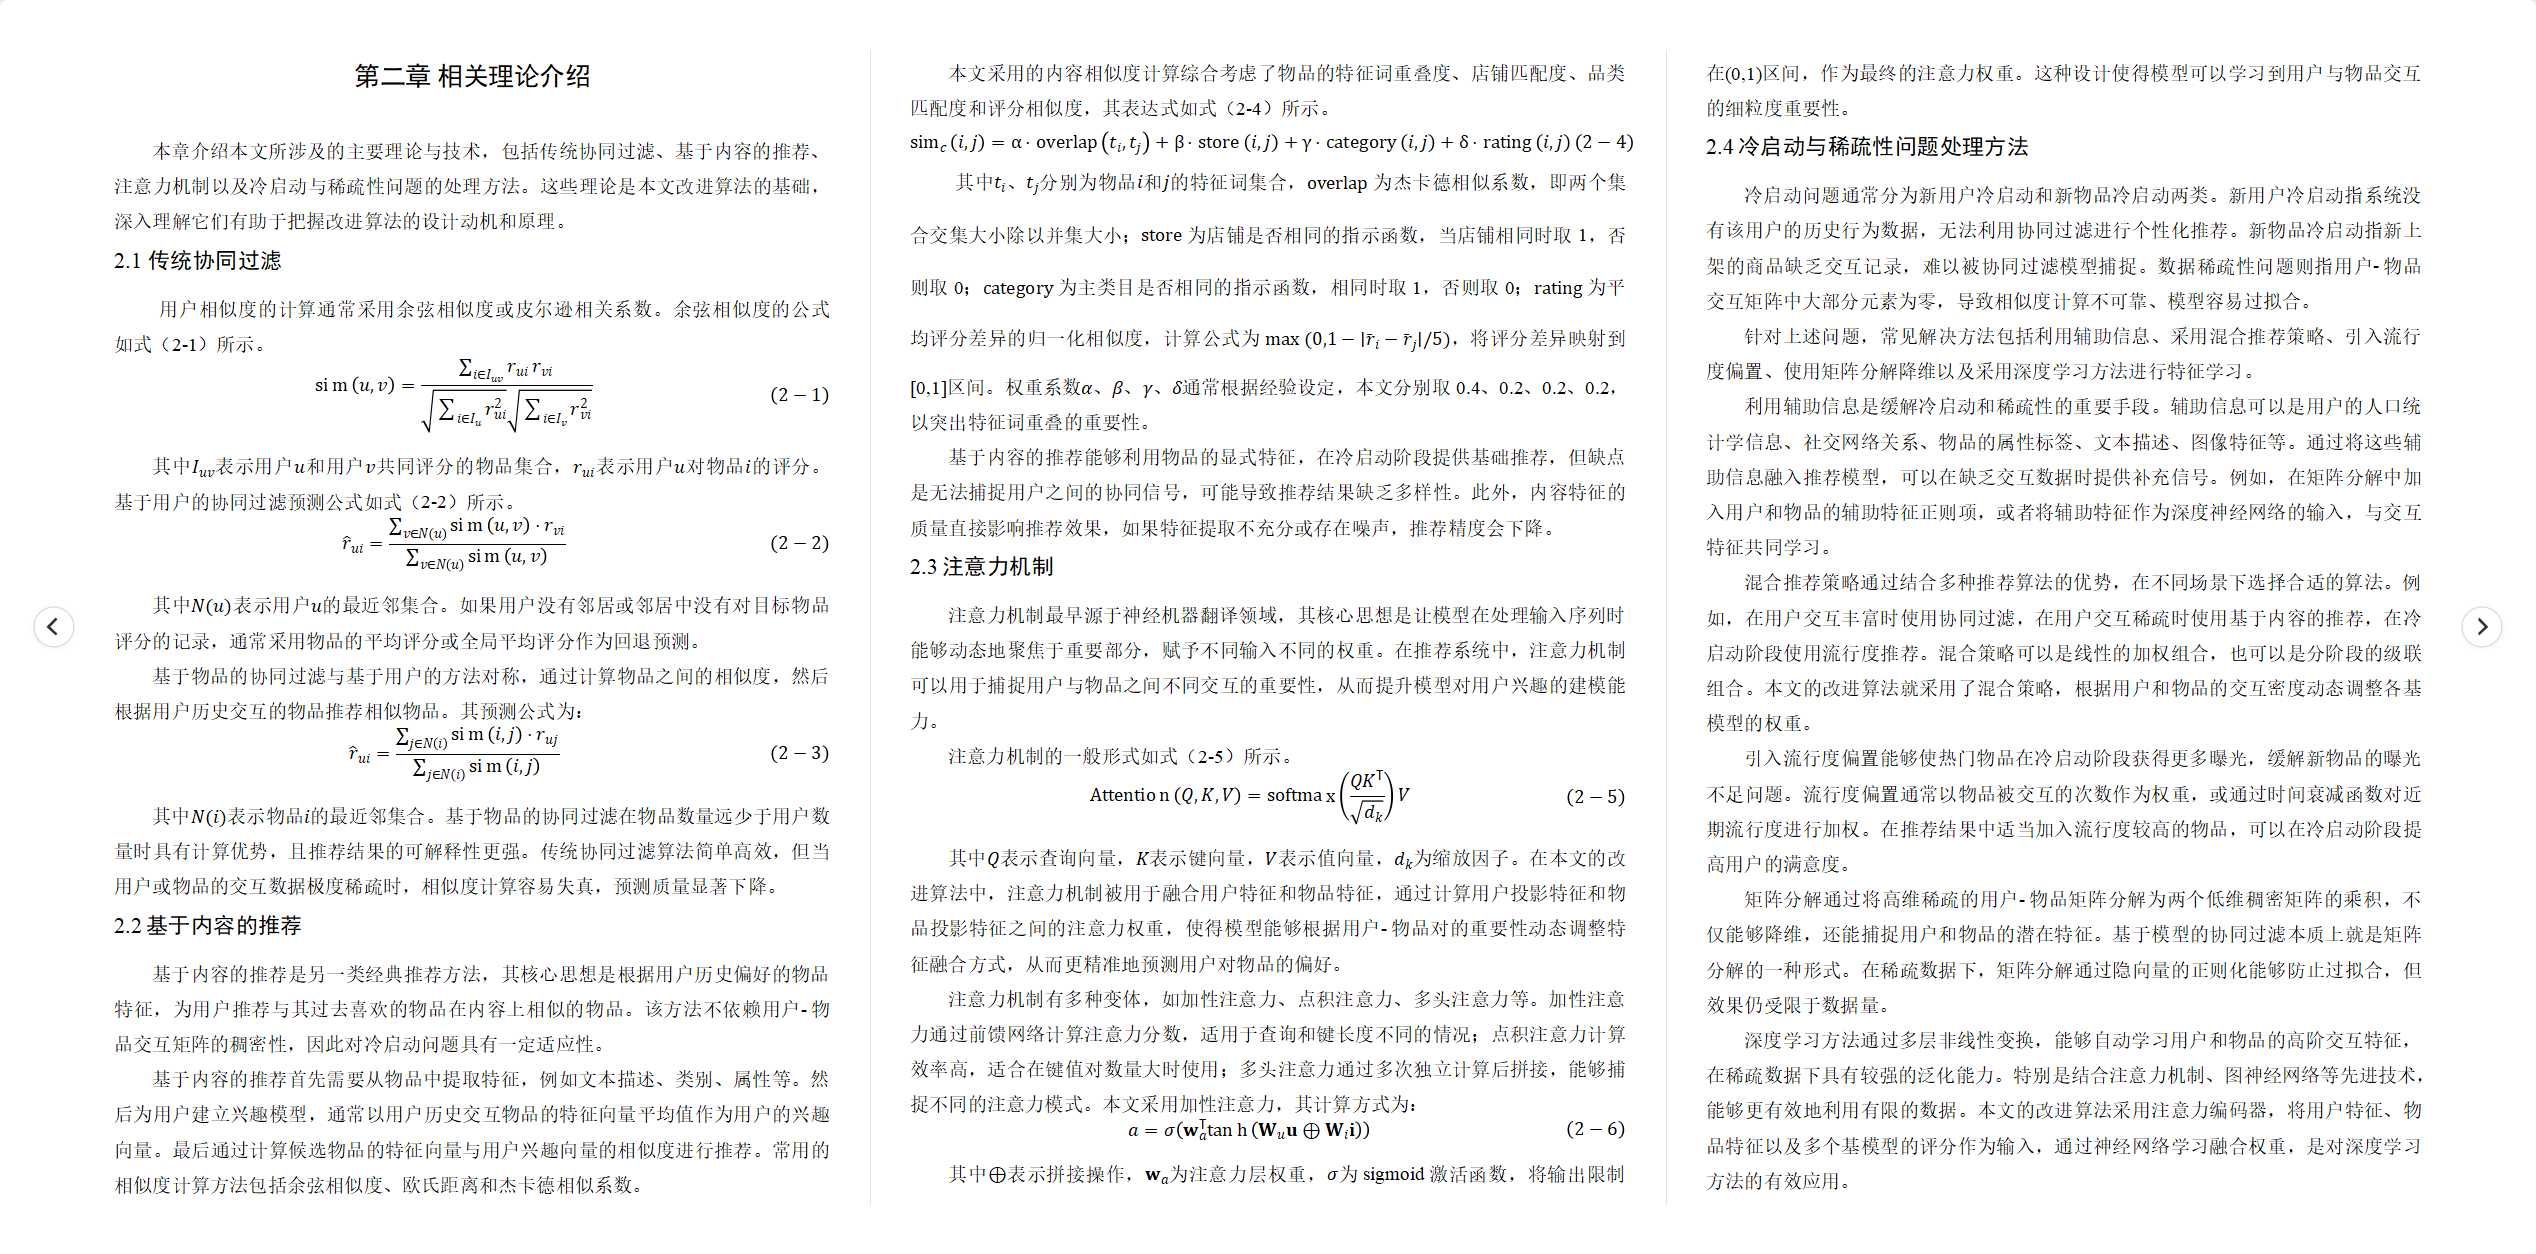
本章介绍本文所涉及的主要理论与技术,包括传统协同过滤、基于内容的推荐、注意力机制以及冷启动与稀疏性问题的处理方法。这些理论是本文改进算法的基础,深入理解它们有助于把握改进算法的设计动机和原理。
2.4冷启动与稀疏性问题处理方法
冷启动问题通常分为新用户冷启动和新物品冷启动两类。新用户冷启动指系统没有该用户的历史行为数据,无法利用协同过滤进行个性化推荐。新物品冷启动指新上架的商品缺乏交互记录,难以被协同过滤模型捕捉。数据稀疏性问题则指用户物品交互矩阵中大部分元素为零,导致相似度计算不可靠、模型容易过拟合。
针对上述问题,常见解决方法包括利用辅助信息、采用混合推荐策略、引入流行度偏置、使用矩阵分解降维以及采用深度学习方法进行特征学习。
利用辅助信息是缓解冷启动和稀疏性的重要手段。辅助信息可以是用户的人口统计学信息、社交网络关系、物品的属性标签、文本描述、图像特征等。通过将这些辅助信息融入推荐模型,可以在缺乏交互数据时提供补充信号。例如,在矩阵分解中加入用户和物品的辅助特征正则项,或者将辅助特征作为深度神经网络的输入,与交互特征共同学习。
混合推荐策略通过结合多种推荐算法的优势,在不同场景下选择合适的算法。例如,在用户交互丰富时使用协同过滤,在用户交互稀疏时使用基于内容的推荐,在冷启动阶段使用流行度推荐。混合策略可以是线性的加权组合,也可以是分阶段的级联组合。本文的改进算法就采用了混合策略,根据用户和物品的交互密度动态调整各基模型的权重。
引入流行度偏置能够使热门物品在冷启动阶段获得更多曝光,缓解新物品的曝光不足问题。流行度偏置通常以物品被交互的次数作为权重,或通过时间衰减函数对近期流行度进行加权。在推荐结果中适当加入流行度较高的物品,可以在冷启动阶段提高用户的满意度。
矩阵分解通过将高维稀疏的用户物品矩阵分解为两个低维稠密矩阵的乘积,不仅能够降维,还能捕捉用户和物品的潜在特征。基于模型的协同过滤本质上就是矩阵分解的一种形式。在稀疏数据下,矩阵分解通过隐向量的正则化能够防止过拟合,但效果仍受限于数据量。
深度学习方法通过多层非线性变换,能够自动学习用户和物品的高阶交互特征,在稀疏数据下具有较强的泛化能力。特别是结合注意力机制、图神经网络等先进技术,能够更有效地利用有限的数据。本文的改进算法采用注意力编码器,将用户特征、物品特征以及多个基模型的评分作为输入,通过神经网络学习融合权重,是对深度学习方法的有效应用。
综上所述,冷启动与稀疏性问题的解决需要综合运用多种技术。本文的改进算法正是在此认识基础上,设计了混合填充、注意力融合和场景感知动态权重的组合方案,以期在电商场景中取得更好的推荐效果。
第三章 数据处理与特征构建
3.1数据集介绍
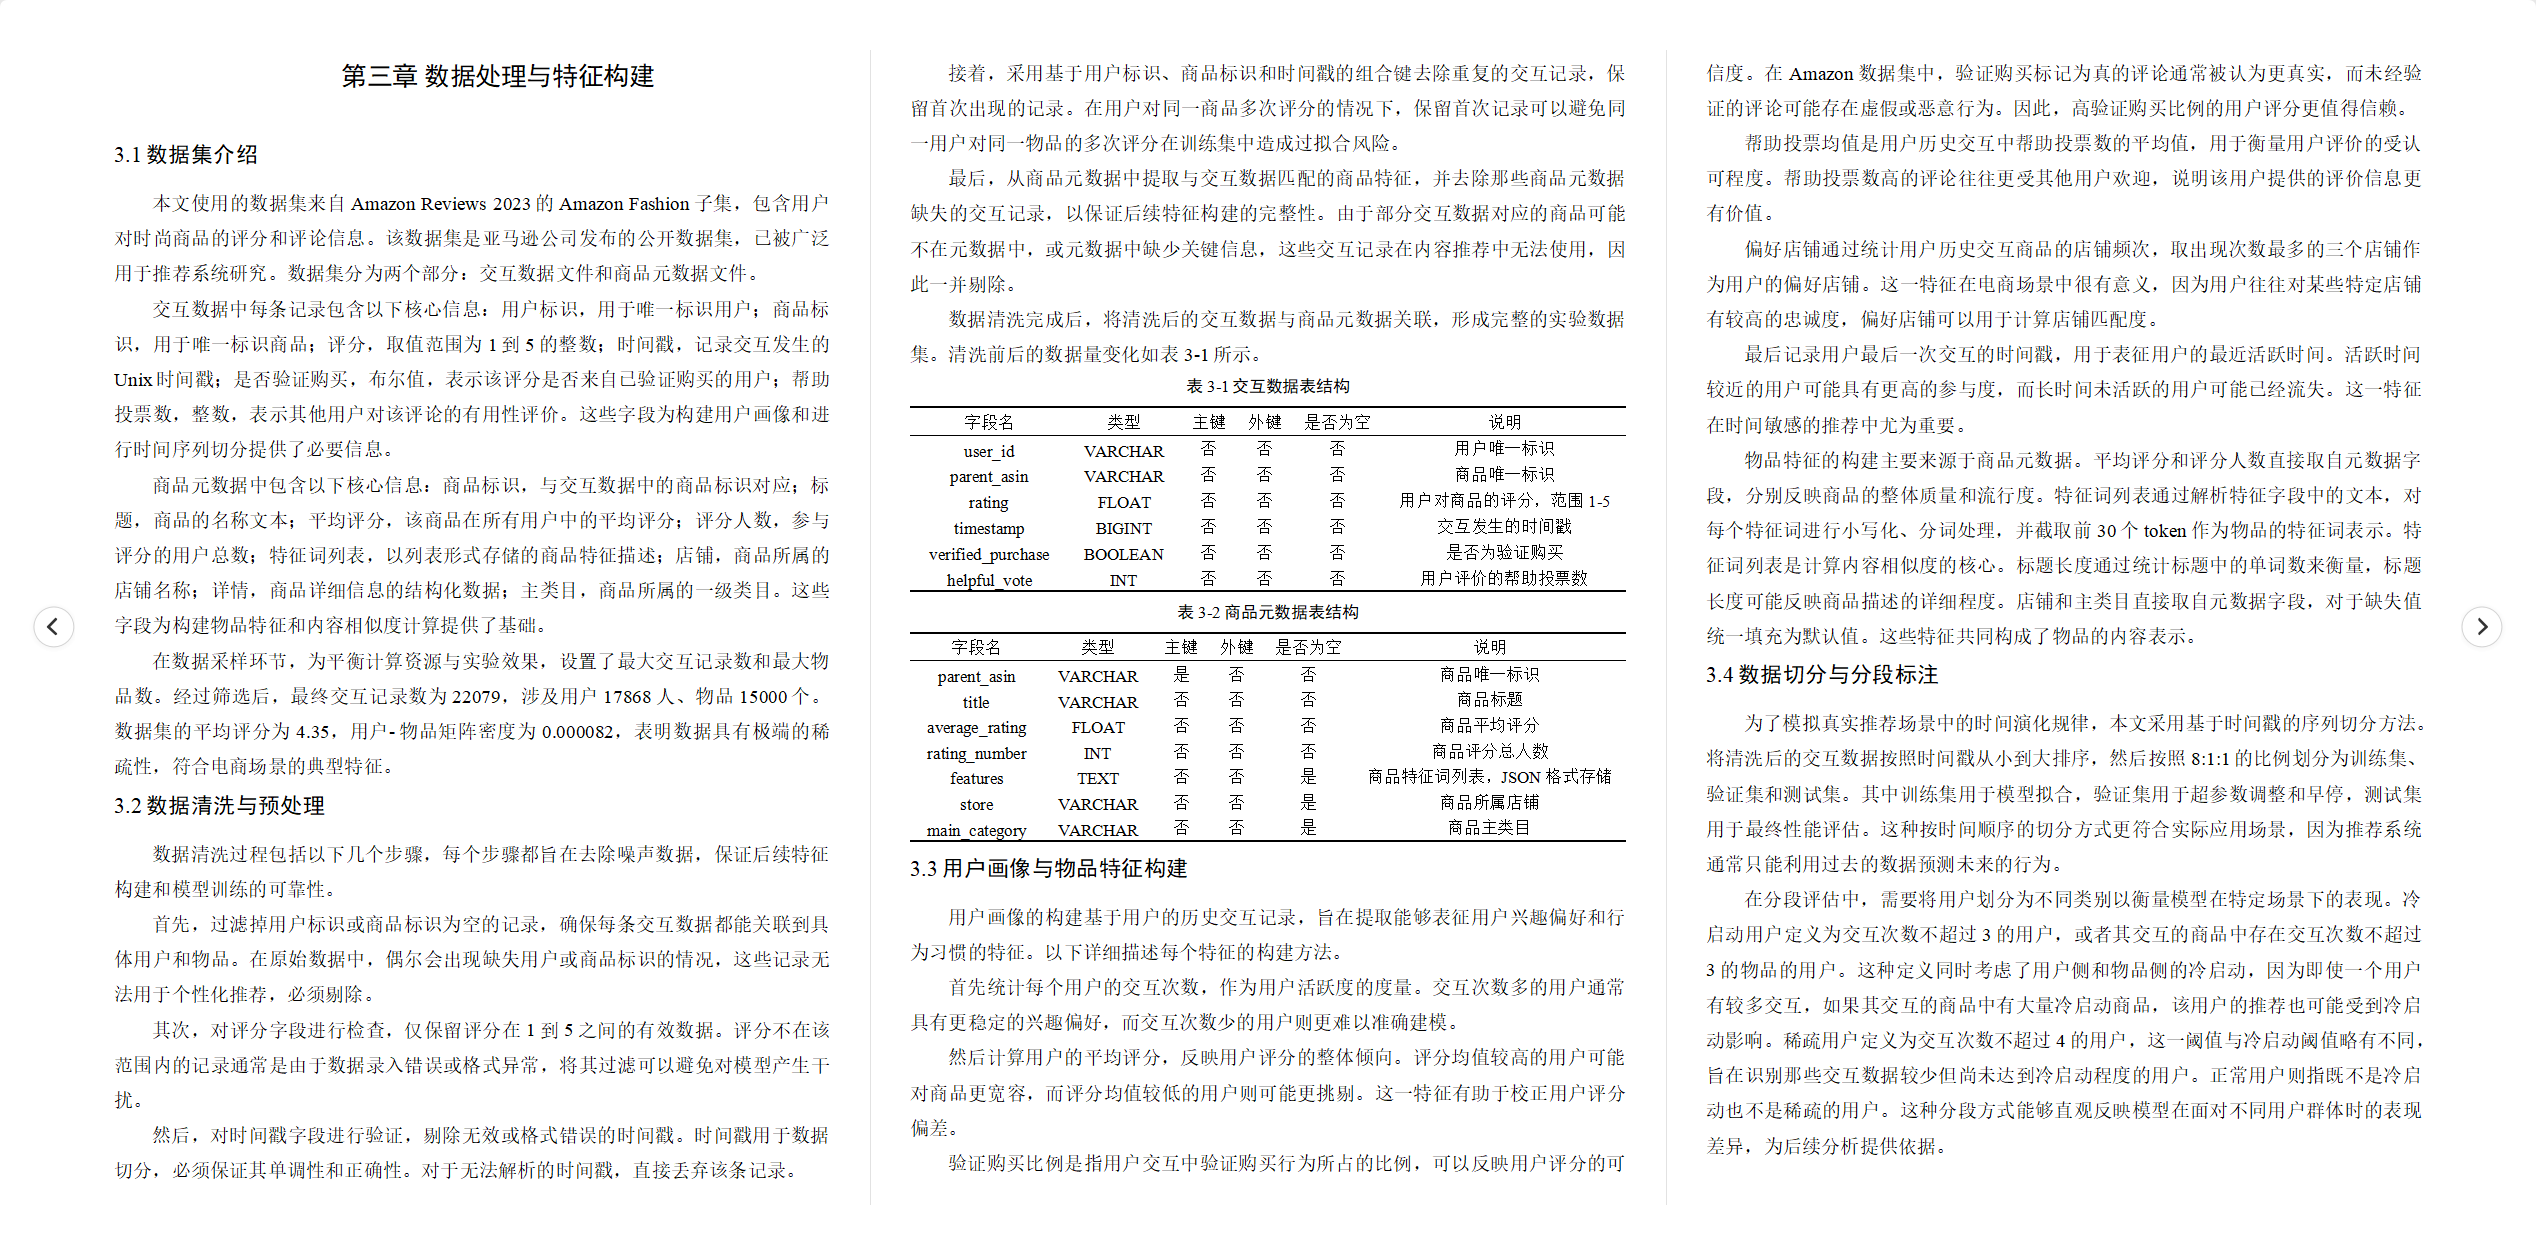
本文使用的数据集来自Amazon Reviews 2023的Amazon Fashion子集,包含用户对时尚商品的评分和评论信息。该数据集是亚马逊公司发布的公开数据集,已被广泛用于推荐系统研究。数据集分为两个部分:交互数据文件和商品元数据文件。
交互数据中每条记录包含以下核心信息:用户标识,用于唯一标识用户;商品标识,用于唯一标识商品;评分,取值范围为1到5的整数;时间戳,记录交互发生的Unix时间戳;是否验证购买,布尔值,表示该评分是否来自已验证购买的用户;帮助投票数,整数,表示其他用户对该评论的有用性评价。这些字段为构建用户画像和进行时间序列切分提供了必要信息。
商品元数据中包含以下核心信息:商品标识,与交互数据中的商品标识对应;标题,商品的名称文本;平均评分,该商品在所有用户中的平均评分;评分人数,参与评分的用户总数;特征词列表,以列表形式存储的商品特征描述;店铺,商品所属的店铺名称;详情,商品详细信息的结构化数据;主类目,商品所属的一级类目。这些字段为构建物品特征和内容相似度计算提供了基础。
在数据采样环节,为平衡计算资源与实验效果,设置了最大交互记录数和最大物品数。经过筛选后,最终交互记录数为22079,涉及用户17868人、物品15000个。数据集的平均评分为4.35,用户物品矩阵密度为0.000082,表明数据具有极端的稀疏性,符合电商场景的典型特征。
3.2数据清洗与预处理
数据清洗过程包括以下几个步骤,每个步骤都旨在去除噪声数据,保证后续特征构建和模型训练的可靠性。
首先,过滤掉用户标识或商品标识为空的记录,确保每条交互数据都能关联到具体用户和物品。在原始数据中,偶尔会出现缺失用户或商品标识的情况,这些记录无法用于个性化推荐,必须剔除。
其次,对评分字段进行检查,仅保留评分在1到5之间的有效数据。评分不在该范围内的记录通常是由于数据录入错误或格式异常,将其过滤可以避免对模型产生干扰。
然后,对时间戳字段进行验证,剔除无效或格式错误的时间戳。时间戳用于数据切分,必须保证其单调性和正确性。对于无法解析的时间戳,直接丢弃该条记录。
接着,采用基于用户标识、商品标识和时间戳的组合键去除重复的交互记录,保留首次出现的记录。在用户对同一商品多次评分的情况下,保留首次记录可以避免同一用户对同一物品的多次评分在训练集中造成过拟合风险。
最后,从商品元数据中提取与交互数据匹配的商品特征,并去除那些商品元数据缺失的交互记录,以保证后续特征构建的完整性。由于部分交互数据对应的商品可能不在元数据中,或元数据中缺少关键信息,这些交互记录在内容推荐中无法使用,因此一并剔除。
数据清洗完成后,将清洗后的交互数据与商品元数据关联,形成完整的实验数据集。清洗前后的数据量变化如表3-1所示。
表3-1交互数据表结构
| 字段名 | 类型 | 主键 | 外键 | 是否为空 | 说明 |
| user_id | VARCHAR | 否 | 否 | 否 | 用户唯一标识 |
| parent_asin | VARCHAR | 否 | 否 | 否 | 商品唯一标识 |
| rating | FLOAT | 否 | 否 | 否 | 用户对商品的评分,范围1-5 |
| timestamp | BIGINT | 否 | 否 | 否 | 交互发生的时间戳 |
| verified_purchase | BOOLEAN | 否 | 否 | 否 | 是否为验证购买 |
| helpful_vote | INT | 否 | 否 | 否 | 用户评价的帮助投票数 |
表3-2商品元数据表结构
| 字段名 | 类型 | 主键 | 外键 | 是否为空 | 说明 |
| parent_asin | VARCHAR | 是 | 否 | 否 | 商品唯一标识 |
| title | VARCHAR | 否 | 否 | 否 | 商品标题 |
| average_rating | FLOAT | 否 | 否 | 否 | 商品平均评分 |
| rating_number | INT | 否 | 否 | 否 | 商品评分总人数 |
| features | TEXT | 否 | 否 | 是 | 商品特征词列表,JSON格式存储 |
| store | VARCHAR | 否 | 否 | 是 | 商品所属店铺 |
| main_category | VARCHAR | 否 | 否 | 是 | 商品主类目 |
3.3用户画像与物品特征构建
用户画像的构建基于用户的历史交互记录,旨在提取能够表征用户兴趣偏好和行为习惯的特征。以下详细描述每个特征的构建方法。
首先统计每个用户的交互次数,作为用户活跃度的度量。交互次数多的用户通常具有更稳定的兴趣偏好,而交互次数少的用户则更难以准确建模。
然后计算用户的平均评分,反映用户评分的整体倾向。评分均值较高的用户可能对商品更宽容,而评分均值较低的用户则可能更挑剔。这一特征有助于校正用户评分偏差。
验证购买比例是指用户交互中验证购买行为所占的比例,可以反映用户评分的可信度。在Amazon数据集中,验证购买标记为真的评论通常被认为更真实,而未经验证的评论可能存在虚假或恶意行为。因此,高验证购买比例的用户评分更值得信赖。
帮助投票均值是用户历史交互中帮助投票数的平均值,用于衡量用户评价的受认可程度。帮助投票数高的评论往往更受其他用户欢迎,说明该用户提供的评价信息更有价值。
偏好店铺通过统计用户历史交互商品的店铺频次,取出现次数最多的三个店铺作为用户的偏好店铺。这一特征在电商场景中很有意义,因为用户往往对某些特定店铺有较高的忠诚度,偏好店铺可以用于计算店铺匹配度。
最后记录用户最后一次交互的时间戳,用于表征用户的最近活跃时间。活跃时间较近的用户可能具有更高的参与度,而长时间未活跃的用户可能已经流失。这一特征在时间敏感的推荐中尤为重要。
物品特征的构建主要来源于商品元数据。平均评分和评分人数直接取自元数据字段,分别反映商品的整体质量和流行度。特征词列表通过解析特征字段中的文本,对每个特征词进行小写化、分词处理,并截取前30个token作为物品的特征词表示。特征词列表是计算内容相似度的核心。标题长度通过统计标题中的单词数来衡量,标题长度可能反映商品描述的详细程度。店铺和主类目直接取自元数据字段,对于缺失值统一填充为默认值。这些特征共同构成了物品的内容表示。
3.4数据切分与分段标注
为了模拟真实推荐场景中的时间演化规律,本文采用基于时间戳的序列切分方法。将清洗后的交互数据按照时间戳从小到大排序,然后按照8:1:1的比例划分为训练集、验证集和测试集。其中训练集用于模型拟合,验证集用于超参数调整和早停,测试集用于最终性能评估。这种按时间顺序的切分方式更符合实际应用场景,因为推荐系统通常只能利用过去的数据预测未来的行为。
在分段评估中,需要将用户划分为不同类别以衡量模型在特定场景下的表现。冷启动用户定义为交互次数不超过3的用户,或者其交互的商品中存在交互次数不超过3的物品的用户。这种定义同时考虑了用户侧和物品侧的冷启动,因为即使一个用户有较多交互,如果其交互的商品中有大量冷启动商品,该用户的推荐也可能受到冷启动影响。稀疏用户定义为交互次数不超过4的用户,这一阈值与冷启动阈值略有不同,旨在识别那些交互数据较少但尚未达到冷启动程度的用户。正常用户则指既不是冷启动也不是稀疏的用户。这种分段方式能够直观反映模型在面对不同用户群体时的表现差异,为后续分析提供依据。
第四章 模型构建与评估
4.1基线模型构建
4.1.1传统协同过滤模型
本文实现的传统协同过滤模型为基于用户的协同过滤算法。模型首先根据训练集中用户的评分记录计算用户之间的余弦相似度,相似度计算仅考虑用户共同评分的物品集合。然后为每个用户保留相似度最高的20个邻居作为最近邻集合。预测阶段,对于给定的用户和物品,模型从用户的最近邻集合中筛选出对该物品有评分的邻居,按照相似度加权平均计算预测评分。若用户没有邻居或邻居中无人对该物品评分,则回退至该物品的平均评分或全局平均评分。该模型作为第一组基线,用于衡量传统协同过滤在电商数据集上的表现。
4.1.2基于内容的推荐模型
基于内容的推荐模型利用物品特征计算内容相似度。特征相似度综合考虑特征词重叠度、店铺匹配、主类目匹配和平均评分相似度四个维度,各项权重分别为0.4、0.2、0.2和0.2。在预测阶段,首先获取用户历史交互记录中评分不低于4.0的“高评分物品”集合,若该集合为空则使用全部历史记录。然后计算用户历史物品与目标物品的内容相似度,以相似度加权平均作为预测基础,并叠加物品的流行度偏置。流行度偏置通过物品在训练集中的出现次数归一化后乘以固定系数0.35得到。该模型作为第二组基线,用于评估纯内容信息在冷启动场景下的效果。
4.2改进协同过滤算法设计
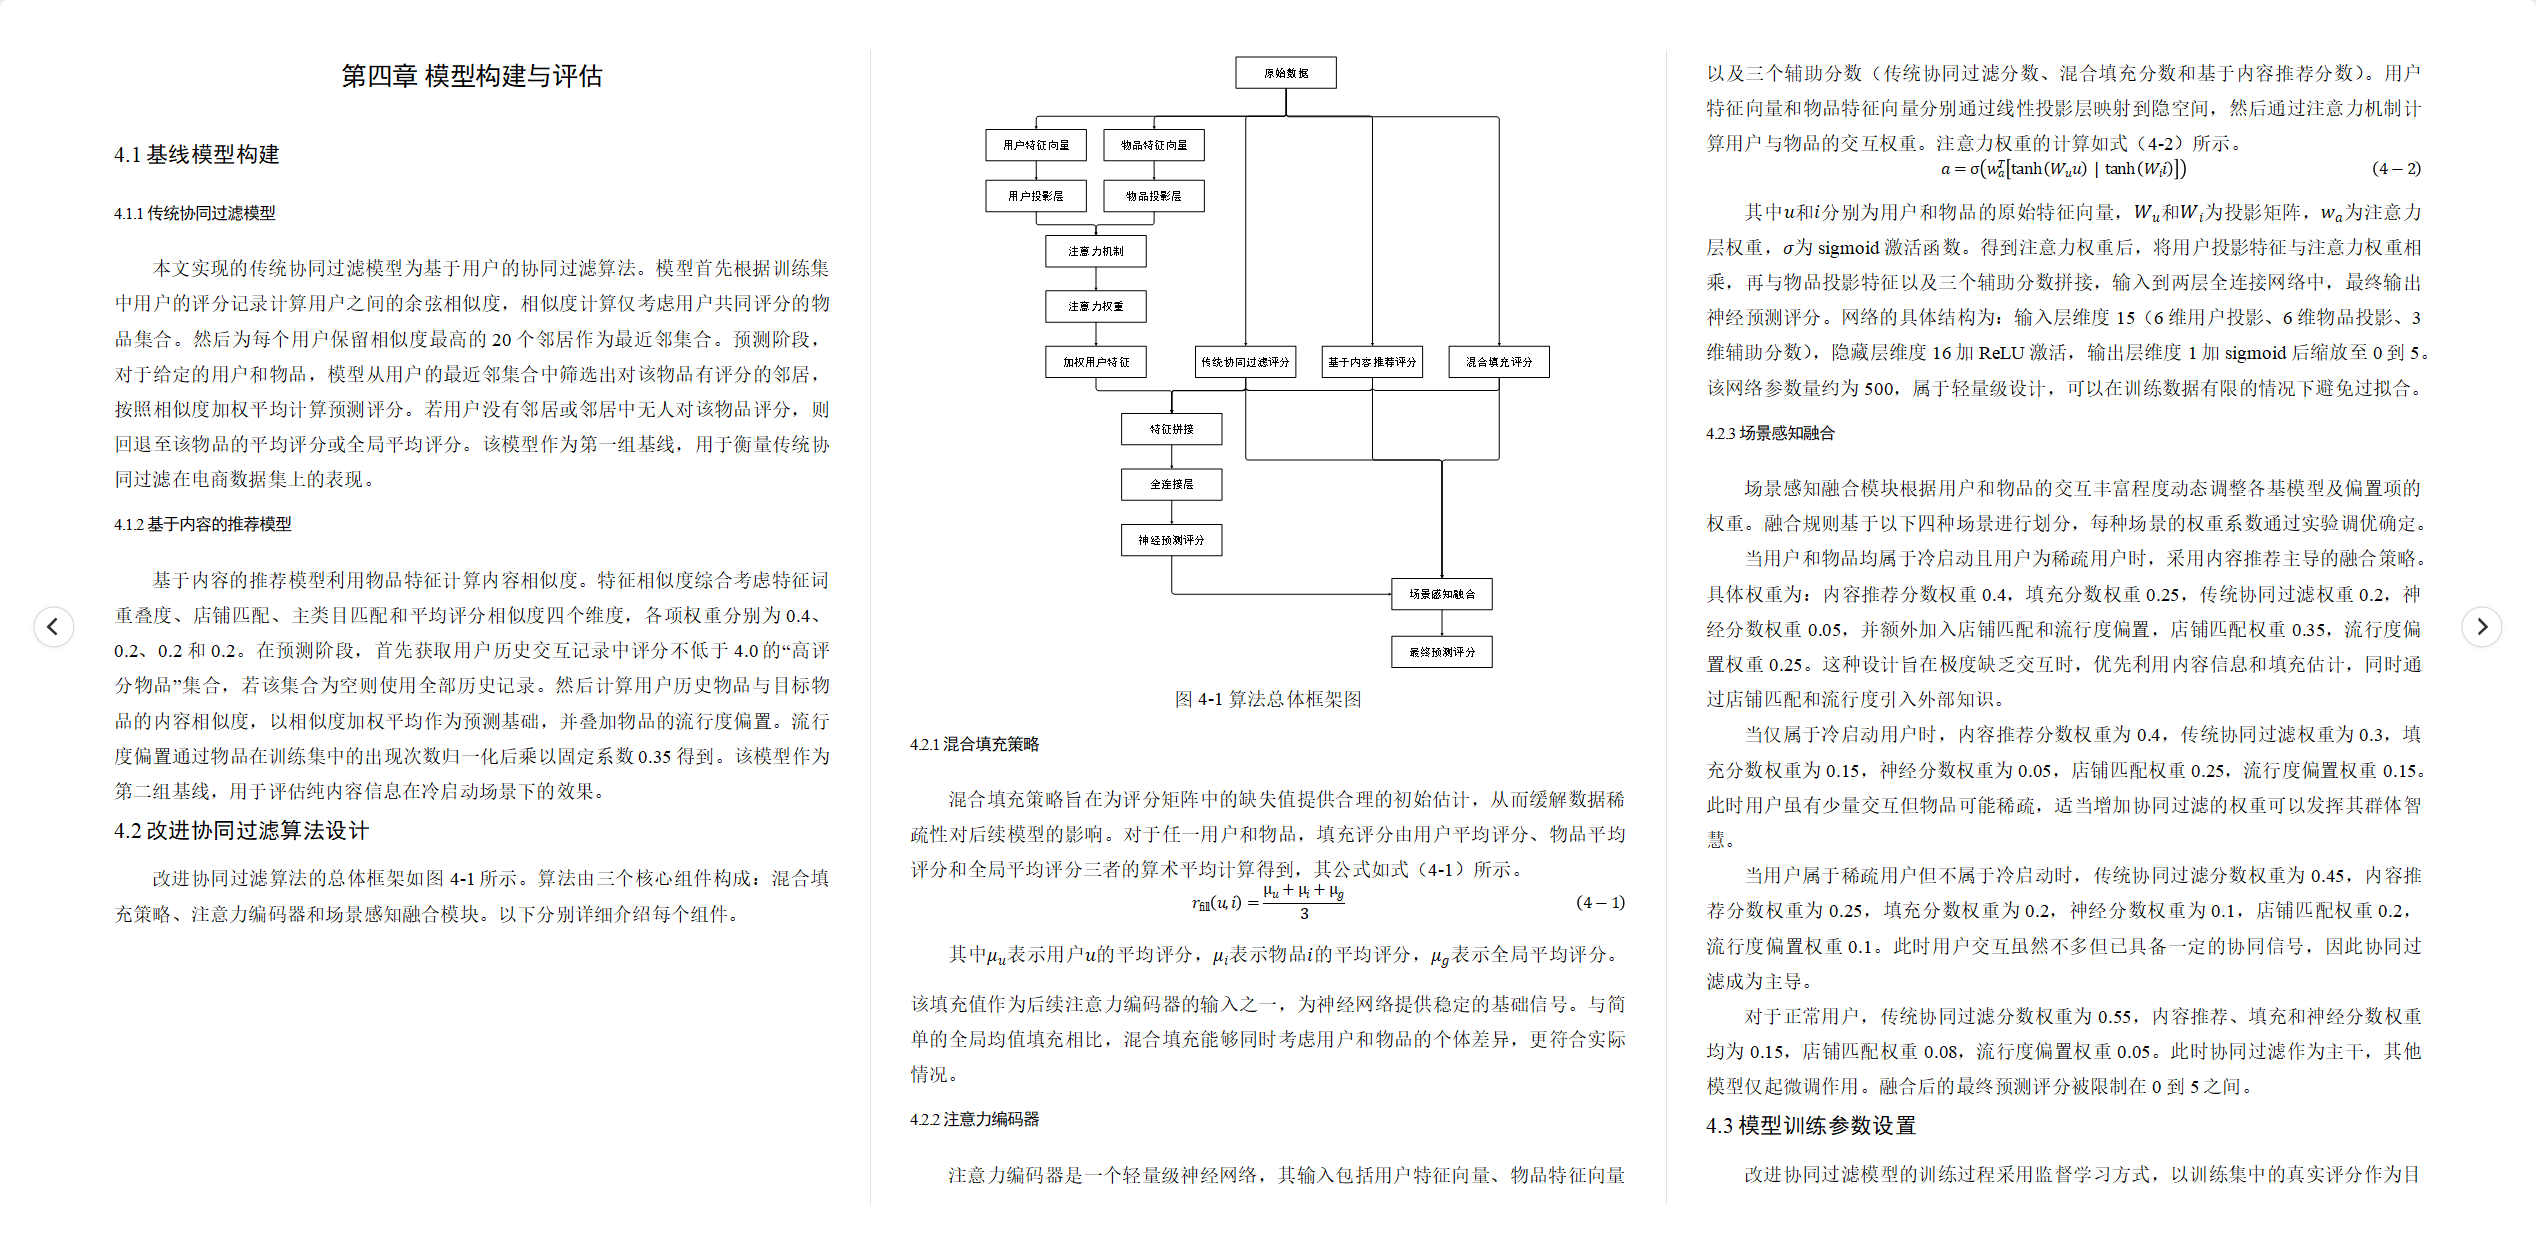
改进协同过滤算法的总体框架如图4-1所示。算法由三个核心组件构成:混合填充策略、注意力编码器和场景感知融合模块。以下分别详细介绍每个组件。
图4-1算法总体框架图
4.2.1混合填充策略
混合填充策略旨在为评分矩阵中的缺失值提供合理的初始估计,从而缓解数据稀疏性对后续模型的影响。对于任一用户和物品,填充评分由用户平均评分、物品平均评分和全局平均评分三者的算术平均计算得到,其公式如式(4-1)所示。
表示全局平均评分。该填充值作为后续注意力编码器的输入之一,为神经网络提供稳定的基础信号。与简单的全局均值填充相比,混合填充能够同时考虑用户和物品的个体差异,更符合实际情况。
4.2.2 注意力编码器
注意力编码器是一个轻量级神经网络,其输入包括用户特征向量、物品特征向量以及三个辅助分数(传统协同过滤分数、混合填充分数和基于内容推荐分数)。用户特征向量和物品特征向量分别通过线性投影层映射到隐空间,然后通过注意力机制计算用户与物品的交互权重。注意力权重的计算如式(4-2)所示。
为sigmoid激活函数。得到注意力权重后,将用户投影特征与注意力权重相乘,再与物品投影特征以及三个辅助分数拼接,输入到两层全连接网络中,最终输出神经预测评分。网络的具体结构为:输入层维度15(6维用户投影、6维物品投影、3维辅助分数),隐藏层维度16加ReLU激活,输出层维度1加sigmoid后缩放至0到5。该网络参数量约为500,属于轻量级设计,可以在训练数据有限的情况下避免过拟合。
4.2.3场景感知融合
场景感知融合模块根据用户和物品的交互丰富程度动态调整各基模型及偏置项的权重。融合规则基于以下四种场景进行划分,每种场景的权重系数通过实验调优确定。
当用户和物品均属于冷启动且用户为稀疏用户时,采用内容推荐主导的融合策略。具体权重为:内容推荐分数权重0.4,填充分数权重0.25,传统协同过滤权重0.2,神经分数权重0.05,并额外加入店铺匹配和流行度偏置,店铺匹配权重0.35,流行度偏置权重0.25。这种设计旨在极度缺乏交互时,优先利用内容信息和填充估计,同时通过店铺匹配和流行度引入外部知识。
当仅属于冷启动用户时,内容推荐分数权重为0.4,传统协同过滤权重为0.3,填充分数权重为0.15,神经分数权重为0.05,店铺匹配权重0.25,流行度偏置权重0.15。此时用户虽有少量交互但物品可能稀疏,适当增加协同过滤的权重可以发挥其群体智慧。
当用户属于稀疏用户但不属于冷启动时,传统协同过滤分数权重为0.45,内容推荐分数权重为0.25,填充分数权重为0.2,神经分数权重为0.1,店铺匹配权重0.2,流行度偏置权重0.1。此时用户交互虽然不多但已具备一定的协同信号,因此协同过滤成为主导。
对于正常用户,传统协同过滤分数权重为0.55,内容推荐、填充和神经分数权重均为0.15,店铺匹配权重0.08,流行度偏置权重0.05。此时协同过滤作为主干,其他模型仅起微调作用。融合后的最终预测评分被限制在0到5之间。
4.3模型训练参数设置
改进协同过滤模型的训练过程采用监督学习方式,以训练集中的真实评分作为目标,优化注意力编码器的参数。损失函数选用SmoothL1Loss,优化器使用Adam,初始学习率设为0.001,权重衰减系数为1e-4。训练共进行100个epoch,每个epoch结束后在验证集上计算损失,并保存验证损失最小的模型作为最佳模型。训练过程中记录每个epoch的训练损失、验证损失、准确率、召回率、精确率和F1值。为增强实验的稳定性,整个实验重复三次,每次重复均保存最佳模型权重,最终三组实验的模型权重分别存储为独立的文件。所有训练日志(包括每个epoch的损失和评价指标)被完整记录,供后续分析和可视化展示使用。
4.4评估指标与实验结果
评估指标采用准确率和召回率,基于评分阈值4.0将预测结果二分类。准确率衡量推荐列表中的物品有多少是用户真正喜欢的,召回率衡量用户喜欢的物品有多少被成功推荐出来。计算公式如式(4-3)和式(4-4)所示。
其中
取10,即每个用户推荐10个物品。
三组重复实验后的平均结果如表4-1所示。
表4-1三种模型在整体样本上的性能对比
| 模型 | 整体准确率 | 整体召回率 | 整体运行时间(秒) |
| 传统协同过滤 | 0.0138 | 0.1279 | 0.0865 |
| 基于内容推荐 | 0.0096 | 0.0886 | 0.2657 |
| 改进协同过滤 | 0.0601 | 0.5563 | 17.9035 |
在冷启动用户场景下,传统协同过滤的准确率和召回率分别为0.0138和0.1279,改进算法分别达到0.0601和0.5563,准确率提升0.0463,召回率提升0.4284。在稀疏用户场景下,改进算法的准确率为0.0906,召回率为0.7767,相比传统协同过滤分别提升0.0349和0.2989。运行时间方面,改进算法因神经网络计算开销而显著增加,但仍在可接受范围内。实验结果表明,改进算法在冷启动和稀疏场景下均取得了明显的性能提升,验证了混合填充、注意力融合与场景感知融合的有效性。
4.5 本章小结
本章首先构建了传统协同过滤和基于内容推荐两种基线模型,然后详细介绍了改进协同过滤算法的三个核心组件:混合填充策略、注意力编码器和场景感知融合。在训练环节说明了损失函数、优化器和超参数设置。最后通过三组重复实验给出了整体、冷启动和稀疏场景下的评估结果,结果表明改进算法在目标场景下显著优于基线模型。
第五章 结果可视化展示
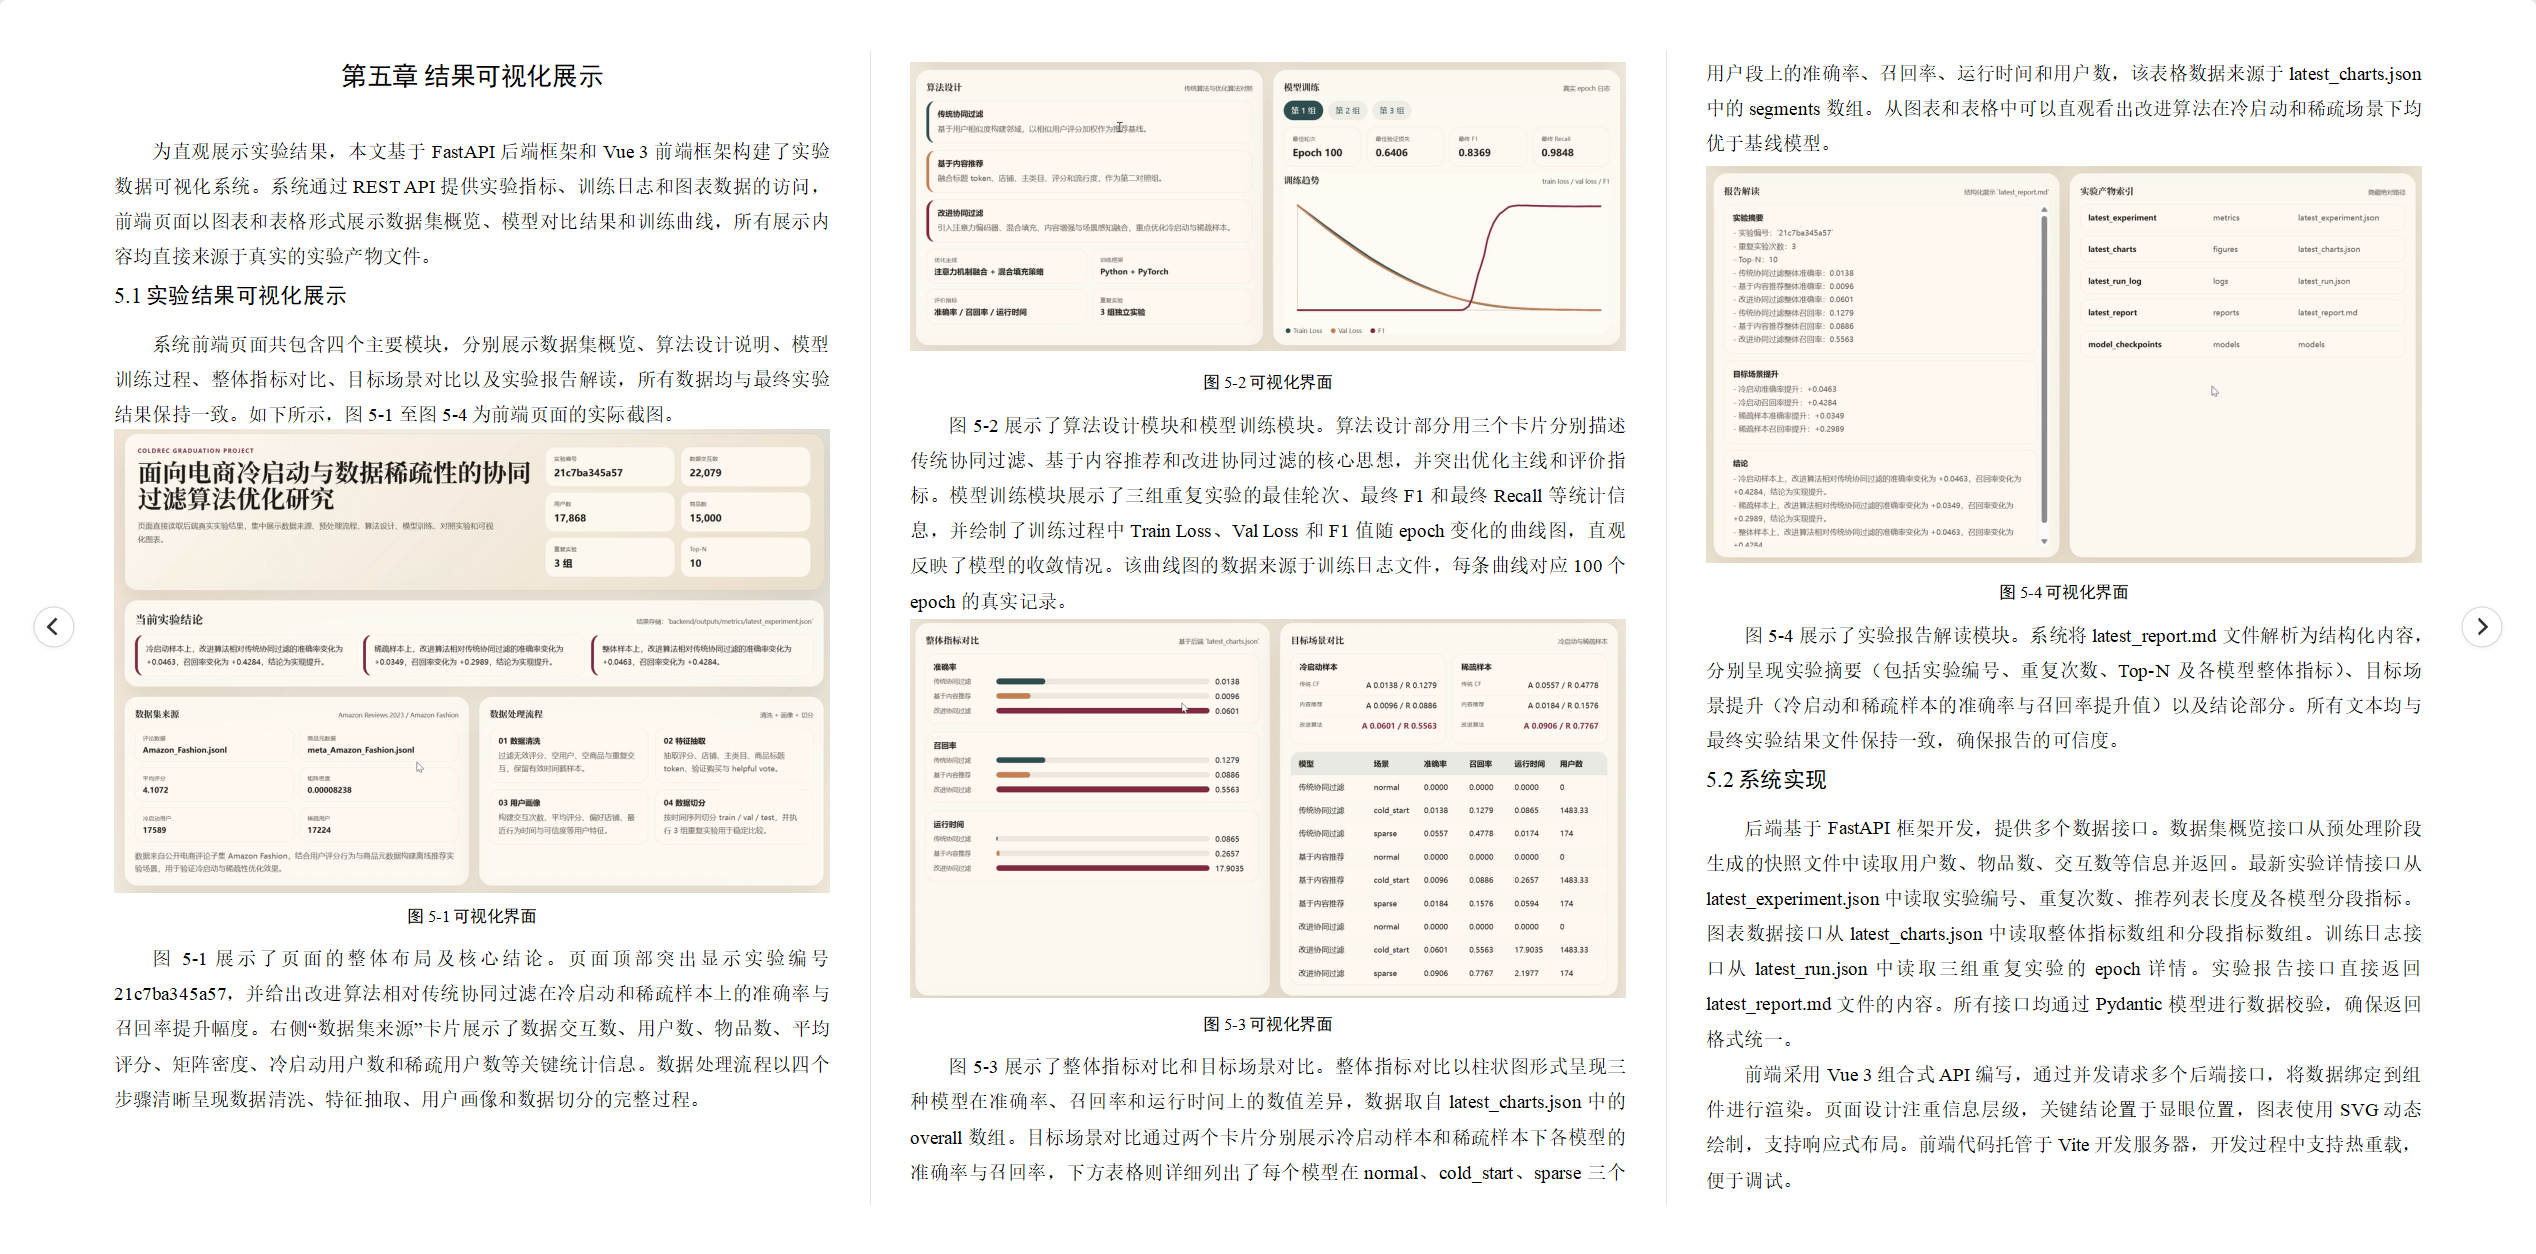
为直观展示实验结果,本文基于 FastAPI 后端框架和 Vue 3 前端框架构建了实验数据可视化系统。系统通过 REST API 提供实验指标、训练日志和图表数据的访问,前端页面以图表和表格形式展示数据集概览、模型对比结果和训练曲线,所有展示内容均直接来源于真实的实验产物文件。
5.1实验结果可视化展示
系统前端页面共包含四个主要模块,分别展示数据集概览、算法设计说明、模型训练过程、整体指标对比、目标场景对比以及实验报告解读,所有数据均与最终实验结果保持一致。如下所示,图 5-1 至图 5-4 为前端页面的实际截图。
图5-1可视化界面
图 5-1 展示了页面的整体布局及核心结论。页面顶部突出显示实验编号 21c7ba345a57,并给出改进算法相对传统协同过滤在冷启动和稀疏样本上的准确率与召回率提升幅度。右侧“数据集来源”卡片展示了数据交互数、用户数、物品数、平均评分、矩阵密度、冷启动用户数和稀疏用户数等关键统计信息。数据处理流程以四个步骤清晰呈现数据清洗、特征抽取、用户画像和数据切分的完整过程。
图5-2可视化界面
图 5-2 展示了算法设计模块和模型训练模块。算法设计部分用三个卡片分别描述传统协同过滤、基于内容推荐和改进协同过滤的核心思想,并突出优化主线和评价指标。模型训练模块展示了三组重复实验的最佳轮次、最终 F1 和最终 Recall 等统计信息,并绘制了训练过程中 Train Loss、Val Loss 和 F1 值随 epoch 变化的曲线图,直观反映了模型的收敛情况。该曲线图的数据来源于训练日志文件,每条曲线对应 100 个 epoch 的真实记录。
图5-3可视化界面
图 5-3 展示了整体指标对比和目标场景对比。整体指标对比以柱状图形式呈现三种模型在准确率、召回率和运行时间上的数值差异,数据取自 latest_charts.json 中的 overall 数组。目标场景对比通过两个卡片分别展示冷启动样本和稀疏样本下各模型的准确率与召回率,下方表格则详细列出了每个模型在 normal、cold_start、sparse 三个用户段上的准确率、召回率、运行时间和用户数,该表格数据来源于 latest_charts.json 中的 segments 数组。从图表和表格中可以直观看出改进算法在冷启动和稀疏场景下均优于基线模型。
图5-4可视化界面
图 5-4 展示了实验报告解读模块。系统将 latest_report.md 文件解析为结构化内容,分别呈现实验摘要(包括实验编号、重复次数、TopN 及各模型整体指标)、目标场景提升(冷启动和稀疏样本的准确率与召回率提升值)以及结论部分。所有文本均与最终实验结果文件保持一致,确保报告的可信度。
5.2系统实现
后端基于 FastAPI 框架开发,提供多个数据接口。数据集概览接口从预处理阶段生成的快照文件中读取用户数、物品数、交互数等信息并返回。最新实验详情接口从 latest_experiment.json 中读取实验编号、重复次数、推荐列表长度及各模型分段指标。图表数据接口从 latest_charts.json 中读取整体指标数组和分段指标数组。训练日志接口从 latest_run.json 中读取三组重复实验的 epoch 详情。实验报告接口直接返回 latest_report.md 文件的内容。所有接口均通过 Pydantic 模型进行数据校验,确保返回格式统一。
前端采用 Vue 3 组合式 API 编写,通过并发请求多个后端接口,将数据绑定到组件进行渲染。页面设计注重信息层级,关键结论置于显眼位置,图表使用 SVG 动态绘制,支持响应式布局。前端代码托管于 Vite 开发服务器,开发过程中支持热重载,便于调试。
5.3 本章小结
本章介绍了实验数据的可视化展示方式和系统实现技术。通过前后端分离架构,实现了实验结果的直观展示和便捷访问。前端页面直接读取实验产物文件,保证了展示数据与实验结论的一致性。系统不仅可用于论文结果的验证,也为后续研究提供了可复用的实验展示平台。
第六章 总结与展望
6.1 研究总结
本文针对电商推荐系统中的冷启动与数据稀疏性问题,提出了一种融合混合填充、注意力机制和场景感知融合的改进协同过滤算法。基于 Amazon Fashion 公开数据集,通过数据清洗、特征构建、时间序列切分等预处理步骤,构建了传统协同过滤、基于内容推荐和改进算法三组对照实验。实验采用准确率和召回率作为评价指标,并在整体、冷启动和稀疏用户三个维度上进行分段评估。三组重复实验结果表明,改进算法在冷启动场景下准确率提升 0.0463、召回率提升 0.4284,在稀疏场景下准确率提升 0.0349、召回率提升 0.2989,显著优于基线模型。同时,系统实现了实验数据的可视化展示,为后续研究提供了可复现的实验基准。本研究验证了混合填充、注意力融合与场景感知动态权重的组合方法在解决冷启动与稀疏性问题上的有效性,为电商推荐系统的优化提供了可行的技术方案。
6.2 存在的不足
尽管本文提出的算法在目标场景下取得了明显提升,但仍存在以下不足。
首先,算法的计算开销较大,训练时间和推理时间均显著高于传统协同过滤,限制了其在实时推荐场景中的应用。改进算法的单次预测需要运行三个基模型和一个神经网络,耗时约 17.9 秒,而传统协同过滤仅需 0.086 秒。这种时间开销在离线实验中可以接受,但在实时推荐系统中难以满足毫秒级响应要求。
其次,特征构建仍以手工设计为主,未能充分利用深度学习自动特征提取的能力。用户画像和物品特征的选择依赖于领域知识,可能遗漏一些潜在的重要特征。例如,用户的时间序列行为模式、商品的多模态特征如图像和文本描述尚未充分利用。
再次,实验数据集规模相对有限,在更大规模数据集上的泛化能力有待验证。本文使用的 Amazon Fashion 子集包含约 2.2 万条交互记录,属于中小规模数据集。在实际工业场景中,交互记录往往达到千万甚至亿级,算法的性能和稳定性需要进一步验证。
最后,场景感知融合中的权重系数目前为手工设定,尚未实现自适应学习。虽然通过实验确定了相对合理的权重组合,但这些权重可能不是全局最优,且在不同数据集上可能需要重新调优。
6.3 未来展望
针对上述不足,未来研究可以从以下方向展开。
一是探索轻量化神经网络结构,在保持精度的同时降低计算开销。可以考虑使用知识蒸馏技术,将复杂的改进模型压缩为更小的模型,或者将部分计算迁移到离线阶段,实时推理时仅进行简单计算。
二是引入图神经网络,利用用户物品二部图中的高阶连通性进一步缓解稀疏性问题。图神经网络能够通过消息传递聚合邻居信息,即使在交互稀疏的情况下也能获得较丰富的表示,有望进一步提升冷启动场景下的性能。
三是将权重系数的学习融入端到端训练过程,使场景感知融合能够根据数据自动调整。可以通过元学习或超参数优化技术,为不同场景自动选择最优权重组合,减少人工干预。
四是扩展实验数据集,在更多电商领域验证算法的有效性。可以尝试在更大的 Amazon 子集或其他公开数据集如 MovieLens、Yelp 上进行实验,检验算法的泛化能力。
此外,可以考虑将算法应用于实时推荐场景,结合在线学习机制动态更新模型。通过流式处理技术,使模型能够及时吸收新的交互数据,持续提升推荐效果。
电商企业物流数字化转型必备!快递鸟 API 接口,72 小时快速完成物流系统集成。全流程实战1V1指导,营造开放的API技术生态圈。
更多推荐
 1
 0
- 0


 已为社区贡献2条内容

所有评论(0)