【有源码】基于Hadoop的电商客户画像与盈利能力数据仓库及可视化分析 面向电商客户细分的盈利能力可视化分析平台
注意:该项目只展示部分功能,如需了解,文末咨询即可。
1 开发环境
发语言:python
采用技术:Spark、Hadoop、Django、Vue、Echarts等技术框架
数据库:MySQL
开发环境:PyCharm
2 系统设计
基于Hadoop的电商客户画像与盈利能力数据仓库及可视化分析项目研究内容围绕电商客户细分与盈利能力分析展开,以原始电商客户细分数据集为数据基础,构建从 HDFS 上传、Spark 预处理到十五项 Spark 分析的完整流程。预处理阶段对客户细分、细分品类、年龄段、性别、国家、城市、收入档、学历、就业类型、婚姻状况、购买频率、购物渠道、设备、支付方式、满意度、忠诚等级、客户价值类别、活跃状态、健康状态、流失风险类别、客户分层、盈利类别、参与度、行为细分、设备偏好、终身价值类别等类别字段进行中文化映射,对三个偏好品类中的字面 None 进行保留,对社交字段中的字面 None 兜底为“未记录”,并对平均客单价、总花费、客户终身价值、客户获取成本、客户盈利能力、邮件打开率、点击率、转化率等字段进行数值化与两位小数处理。分析阶段通过分组聚合、占比计算、频繁项集与关联规则挖掘、K均值聚类等方法,形成十五项可落盘的分析结果,为电商客户细分、盈利能力评估和可视化展示提供数据基础。
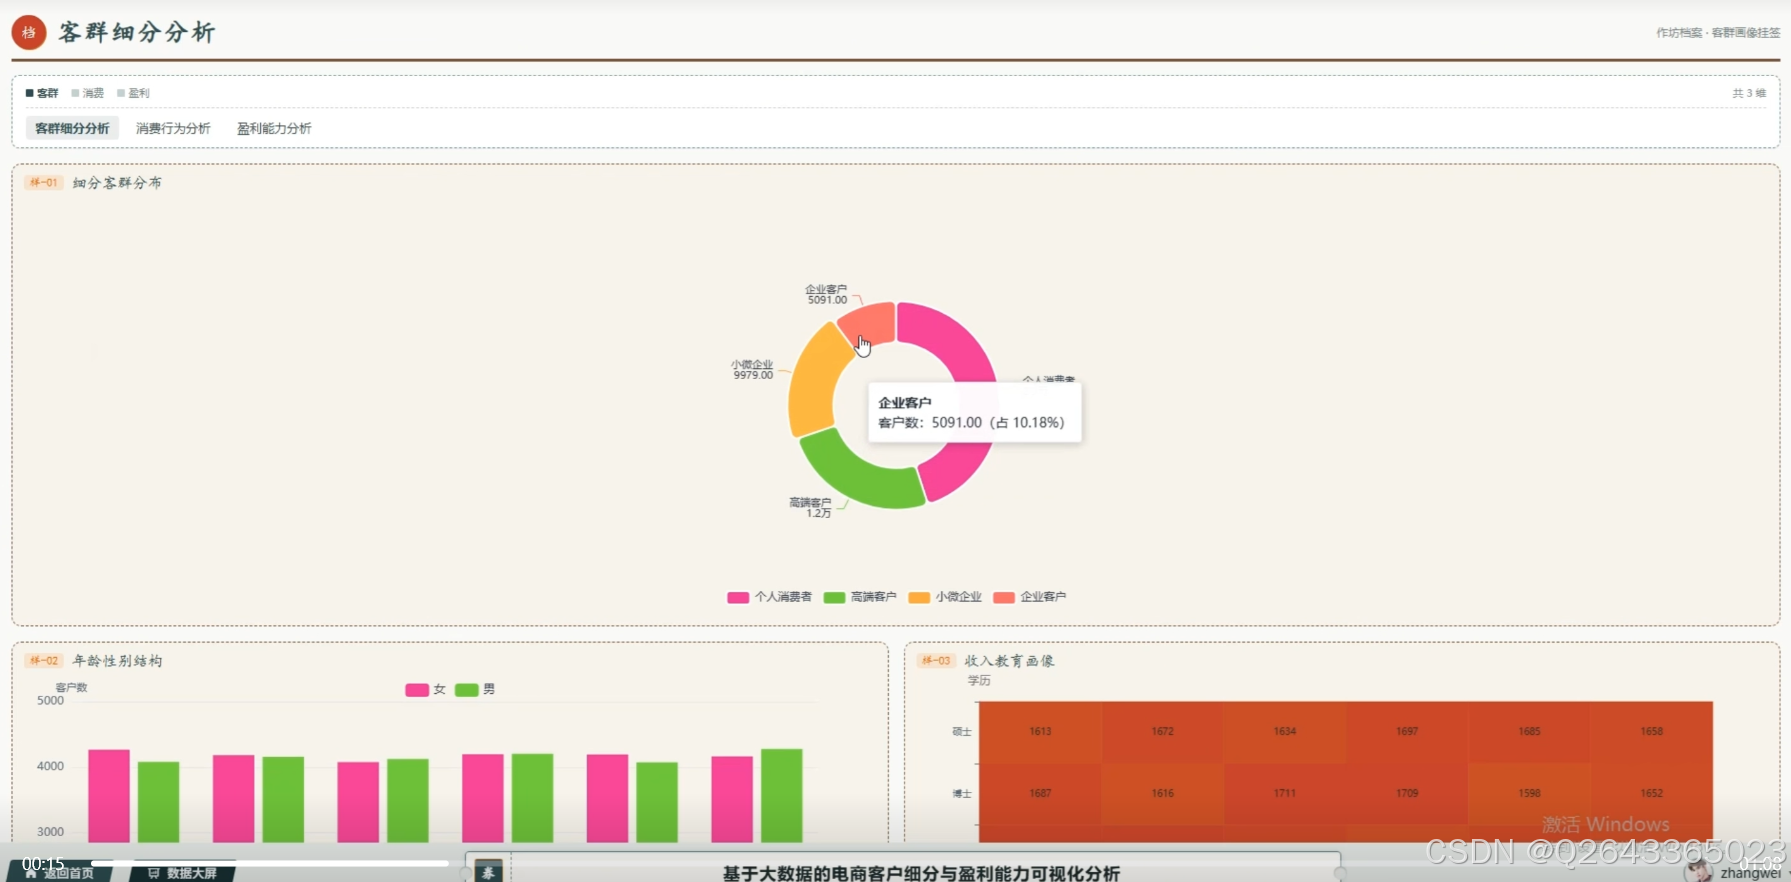
细分客群分布分析:按客户细分分组统计客户数量与占比,并按客户数量降序排列,用于观察不同业务客群的规模结构。
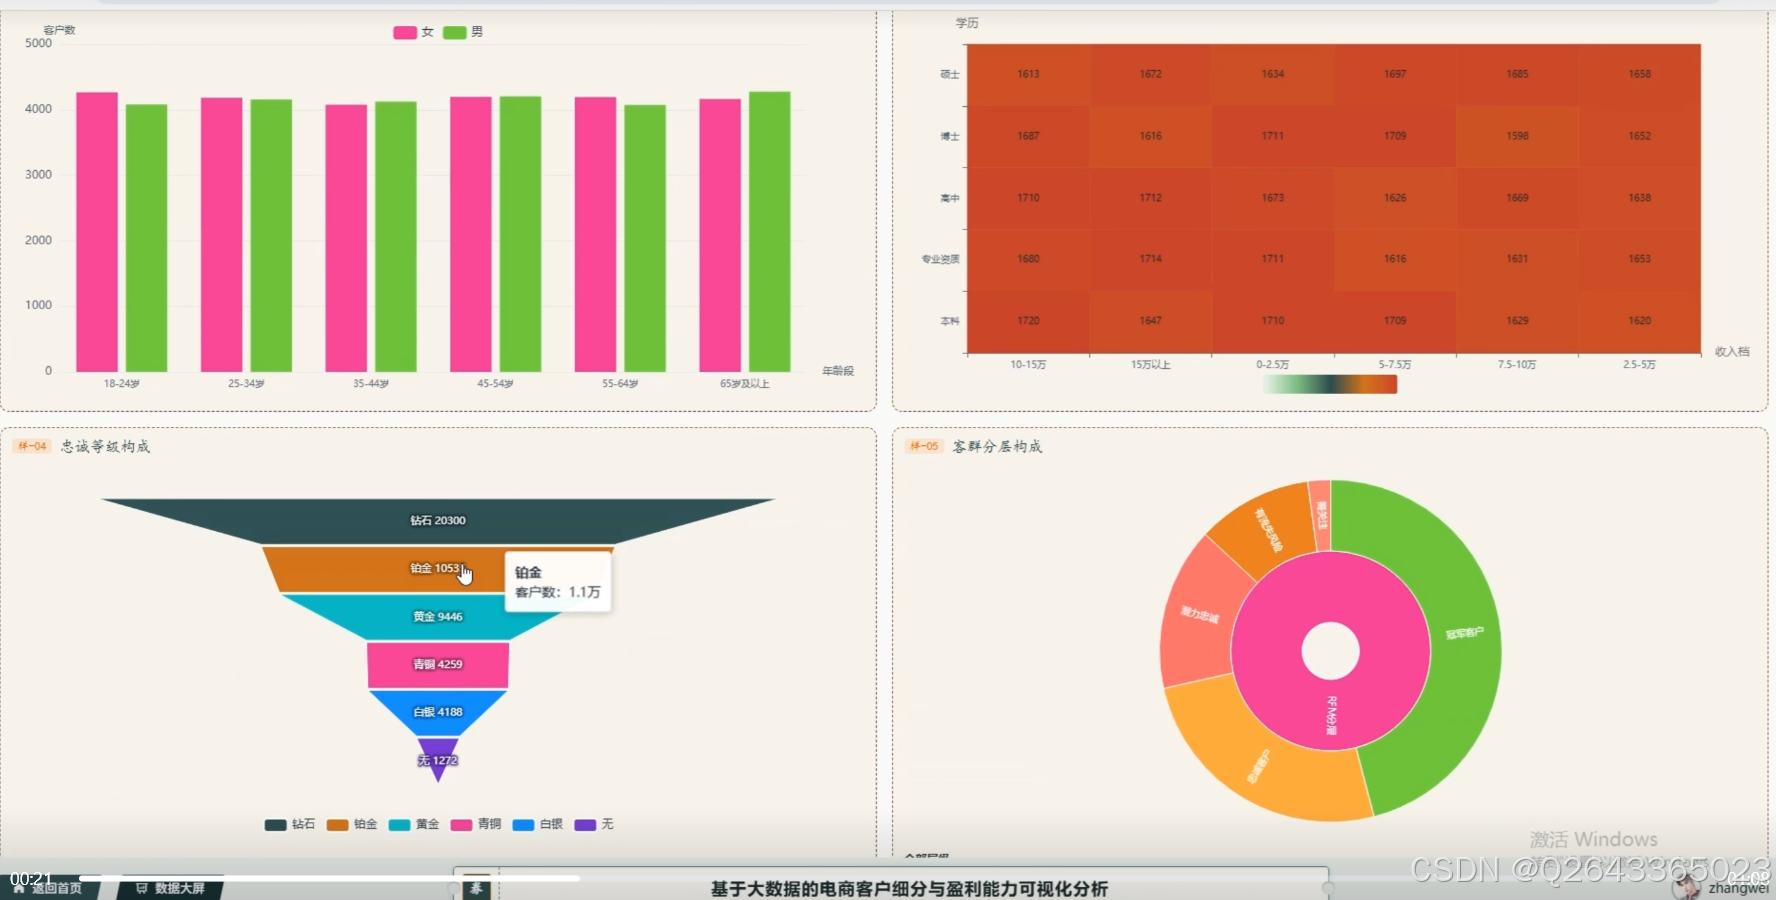
年龄性别结构分析:按年龄段与性别交叉分组,统计各年龄段与性别组合下的客户数量和占比,用于刻画客户人口结构。
收入教育画像分析:按收入档与学历组合统计客户数量与占比,用于分析收入档与学历层次的组合分布。
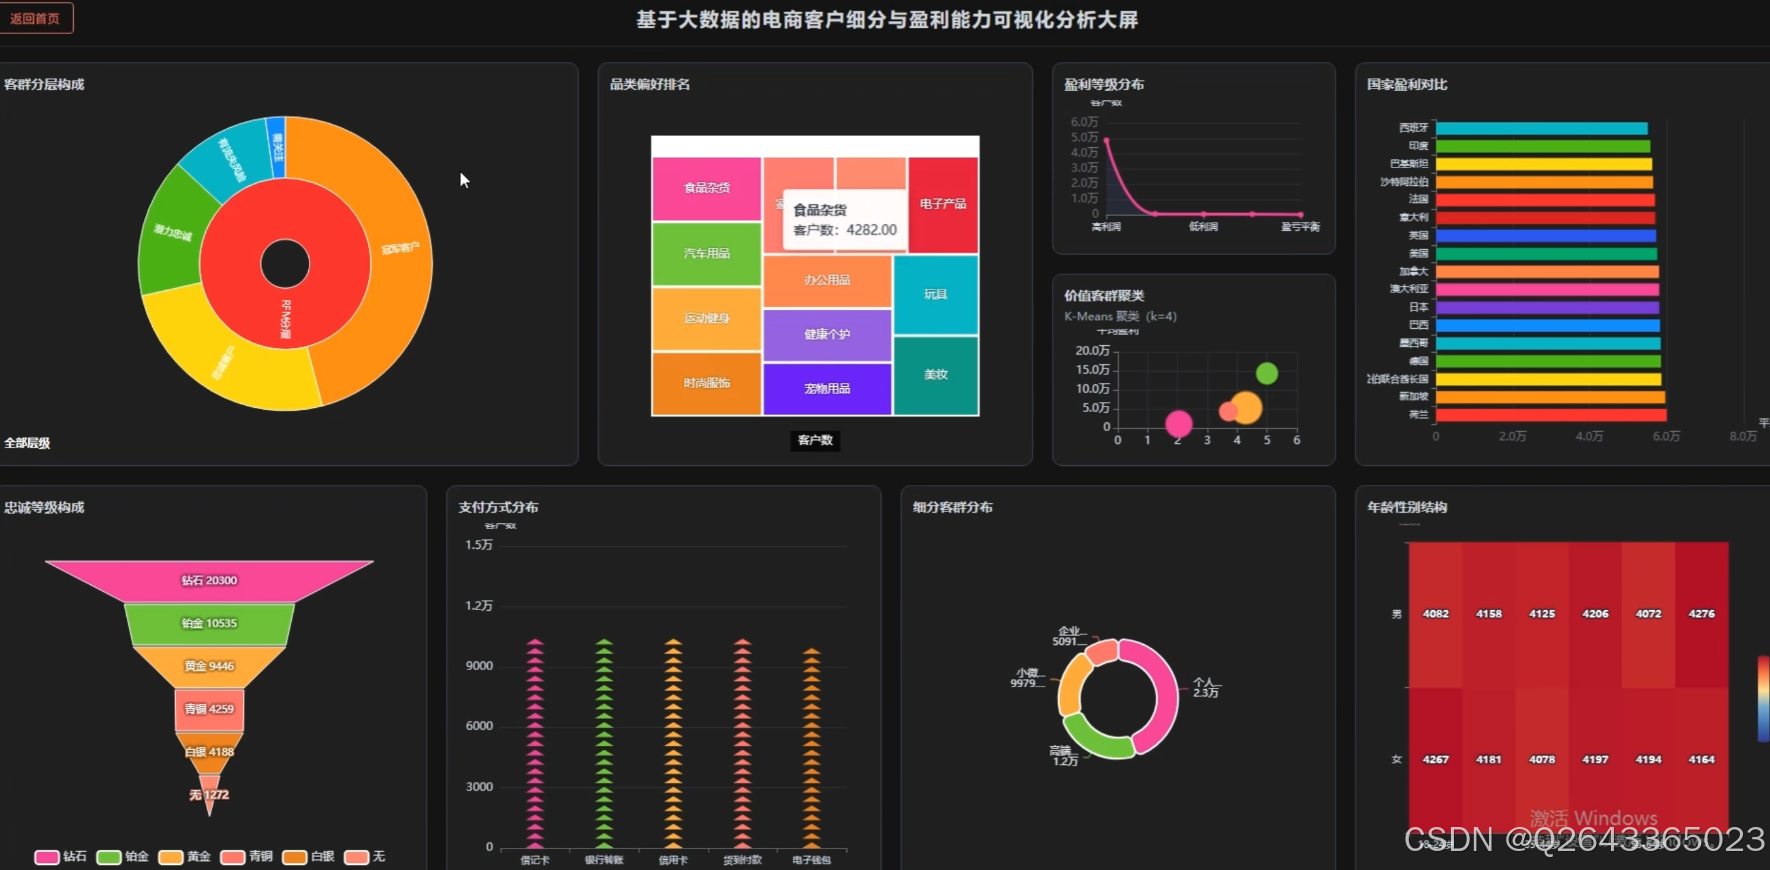
忠诚等级构成分析:按忠诚等级统计客户数量与占比,包含映射后的“无”类别,用于观察客户忠诚等级构成。
客群分层构成分析:按客户分层统计客户数量与占比,用于分析冠军客户、忠诚客户、潜力忠诚、有流失风险、需关注等分层规模。
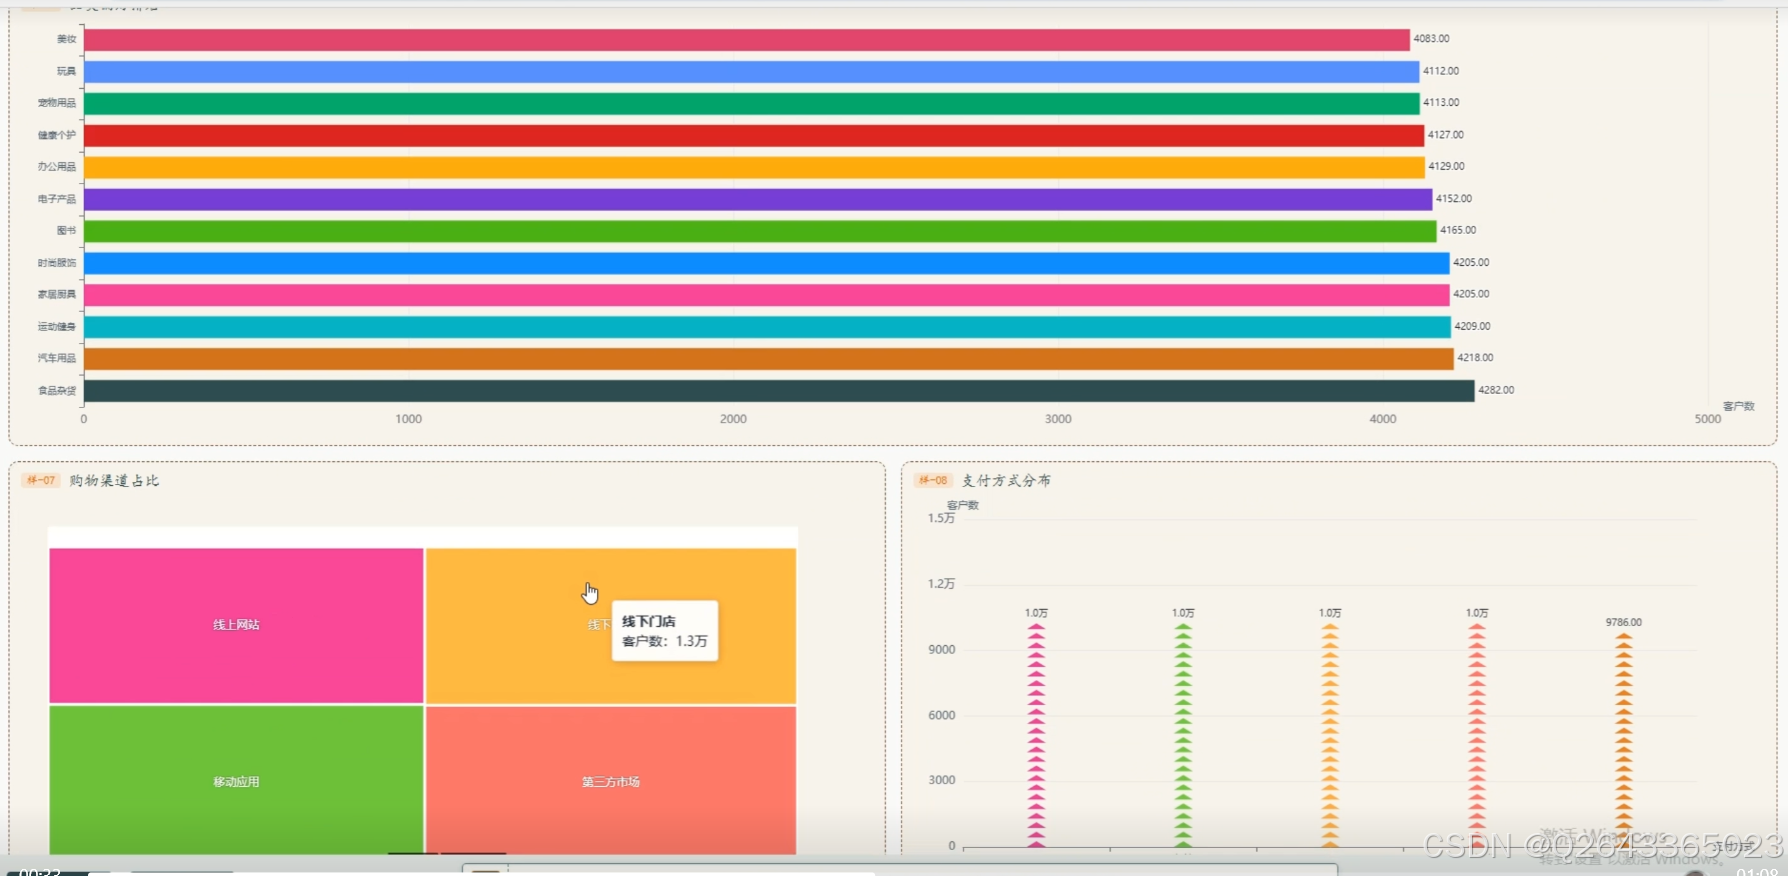
品类偏好排名分析:按首选品类统计客户数量与占比并降序排列,用于识别首选品类热度。
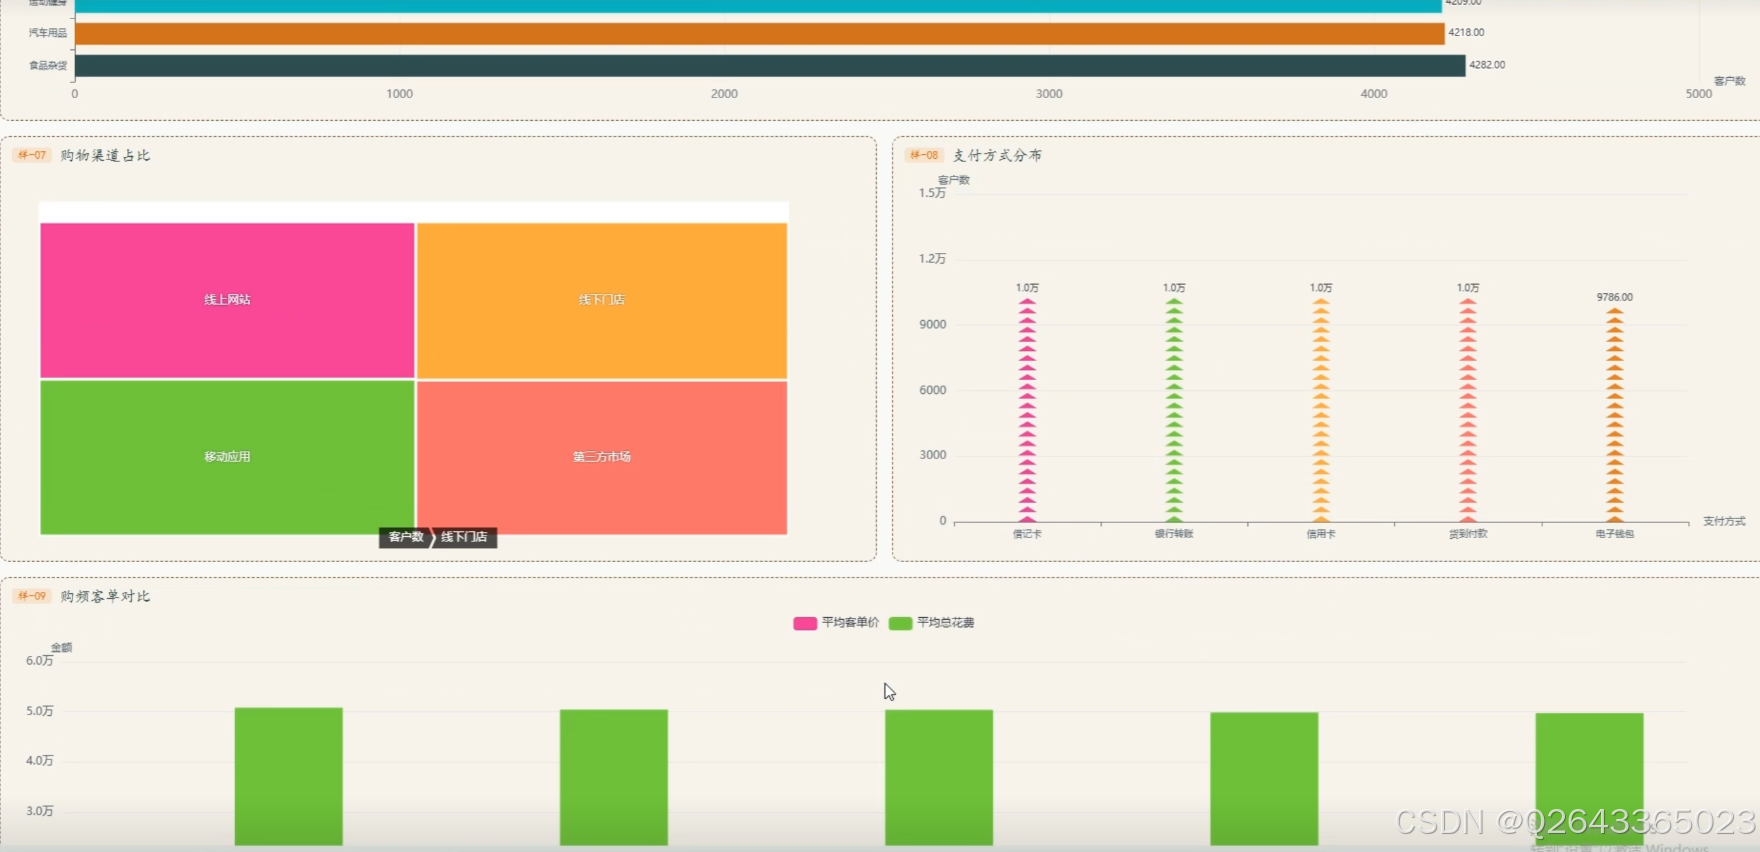
购物渠道占比分析:按购物渠道统计客户数量与占比,用于比较线上网站、移动应用、线下门店、第三方市场等渠道结构。
支付方式分布分析:按支付方式统计客户数量与占比,用于观察借记卡、银行转账、信用卡、货到付款、电子钱包等支付方式偏好。
购频客单对比分析:按购买频率分组,计算平均客单价、平均总花费和客户数量,用于比较不同购买频率客户的消费能力。
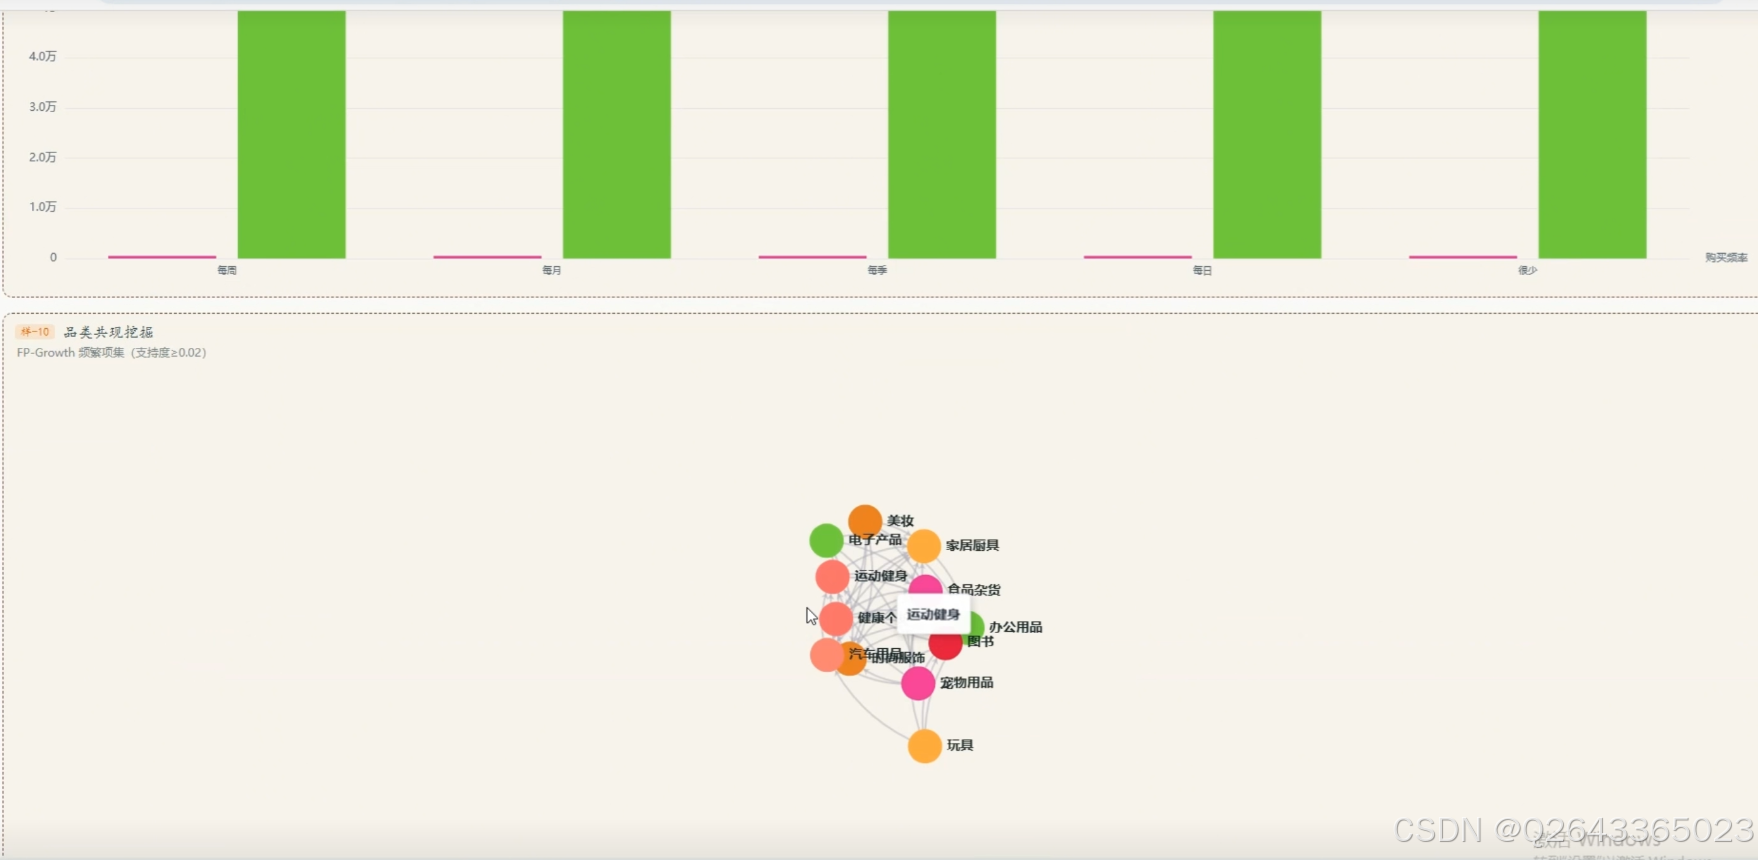
品类共现挖掘分析:将非空偏好品类组成购物篮,使用频繁模式增长算法以支持度阈值 0.02、置信度阈值 0.3 挖掘频繁项集与关联规则,输出项集标签、项数、频次和支持度。
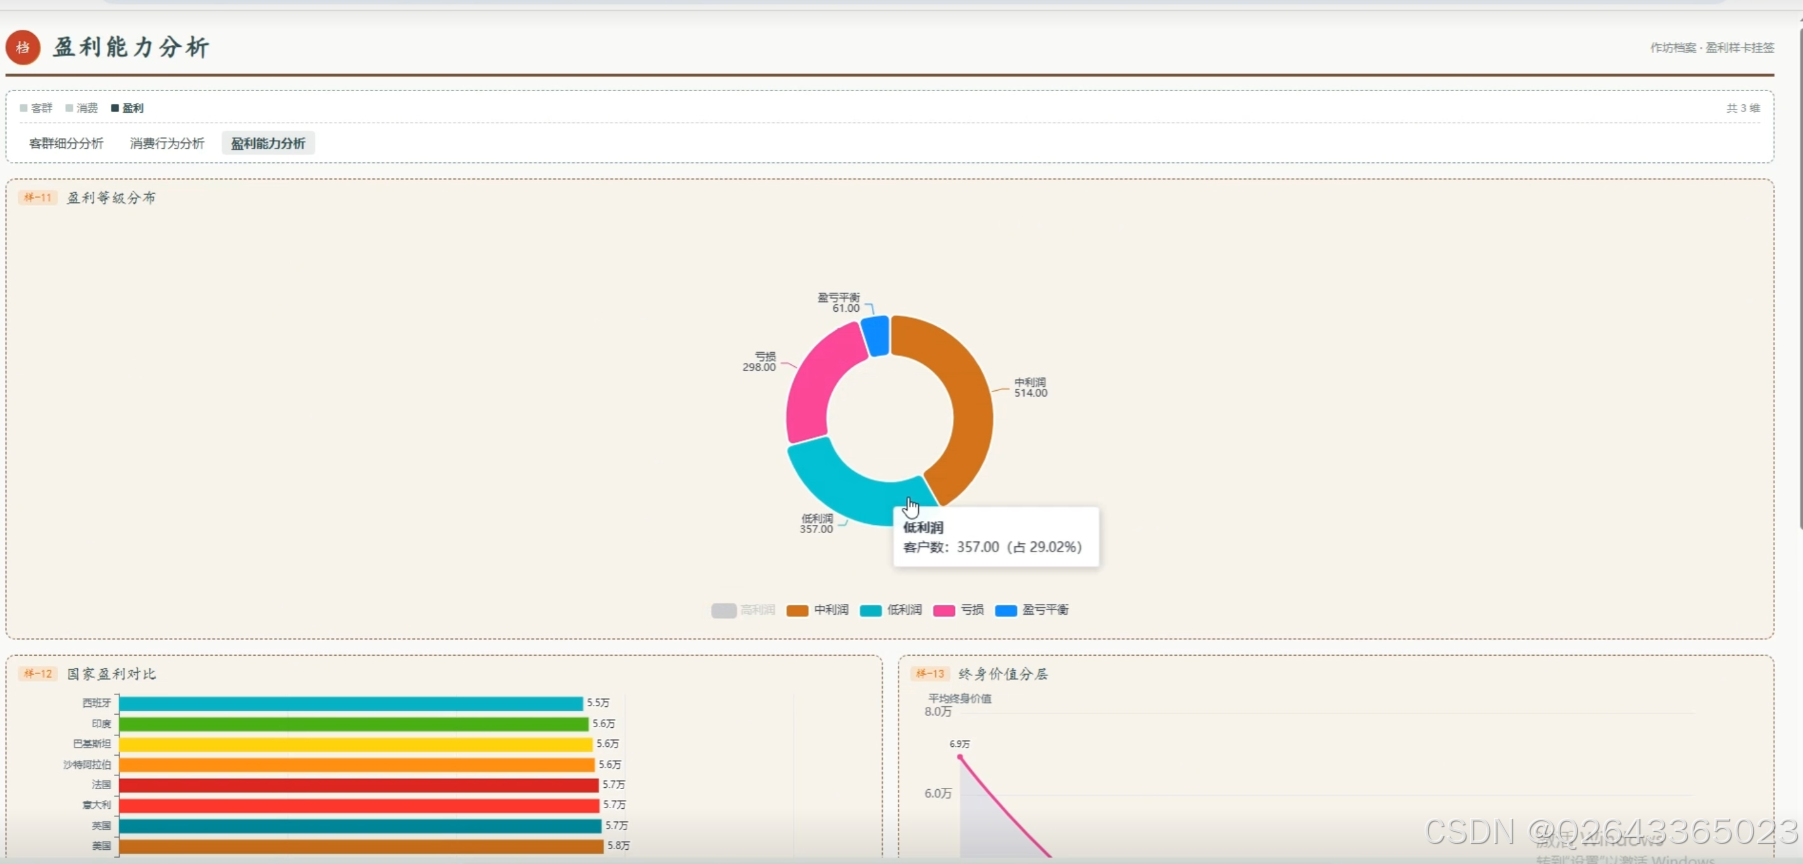
盈利等级分布分析:按盈利类别统计客户数量与占比,用于观察高利润、中利润、低利润、盈亏平衡、亏损等盈利等级分布。
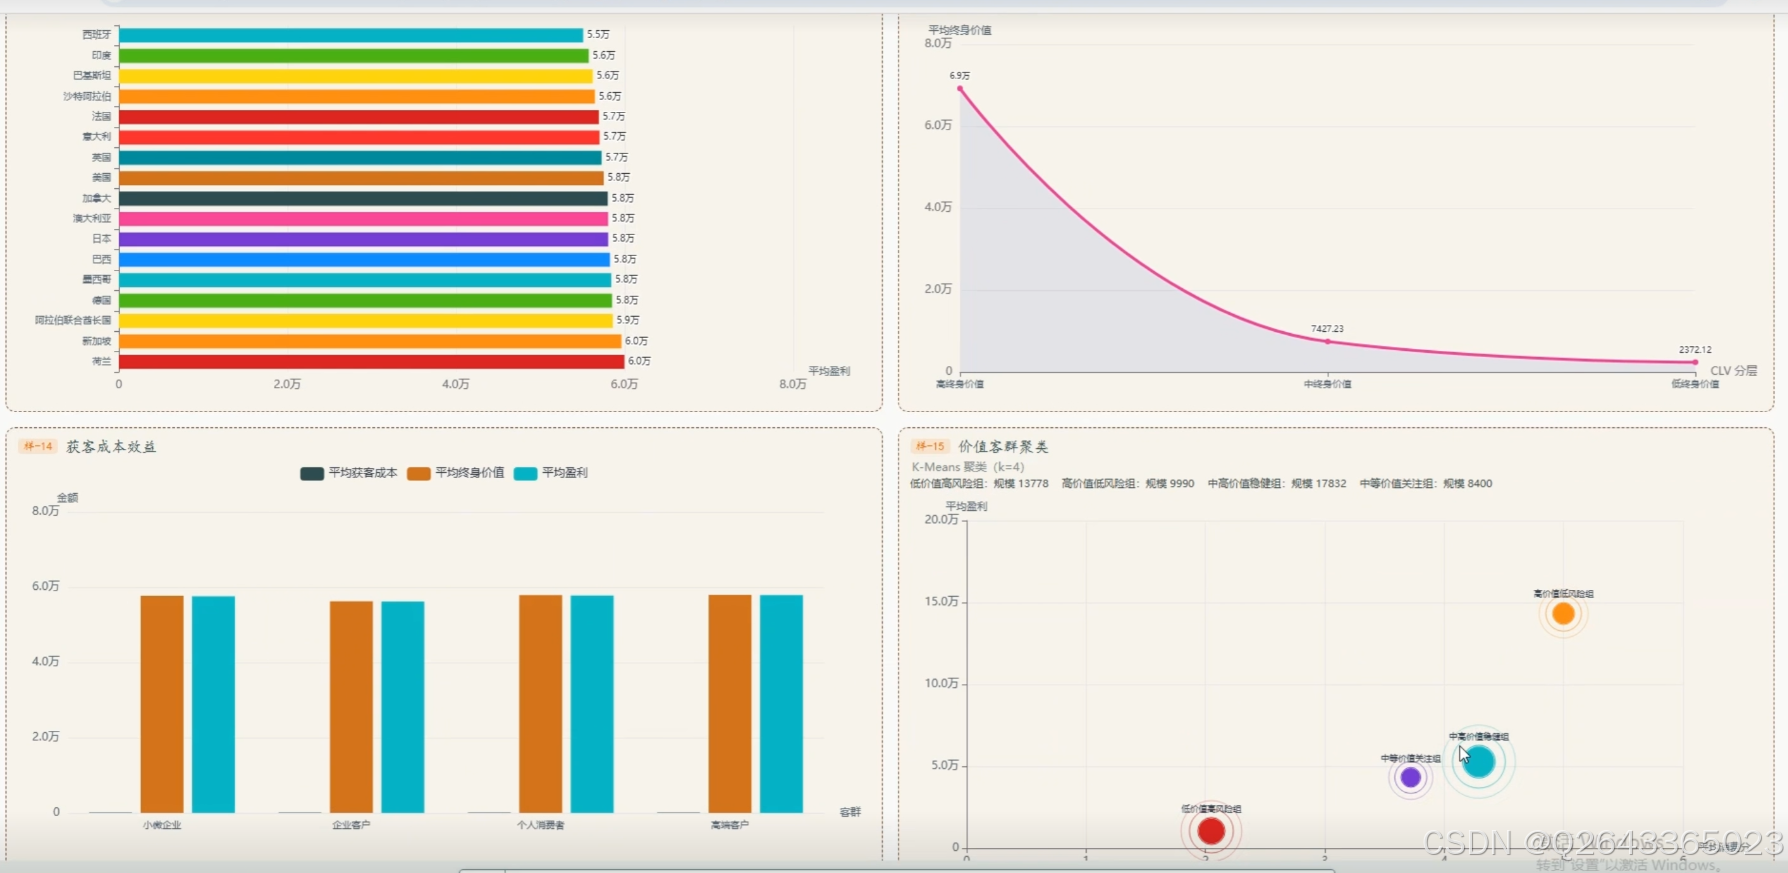
国家盈利对比分析:按国家分组,计算平均客户盈利、平均总花费和客户数量,用于比较不同国家的盈利表现。
终身价值分层分析:按终身价值类别分组,统计客户数量、占比和平均客户终身价值,用于分析高、中、低终身价值客户结构。
获客成本效益分析:按客户细分分组,计算平均客户获取成本、平均客户终身价值、平均盈利、终身价值与获取成本效率比和客户数量,用于评估各客群获客成本效益。
价值客群聚类分析:选取最近一次消费得分、消费频率得分、消费金额得分、客户盈利能力、客户终身价值和流失风险得分作为特征,经标准化后使用 K均值聚类,设置聚类数为 4、随机种子为 42,并按簇心综合价值从高到低命名为高价值低风险组、中高价值稳健组、中等价值关注组、低价值高风险组。
3 系统展示
3.1 功能展示视频
基于大数据的电商客户细分与盈利能力可视化分析源码
!!!请点击这里查看功能演示!!!
3.2 大屏页面
3.3 分析页面
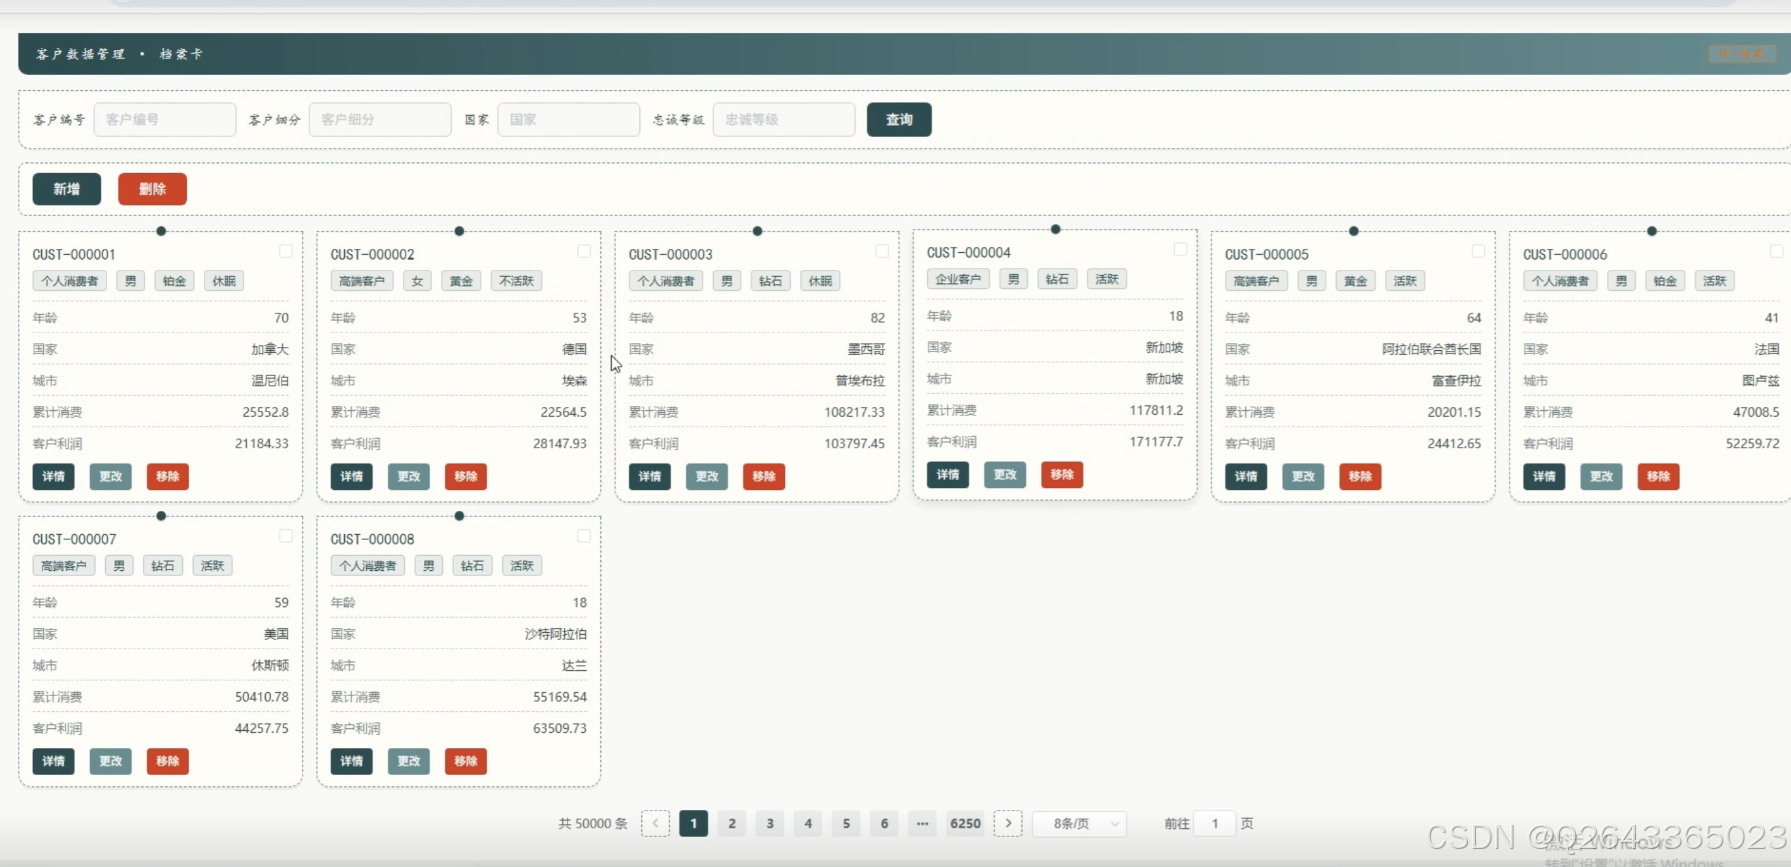
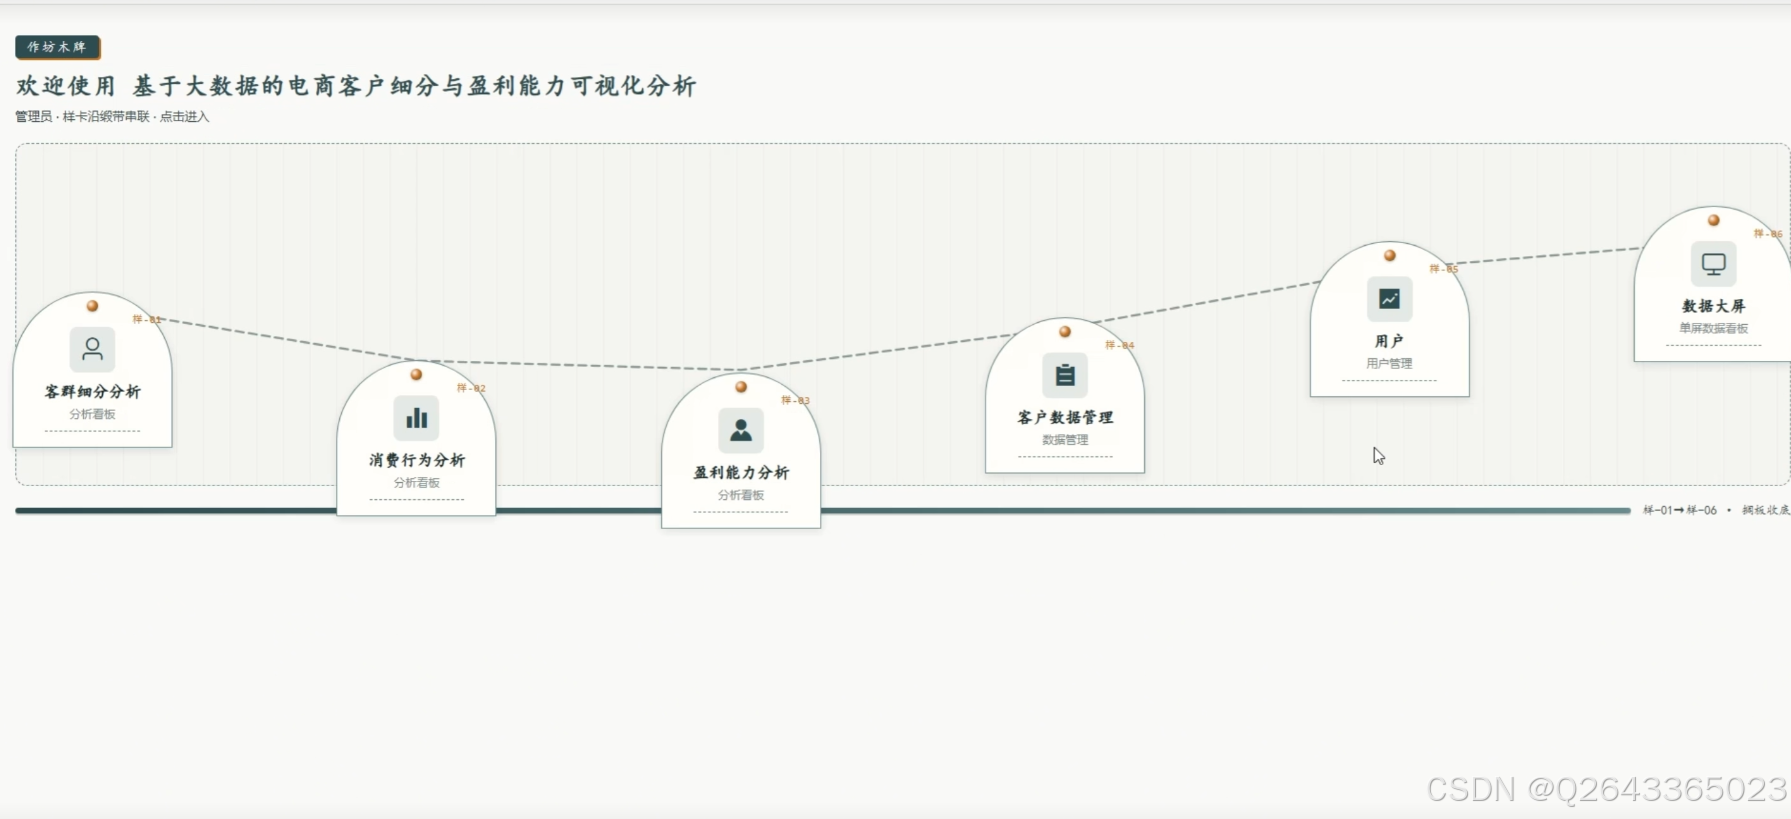
3.4 基础页面
4 更多推荐
计算机专业毕业设计新风向,2026年大数据 + AI前沿60个毕设选题全解析,涵盖Hadoop、Spark、机器学习、AI等类型
计算机专业毕业设计选题深度剖析,掌握这些技巧,让你的选题轻松通过,文章附35个优质选题助你顺利通过开题!
【避坑必看】26届计算机毕业设计选题雷区大全,这些毕设题目千万别选!选题雷区深度解析
紧跟风口!2026计算机毕设新赛道:精选三大热门领域下的创新选题, 拒绝平庸!毕设技术亮点+功能创新,双管齐下
纯分享!2026届计算机毕业设计选题全攻略(选题+技术栈+创新点+避坑),这80个题目覆盖所有方向,计算机毕设选题大全收藏
计算机专业毕业设计选题深度剖析,掌握这些技巧,让你的选题轻松通过,文章附35个优质选题助你顺利通过开题!
5 部分功能代码
# 选取特征列并强制转为 double
feature_cols = [
    'recency_score',
    'frequency_score',
    'monetary_score',
    'customer_profitability_usd',
    'customer_lifetime_value_usd',
    'churn_risk_score',
]
feat_df = input_df
for c in feature_cols:
    feat_df = feat_df.withColumn(c, col(c).cast('double'))

# 向量组装与标准化
assembler = VectorAssembler(inputCols=feature_cols, outputCol='features_raw')
assembled = assembler.transform(feat_df)

scaler = StandardScaler(
    inputCol='features_raw',
    outputCol='features',
    withStd=True,
    withMean=True,
)
scaled = scaler.fit(assembled).transform(assembled)

# K-Means 聚类,k=4
kmeans = KMeans(
    featuresCol='features',
    predictionCol='cluster_id',
    k=4,
    seed=42,
)
model = kmeans.fit(scaled)
predicted = model.transform(scaled)

# 各簇特征均值
profile = (
    predicted.groupBy('cluster_id')
    .agg(
        spark_count(lit(1)).alias('cluster_size'),
        spark_round(spark_avg('recency_score'), 2).alias('avg_recency'),
        spark_round(spark_avg('frequency_score'), 2).alias('avg_frequency'),
        spark_round(spark_avg('monetary_score'), 2).alias('avg_monetary'),
        spark_round(spark_avg('customer_profitability_usd'), 2).alias('avg_profit'),
        spark_round(spark_avg('customer_lifetime_value_usd'), 2).alias('avg_clv'),
        spark_round(spark_avg('churn_risk_score'), 2).alias('avg_churn_risk'),
    )
)
# 数值列保留两位小数
for field in result_df.schema.fields:
    if isinstance(field.dataType, (DoubleType, FloatType, IntegerType, LongType)):
        result_df = result_df.withColumn(
            field.name,
            spark_round(col(field.name).cast('double'), 2),
        )

# 日期、时间戳、布尔类型转为字符串
for field in result_df.schema.fields:
    if isinstance(field.dataType, (DateType, TimestampType, BooleanType)):
        result_df = result_df.withColumn(
            field.name,
            col(field.name).cast(StringType()),
        )

# 写为单个本地 CSV
pdf = result_df.toPandas()
if os.path.exists(csv_path):
    os.remove(csv_path)
pdf.to_csv(csv_path, encoding='utf-8', index=False)
源码项目、定制开发、文档报告、PPT、代码答疑
希望和大家多多交流 ↓↓↓↓↓
电商企业物流数字化转型必备!快递鸟 API 接口,72 小时快速完成物流系统集成。全流程实战1V1指导,营造开放的API技术生态圈。
更多推荐
 1
 0
- 0


 已为社区贡献4条内容

所有评论(0)