从零搭建Python大语言模型电商导购助手——从需求理解到混合召回、RAG可信推荐与FastAPI落地
从零搭建Python大语言模型电商导购助手——从需求理解到混合召回、RAG可信推荐与FastAPI落地
标Python | 大语言模型 | RAG | 推荐系统 | 信息检索 | 向量检索 | BM25 | FastAPI | Pydantic | 电商系统
|
本文从真实电商检索痛点出发,完整实现一个基于 Python 与大语言模型的智能导购助手:先将用户口语化需求解析为品类、预算、场景、功能与排除条件,再以 BM25 和 BGE 向量检索完成混合召回,通过 RRF、预算/库存/评分等业务特征重排候选,最后使用检索增强生成与事实门禁输出可解释推荐。文章给出统一商品模型、关键代码、FastAPI 接口、端到端示例、故障排查、评测指标与生产化边界,重点解决“搜得到但不懂需求”“模型会说但不可信”“推荐结果难以验证”三类问题,适合作为智能电商、RAG、推荐系统与 AI 应用工程的综合项目实践。 |
先看最终效果:一句购买需求,系统如何变成可执行的决策链路
用户真正的购买需求很少像数据库字段那样整齐。更常见的表达是:“预算 500 元以内,通勤时想要降噪,平时还要开视频会议,麦克风要清楚,戴久一点别夹头,最好别太重。”这句话同时包含品类、预算、场景、核心功能、舒适性和重量偏好。如果仍然只做关键词匹配,系统最多抓住“500 元、降噪、耳机”,其余条件很容易丢失。
|
本文要实现的结果 不是让大模型凭记忆“猜一个商品”,而是把自然语言需求转换为结构化约束,先从真实商品库中召回和排序,再让模型基于候选商品解释“为什么推荐、哪里不匹配、需要注意什么”。所有价格、库存、规格与链接都必须来自数据源。 |
|
阶段 |
输入 |
关键处理 |
输出 |
|
1. 需求理解 |
自然语言购买需求 |
识别意图,提取品类、预算、场景、功能、排除条件 |
结构化 UserNeed |
|
2. 候选过滤 |
商品库 + UserNeed |
库存/品类/禁售等硬约束,预算冲突可分层降级 |
可检索候选集 |
|
3. 混合召回 |
查询 + 候选文本 |
BM25 精确词匹配 + BGE 语义向量召回 |
两路 Top-K |
|
4. 融合重排 |
多路候选 + 业务字段 |
RRF 融合,叠加预算、评分、库存、偏好 |
最终候选 Top-N |
|
5. 可信生成 |
候选商品事实 |
大模型生成结构化推荐计划,事实门禁校验 |
可解释导购回答 |
|
6. 服务输出 |
结果 + trace_id |
FastAPI 返回 JSON,前端可渲染卡片/对比表 |
可追踪接口结果 |
1. 为什么不能直接把商品列表交给大模型
大语言模型擅长理解自然语言、归纳信息和组织表达,但它不是库存数据库,也不是实时价格服务。直接让模型“推荐 500 元以内的耳机”有三个典型风险:第一,模型可能生成商品库中不存在的功能;第二,价格、库存、活动和售后会随时间变化;第三,模型无法稳定保证每次都严格满足预算、品类与禁忌条件。
|
方案 |
优点 |
主要问题 |
适合场景 |
|
关键词搜索 |
实现简单、精确型号匹配强 |
难理解场景化和口语化需求 |
明确品牌/型号/规格查询 |
|
大模型直接回答 |
交互自然、解释能力强 |
事实不可控、价格库存易过时、不可追溯 |
开放式咨询,不承担实时商品事实 |
|
向量检索单路召回 |
能理解语义相近表达 |
型号、数字、品牌词可能不如关键词稳定 |
语义问答、长尾需求 |
|
本文的混合检索 + RAG |
精确匹配与语义理解兼顾,结果可验证 |
架构更复杂,需要数据治理和评测 |
生产级智能导购与商品问答 |
因此,一个更稳的职责划分是:大模型负责“理解需求”和“解释结果”;商品数据库负责“提供事实”;检索模块负责“找出候选”;排序模块负责“决定优先级”;规则模块负责“执行强约束”;最终由事实校验模块把生成内容重新拉回真实数据。这个边界比“模型越强越好”更重要。
2. 项目目标、适用范围与技术栈
2.1 四个核心目标
- 提升语义理解能力:把“适合学生宿舍、噪音小、预算四百左右的风扇”转换为可执行的品类、预算、场景和功能条件。
- 构建可解释推荐:每个推荐项都明确展示匹配点、限制条件和事实来源,而不是只给“建议购买”。
- 降低重复导购工作量:自动处理商品初筛、参数对比、预算匹配、评价摘要和常见风险提示,把复杂争议与高风险问题转人工。
- 建立可扩展技术框架:通过统一数据模型、检索接口、排序策略和生成协议扩展到数码、家电、服饰、美妆、图书等品类。
2.2 参考技术栈
|
模块 |
技术选择 |
职责 |
|
语言与服务 |
Python、FastAPI、Uvicorn |
数据处理、接口编排、服务化 |
|
数据模型 |
Pydantic、Pandas |
字段校验、数据清洗、序列化 |
|
关键词召回 |
BM25、jieba |
型号、品牌、规格、精确属性匹配 |
|
语义召回 |
Sentence Transformers、BAAI/bge-small-zh-v1.5 |
场景化、同义表达、长尾需求召回 |
|
融合与重排 |
RRF + 业务特征评分 |
统一多路召回秩序,处理预算、库存、评分和偏好 |
|
生成层 |
OpenAI 兼容接口的大语言模型 |
意图抽取、推荐解释、对比摘要 |
|
事实与安全 |
规则引擎、字段白名单、结果校验 |
禁止编造价格/库存/规格,处理高风险类目 |
环境依赖(建议使用虚拟环境)
pip install pydantic pandas fastapi uvicorn openai sentence-transformers rank-bm25 scikit-learn jieba
本文代码按 Python 3.11+ 与 Pydantic v2 写法组织。第三方模型、SDK 与接口能力会持续更新,正式项目应固定依赖版本并建立回归测试。BGE 中文模型标识应写为 `BAAI/bge-small-zh-v1.5`,不要把连字符误写为空格。
3. 总体架构:让模型处在可验证的边界内
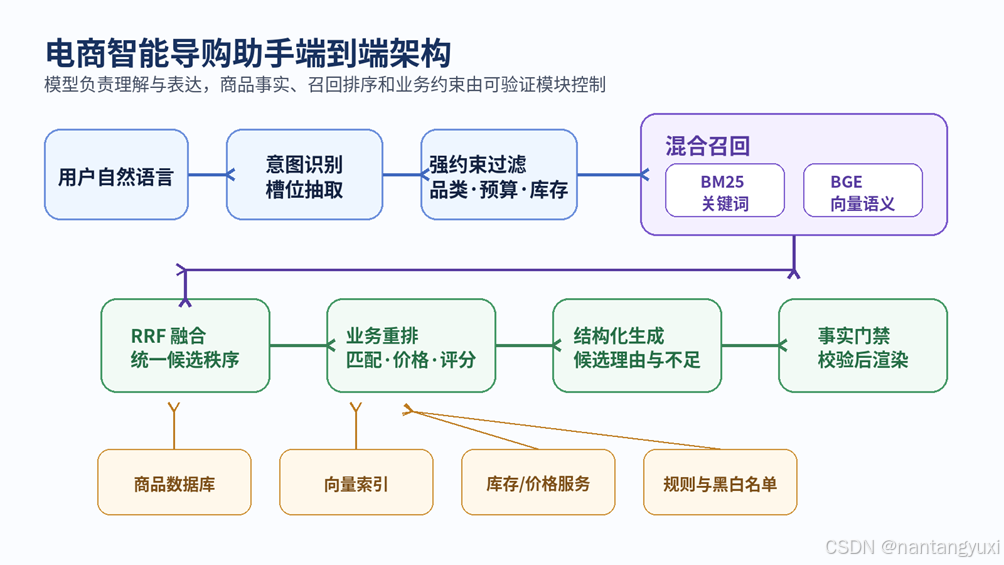
图 2 电商智能导购助手端到端架构
一次推荐请求从用户输入开始,先进入意图识别与槽位抽取。系统将强约束应用在候选集上,再并行执行 BM25 和向量召回。两路结果不直接按原始分数相加,而是先通过 RRF 等方法融合秩序,再叠加预算匹配、库存、评分、品牌偏好等业务特征完成重排。最终只把少量高质量候选商品及其真实字段交给生成层。
这里还有一个容易忽略的工程原则:向量库中适合保存“相对稳定的语义内容”和 product_id,不应把价格、库存、活动有效期当作长期静态向量事实。生成回答前应根据 product_id 再次读取最新价格和库存,避免“向量索引是昨天的,回答却当成今天的实时信息”。
4. 商品数据治理:推荐质量的上限先由数据决定
如果商品数据本身混乱,后面的模型再强也只能在错误信息上做更流畅的表达。电商数据常见问题包括单位不统一、价格字段夹杂促销文案、库存状态多种写法、规格缺失、评价噪声和重复商品。建议把数据治理放在写入阶段,而不是把清洗压力推给每一次查询。
|
问题 |
错误示例 |
统一策略 |
|
容量单位 |
500ml、0.5L、500 毫升 |
存储标准值 + 标准单位,展示层再格式化 |
|
价格 |
¥399、399 元、到手 359 起 |
基础售价使用 Decimal;促销单独建字段并带有效期 |
|
库存 |
有货、现货、28、空值 |
统一为 stock 数量或明确的 availability 状态 |
|
文本空白 |
名称前后空格、连续换行 |
NFKC 归一化 + 空白折叠 |
|
规格别名 |
降噪/ANC/主动降噪 |
建立属性词典或标准字段映射 |
|
评价摘要 |
长文本、广告、重复句 |
离线清洗后生成短摘要,并保留更新时间 |
统一商品模型:避免可变默认值,并把核心事实结构化
from decimal import Decimal
from pydantic import BaseModel, Field, field_validator
class Product(BaseModel):
product_id: str = Field(min_length=1)
name: str = Field(min_length=1)
category: str = Field(min_length=1)
brand: str = ""
price: Decimal = Field(gt=0)
stock: int = Field(ge=0)
rating: float = Field(ge=0, le=5)
description: str = ""
tags: list[str] = Field(default_factory=list)
specs: dict[str, str | int | float] = Field(default_factory=dict)
review_summary: str = ""
is_active: bool = True
@field_validator("name", "category", "brand", "description", "review_summary")
@classmethod
def clean_text(cls, value: str) -> str:
return " ".join(value.split())
与简单示例相比,这里特意使用 `Field(default_factory=list)` 与 `Field(default_factory=dict)` 创建列表和字典,避免把可变对象作为类字段默认值;金额使用 Decimal,避免财务类字段受二进制浮点精度影响。
5. 意图识别与槽位抽取:先把“人话”变成检索条件
导购系统的第一步不是向量检索,而是理解用户到底想做什么。推荐、对比、查库存、问活动、问售后虽然都可以用自然语言表达,但后续处理链路不同。对于推荐类请求,建议至少抽取以下槽位:
|
槽位 |
示例 |
约束级别 |
|
category |
耳机 |
强约束 |
|
budget_max |
500 |
通常强约束,可在无结果时明确降级 |
|
scenes |
通勤、视频会议 |
语义条件 |
|
must_have |
主动降噪、麦克风清晰 |
强/高权重 |
|
preferences |
轻量、佩戴舒适 |
软约束 |
|
exclude |
入耳式、白色 |
强排除 |
|
brand_preference |
无/指定品牌 |
软约束或强约束 |
|
sort_focus |
性价比、续航、舒适 |
重排权重 |
需求槽位模型
from decimal import Decimal
from typing import Literal
from pydantic import BaseModel, Field
class UserNeed(BaseModel):
intent: Literal["recommend", "compare", "price", "stock", "after_sale"] = "recommend"
category: str | None = None
budget_max: Decimal | None = None
scenes: list[str] = Field(default_factory=list)
must_have: list[str] = Field(default_factory=list)
preferences: list[str] = Field(default_factory=list)
exclude: list[str] = Field(default_factory=list)
brand_preference: list[str] = Field(default_factory=list)
sort_focus: list[str] = Field(default_factory=list)
|
一个可执行的解析结果 输入:“预算 500 元以内,通勤时想要降噪,平时还要开视频会议,麦克风要清楚,戴久一点别夹头,最好别太重。” |
生产环境中,最好使用模型提供的结构化输出、工具调用或 JSON Schema 能力;如果接入的是 OpenAI 兼容接口但不保证结构化输出,则必须在程序侧执行 JSON 解析、Pydantic 校验、重试和降级。不要让非法字段直接进入检索层。
6. 商品文本标准化与检索文档构建
向量检索和 BM25 都依赖检索文档。只把商品名称送入模型会损失大量信息;把整段详情页原样塞进去又会引入营销噪声。更稳的做法是把关键结构化字段带标签拼成紧凑文档,使模型明确知道每一段信息的语义角色。
检索文档构建
import json
import re
import unicodedata
def normalize_text(text: str) -> str:
text = unicodedata.normalize("NFKC", text)
text = text.lower().strip()
text = re.sub(r"\s+", " ", text)
return text
def build_document(p: Product) -> str:
spec_text = " ".join(f"{k}:{v}" for k, v in p.specs.items())
raw = (
f"名称:{p.name} 类目:{p.category} 品牌:{p.brand} "
f"标签:{' '.join(p.tags)} 规格:{spec_text} "
f"描述:{p.description} 评价摘要:{p.review_summary}"
)
return normalize_text(raw)
价格和库存可以作为过滤与排序字段使用,但通常不建议反复写进向量文本:它们变化快,容易让语义向量频繁重算。更好的方式是让向量文档表示“这个商品是什么、适合什么场景、有哪些稳定属性”,动态事实在查询时走结构化字段。
7. 混合召回:BM25 解决精确词,向量检索解决语义
7.1 为什么单路召回不够
|
查询类型 |
BM25 表现 |
向量检索表现 |
建议 |
|
明确型号:X200 Pro 16GB |
强 |
可能被语义稀释 |
BM25 高权重 |
|
规格:500ml、65W、2TB |
强 |
取决于模型对数字理解 |
BM25 + 结构化过滤 |
|
场景:久坐办公腰背舒服 |
一般 |
强 |
向量召回高权重 |
|
口语:戴一天别夹头 |
弱到一般 |
强 |
向量召回 |
|
品牌 + 场景复合条件 |
强 |
强 |
混合召回 |
7.2 BM25 关键词召回
BM25 示例
import jieba
from rank_bm25 import BM25Okapi
documents = [build_document(p) for p in products]
tokenized_documents = [jieba.lcut(doc) for doc in documents]
bm25 = BM25Okapi(tokenized_documents)
query = "500元以内 通勤 降噪 视频会议 麦克风清晰 耳机"
keyword_scores = bm25.get_scores(jieba.lcut(query))
keyword_rank = keyword_scores.argsort()[::-1]
BM25 的优势是对品牌、型号、规格词和显式属性非常敏感,且可解释性强。对电商检索来说,它仍然是不可替代的基础能力。
7.3 BGE 向量语义召回
中文向量召回示例
from sentence_transformers import SentenceTransformer
import numpy as np
encoder = SentenceTransformer("BAAI/bge-small-zh-v1.5")
product_vectors = encoder.encode(documents, normalize_embeddings=True)
query_text = "为这个句子生成表示以用于检索相关文章:" + query
query_vector = encoder.encode([query_text], normalize_embeddings=True)[0]
semantic_scores = product_vectors @ query_vector
semantic_rank = np.argsort(semantic_scores)[::-1]
归一化向量后,点积可直接作为余弦相似度使用。对于场景化需求,向量模型可以把“戴久不夹头”与“佩戴压力较低、长时间舒适”等不同表述建立联系。
7.4 为什么不建议直接把两种原始分数相加
BM25 分数和余弦相似度来自不同分布。一个查询的 BM25 最高分可能是 18,另一个可能是 6;向量相似度却通常落在有限区间。固定写成 `0.5 * BM25 + 0.5 * cosine` 很容易让某一路在不同查询中无意间占据绝对优势。
|
融合方式 |
优点 |
风险 |
|
Min-Max 归一化后加权 |
直观,易加入业务权重 |
候选少或极值异常时不稳定 |
|
Z-score 后加权 |
统计意义更明确 |
分布假设和异常值处理更复杂 |
|
RRF(Reciprocal Rank Fusion) |
只依赖排名,不依赖原始分数尺度;多路融合稳健 |
不利用“分数差距有多大”的信息 |
|
学习排序模型 |
可从标注/点击数据学习最优组合 |
需要高质量训练数据和持续评测 |
RRF 融合:先统一“名次”,再进入业务重排
from collections import defaultdict
def reciprocal_rank_fusion(rank_lists: list[list[str]], k: int = 60) -> dict[str, float]:
scores = defaultdict(float)
for ranked_ids in rank_lists:
for rank, product_id in enumerate(ranked_ids, start=1):
scores[product_id] += 1.0 / (k + rank)
return dict(scores)
`k=60` 是常见平滑取值,不是业务硬标准。实际项目应结合召回 Top-K、商品规模和离线评测调整。
8. 业务重排:相关不等于值得推荐
召回阶段回答“哪些商品可能相关”,重排阶段回答“哪些商品更值得排在前面”。导购场景至少要考虑预算、库存、评分、场景匹配、品牌偏好和排除条件。强约束与软约束必须分开:无库存、禁售、品类错误等不应只做轻微降权。
|
类型 |
典型字段 |
处理方式 |
|
强约束 |
品类、禁售、明确排除、库存为 0 |
过滤,不进入推荐 |
|
预算约束 |
budget_max |
默认过滤;无结果时可提供“放宽 10%”备选并明确标记 |
|
高优先偏好 |
核心功能、场景 |
重排高权重 |
|
软偏好 |
颜色、品牌倾向、外观 |
加分,不应牺牲核心功能 |
|
质量信号 |
评分、评价风险、售后 |
作为置信度与排序辅助 |
业务重排示例
def budget_score(price: float, budget: float | None) -> float:
if budget is None:
return 1.0
if price <= budget:
return 1.0
return max(0.0, 1.0 - (price - budget) / max(budget, 1.0))
def final_score(rrf_score: float, product: Product, budget: float | None, preference_score: float) -> float:
# 示例权重仅用于说明结构,正式环境应通过离线评测/线上实验调参
retrieval = min(rrf_score / 0.05, 1.0)
stock = 1.0 if product.stock > 0 else 0.0
rating = product.rating / 5.0
return (
0.55 * retrieval
+ 0.15 * budget_score(float(product.price), budget)
+ 0.10 * stock
+ 0.10 * rating
+ 0.10 * preference_score
)
不要把示例权重当成通用最优值。不同品类的决策因素不同:数码产品可能更看重性能与保修,美妆更关注成分与禁忌,服饰更关注尺码和材质。真正稳定的权重应通过标注集、点击/转化数据和人工审核共同校准。
9. RAG 与事实门禁:让回答自然,但不让事实失控
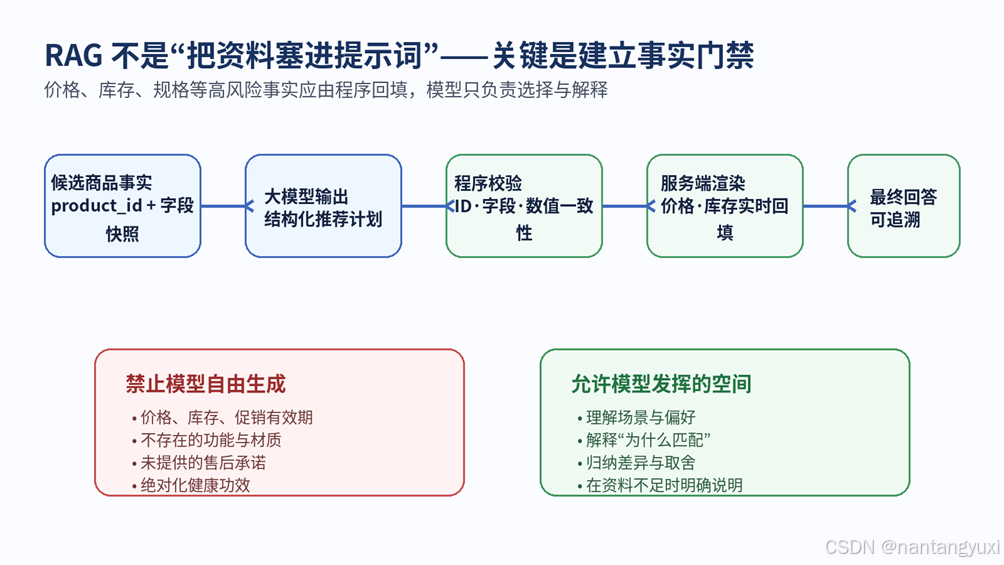
图 3 从检索增强生成到事实门禁的可信闭环
最弱的 RAG 做法是把候选商品 JSON 拼进 Prompt,让模型自由写一段回答。这已经比“凭记忆回答”更可靠,但仍然可能把 469 元写成 499 元,或把 A 商品的卖点串到 B 商品。更稳的方式是让模型先输出结构化“推荐计划”,关键事实再由程序回填。
生成层约束提示词
SYSTEM_PROMPT = """
你是电商导购决策模块,只能使用给定候选商品资料。
规则:
1. 不得编造价格、库存、规格、促销、物流、售后或健康功效。
2. 只允许推荐 candidates 中存在的 product_id。
3. 每个推荐项必须包含:匹配原因、一个可能不足或信息缺口。
4. 资料未提供时明确写“资料未提供”,不能推测。
5. 输出 JSON,不直接输出最终展示文案。
"""
结构化推荐计划
from pydantic import BaseModel, Field
class RecommendationPlanItem(BaseModel):
product_id: str
reasons: list[str] = Field(default_factory=list)
caveats: list[str] = Field(default_factory=list)
class RecommendationPlan(BaseModel):
summary: str
items: list[RecommendationPlanItem]
# 生成后先校验 product_id,再从数据库重新读取最新商品事实。
# 最终价格、库存、规格由程序渲染,而不是直接相信模型文本。
这种设计的核心价值是把“事实”和“语言”分离。模型可以解释“为什么这款更适合通勤和会议”,但价格由 `product.price` 输出,库存由实时库存服务输出,规格由结构化字段输出。这样即使更换模型,也不会把关键业务事实一起交给不可控的生成过程。
10. OpenAI 兼容接口接入:把模型供应商变成可替换组件
兼容接口调用示例
import os
from openai import OpenAI
client = OpenAI(
api_key=os.environ["LLM_API_KEY"],
base_url=os.environ["LLM_BASE_URL"],
)
MODEL = os.environ["LLM_MODEL"]
response = client.chat.completions.create(
model=MODEL,
messages=[
{"role": "system", "content": SYSTEM_PROMPT},
{"role": "user", "content": prompt},
],
temperature=0.2,
)
raw = response.choices[0].message.content
将模型名、密钥与 Base URL 全部放入环境变量,代码层不绑定具体供应商。很多 OpenAI 兼容服务要求 Base URL 以 `/v1` 结束,但具体路径应以供应商文档为准;不要把空字符串作为 Base URL。生产环境还应设置连接超时、读取超时、有限重试、熔断与日志脱敏。
11. FastAPI 服务化:把推荐链路封装成可测试接口
推荐接口骨架
from fastapi import FastAPI
from pydantic import BaseModel, Field
app = FastAPI(title="E-commerce Shopping Assistant")
class RecommendRequest(BaseModel):
query: str = Field(min_length=2, max_length=500)
top_k: int = Field(default=3, ge=1, le=10)
class RecommendResponse(BaseModel):
trace_id: str
parsed_need: UserNeed
recommendations: list[dict]
@app.post("/recommend", response_model=RecommendResponse)
def recommend(req: RecommendRequest):
trace_id = create_trace_id()
need = extract_need(req.query)
candidates = retrieve_and_rerank(need, top_k=req.top_k)
plan = generate_recommendation_plan(req.query, candidates)
safe_items = validate_and_render(plan, candidates)
return RecommendResponse(
trace_id=trace_id,
parsed_need=need,
recommendations=safe_items,
)
接口层最好返回 `trace_id`。当用户反馈“为什么推荐了这款”或运营发现错误结果时,可以沿 trace_id 追踪:原始请求、槽位解析、过滤条件、BM25 排名、向量排名、融合分、重排分、候选事实快照和最终生成计划。没有可观测性,推荐错误往往只能靠猜。
12. 端到端示例:从一句自然语言到三款可解释候选
12.1 示例商品数据
|
ID |
商品 |
价格 |
库存 |
关键标签 |
已知不足 |
|
P2001 |
轻量通勤降噪耳机 |
469 |
36 |
主动降噪、四麦通话、245g、头戴式 |
续航 26 小时 |
|
P2002 |
长续航会议降噪耳机 |
529 |
18 |
主动降噪、六麦通话、45 小时 |
超过 500 元预算 |
|
P2003 |
入耳式通勤降噪耳机 |
399 |
52 |
主动降噪、轻量、30 小时 |
入耳式,舒适偏好因人而异 |
|
P3001 |
静音循环风扇 |
399 |
28 |
宿舍、静音、循环送风 |
品类不匹配 |
12.2 用户输入
|
用户需求 预算 500 元以内,通勤时想要降噪,平时还要开视频会议,麦克风要清楚,戴久一点别夹头,最好别太重。 |
12.3 解析结果
{
"intent": "recommend",
"category": "耳机",
"budget_max": 500,
"scenes": ["通勤", "视频会议"],
"must_have": ["降噪", "麦克风清晰"],
"preferences": ["佩戴舒适", "轻量"],
"exclude": [],
"sort_focus": ["匹配度", "预算", "舒适"]
}
12.4 排序逻辑
- P3001 在品类硬约束阶段直接淘汰,不进入召回。
- P2002 语义和功能匹配都很强,但超过预算;严格预算模式下不作为主推荐,可在“预算放宽方案”中单独展示。
- P2001 同时满足预算、头戴式、主动降噪和会议麦克风需求,并有明确重量字段,因此优先级最高。
- P2003 预算和降噪都满足,但属于入耳式;用户强调“戴久别夹头”时,它可以作为不同佩戴形态的备选,而不是直接宣称一定更舒适。
12.5 最终展示示例
|
优先候选:P2001 轻量通勤降噪耳机 价格:469 元;库存:36。 |
|
备选:P2003 入耳式通勤降噪耳机 价格:399 元;库存:52。 |
|
预算放宽方案:P2002 长续航会议降噪耳机 价格:529 元;库存:18。 |
13. 评测体系:不仅要“看起来不错”,还要能量化回归
智能导购涉及多个子任务,不能只看最终文案是否顺眼。建议把评测拆成四层:需求解析、召回排序、事实一致性和系统性能。每一层都建立固定测试集,模型或规则升级后自动回归。
|
层级 |
指标 |
回答的问题 |
|
需求解析 |
槽位准确率、字段级 F1、JSON 合法率 |
预算、品类、排除条件是否被正确理解 |
|
召回 |
Recall@K、MRR、nDCG@K |
正确商品是否进入候选,排名是否合理 |
|
业务约束 |
超预算率、无库存推荐率、禁售命中率 |
是否违反硬规则 |
|
事实一致性 |
价格/库存/规格数值一致率、未知事实生成率 |
回答是否忠于数据源 |
|
生成质量 |
理由覆盖率、限制条件覆盖率、人工偏好评分 |
解释是否完整且有用 |
|
性能 |
P50/P95 延迟、错误率、模型调用成本 |
上线后是否稳定、可承受 |
两个最基础的离线检查函数
def recall_at_k(relevant_ids: set[str], ranked_ids: list[str], k: int) -> float:
if not relevant_ids:
return 1.0
hit = len(relevant_ids.intersection(ranked_ids[:k]))
return hit / len(relevant_ids)
def budget_violation_rate(results: list[dict], budget: float) -> float:
if not results:
return 0.0
bad = sum(float(x["price"]) > budget for x in results)
return bad / len(results)
指标阈值不要凭感觉硬写成一个“行业标准”。不同商品规模、标注质量与业务容忍度差异很大,应先建立基线,再用同一测试集比较每次改动是否真正提升。
14. 常见问题与真实工程坑点
|
现象 |
常见根因 |
处理方式 |
|
SentenceTransformer 找不到模型 |
模型标识写错、网络不可达、缓存目录权限问题 |
确认 `BAAI/bge-small-zh-v1.5`;生产环境预下载并固定缓存 |
|
向量相似度都很高,区分度差 |
未归一化、文档过于模板化、字段噪声太多 |
规范文档、normalize_embeddings=True、引入 reranker |
|
BM25 与向量融合后排序怪异 |
直接相加原始分数,量纲不同 |
使用 RRF 或先做稳定归一化 |
|
模型输出商品库不存在的功能 |
让模型自由生成事实 |
结构化生成 + 字段白名单 + 服务端事实回填 |
|
价格和库存偶尔错误 |
使用旧缓存或向量文档中的动态字段 |
生成前按 product_id 读取实时服务 |
|
API 返回 404 |
兼容服务 Base URL 路径不正确 |
确认供应商要求,常见根路径包含 `/v1` |
|
条件太多导致无结果 |
把所有偏好都当硬约束 |
区分 hard/soft;返回“预算优先/性能优先/综合平衡” |
|
请求延迟突然升高 |
每次请求重算全库向量、无缓存、串行调用 |
离线预计算向量,Top-K 后再 rerank;网络调用异步化 |
|
结果无法复盘 |
没有 trace_id 和中间分数 |
记录解析结果、召回排名、融合分、事实快照和模型版本 |
15. 生产化增强:从课程项目走向真实业务
15.1 向量索引与两阶段检索
商品量从几千增长到几十万甚至更大时,不应每次在内存中计算全量余弦相似度。可以使用 pgvector、Qdrant、Milvus、Elasticsearch/OpenSearch 向量能力等建立 ANN 索引;先粗召回 Top-100,再用 cross-encoder reranker 或业务排序模型重排到 Top-10/Top-3。
15.2 缓存与实时数据分层
- 稳定内容:名称、类目、卖点、长期规格、标签,可进入语义向量与缓存。
- 准实时内容:评分、销量、评价摘要,可按分钟/小时刷新。
- 实时内容:价格、库存、优惠券资格、物流时效,应在返回结果前查询业务服务。
- 生成缓存:仅缓存不含实时事实的中间结果,或为价格库存设置短 TTL。
15.3 不同品类的规则插件化
|
品类 |
重点字段 |
额外风险 |
|
服饰 |
尺码、版型、面料、季节、颜色 |
尺码推荐需要用户身体数据,注意隐私与误差 |
|
数码 |
芯片、内存、接口、兼容性、保修 |
型号代际和地区版本差异 |
|
美妆 |
肤质、成分、功效、过敏原 |
避免医疗化、绝对化功效承诺 |
|
食品 |
配料、过敏原、保质期、储存条件 |
食品安全与特殊人群提示 |
|
家电 |
容量、功率、尺寸、能效、安装条件 |
电气安全与空间兼容性 |
15.4 安全与合规
涉及医疗健康、婴幼儿、食品安全、金融分期、特殊售后争议等场景时,不应仅依赖通用模型回答。需要敏感类目识别、免责声明模板、规则拦截和人工升级机制。用户画像与对话日志还涉及隐私,日志中应避免记录不必要的个人信息和密钥。
16. 一个更稳的项目目录结构
shopping_assistant/
├─ app/
│ ├─ api/ # FastAPI 路由与请求/响应模型
│ ├─ domain/ # Product、UserNeed 等领域模型
│ ├─ data/ # 数据清洗、仓储接口、实时事实读取
│ ├─ retrieval/ # BM25、向量召回、RRF
│ ├─ ranking/ # 业务特征与重排
│ ├─ llm/ # 意图抽取、结构化生成、模型客户端
│ ├─ guard/ # 事实校验、规则与风险控制
│ ├─ observability/ # trace、日志、指标
│ └─ main.py
├─ tests/
│ ├─ test_slots.py
│ ├─ test_retrieval.py
│ ├─ test_guard.py
│ └─ eval_set.jsonl
├─ scripts/
│ ├─ build_index.py
│ └─ evaluate.py
├─ requirements.txt
└─ README.md
把检索、排序、生成和事实校验拆开后,每个模块都可以独立测试、替换和扩容。未来即使从 BGE 换成其他向量模型、从规则重排换成学习排序、从一个大模型供应商换到另一个,业务层也不需要整体重写。
17. 完整设计原则回顾
- 真实数据优先:模型不能成为价格、库存、规格和售后事实的唯一来源。
- 先过滤再召回、先召回再生成:把大模型放到小而高质量的候选集上工作。
- 精确匹配与语义理解并存:BM25 负责“词”,向量负责“意思”,融合层负责稳定组合。
- 硬约束和软偏好分离:无库存、禁售、明确排除不能只做降权;偏好冲突要解释取舍。
- 结构化生成优于自由文本:关键事实由程序回填,模型主要负责理解、归纳与解释。
- 所有结果可追踪:保留 trace_id、解析结果、召回名次、排序分、事实快照和模型版本。
- 评测是长期能力:建立固定数据集,用 Recall@K、事实一致性、约束违规率和延迟持续回归。
当这套边界建立起来后,电商导购助手就不再是一个“会聊天的商品搜索框”,而是一条从需求理解、事实检索、业务决策到可信表达的完整购买决策链路。大语言模型带来的价值不是替代所有模块,而是把过去难以结构化的自然语言需求接入可验证的工程系统,让搜索真正理解场景,让推荐能够解释,让最终答案经得起数据核对。
参考资料
- FastAPI 官方文档:Request Body 与 Pydantic 模型 — https://fastapi.tiangolo.com/tutorial/body/
- BAAI BGE 中文向量模型:BAAI/bge-small-zh-v1.5 — https://huggingface.co/BAAI/bge-small-zh-v1.5
- OpenAI Python SDK — https://github.com/openai/openai-python
- Pydantic 文档 — https://docs.pydantic.dev/latest/
- Sentence Transformers 文档 — https://www.sbert.net/
电商企业物流数字化转型必备!快递鸟 API 接口,72 小时快速完成物流系统集成。全流程实战1V1指导,营造开放的API技术生态圈。
更多推荐
 3
 0
- 0


 已为社区贡献12条内容

所有评论(0)