阿里:电商长周期智能体评测基准
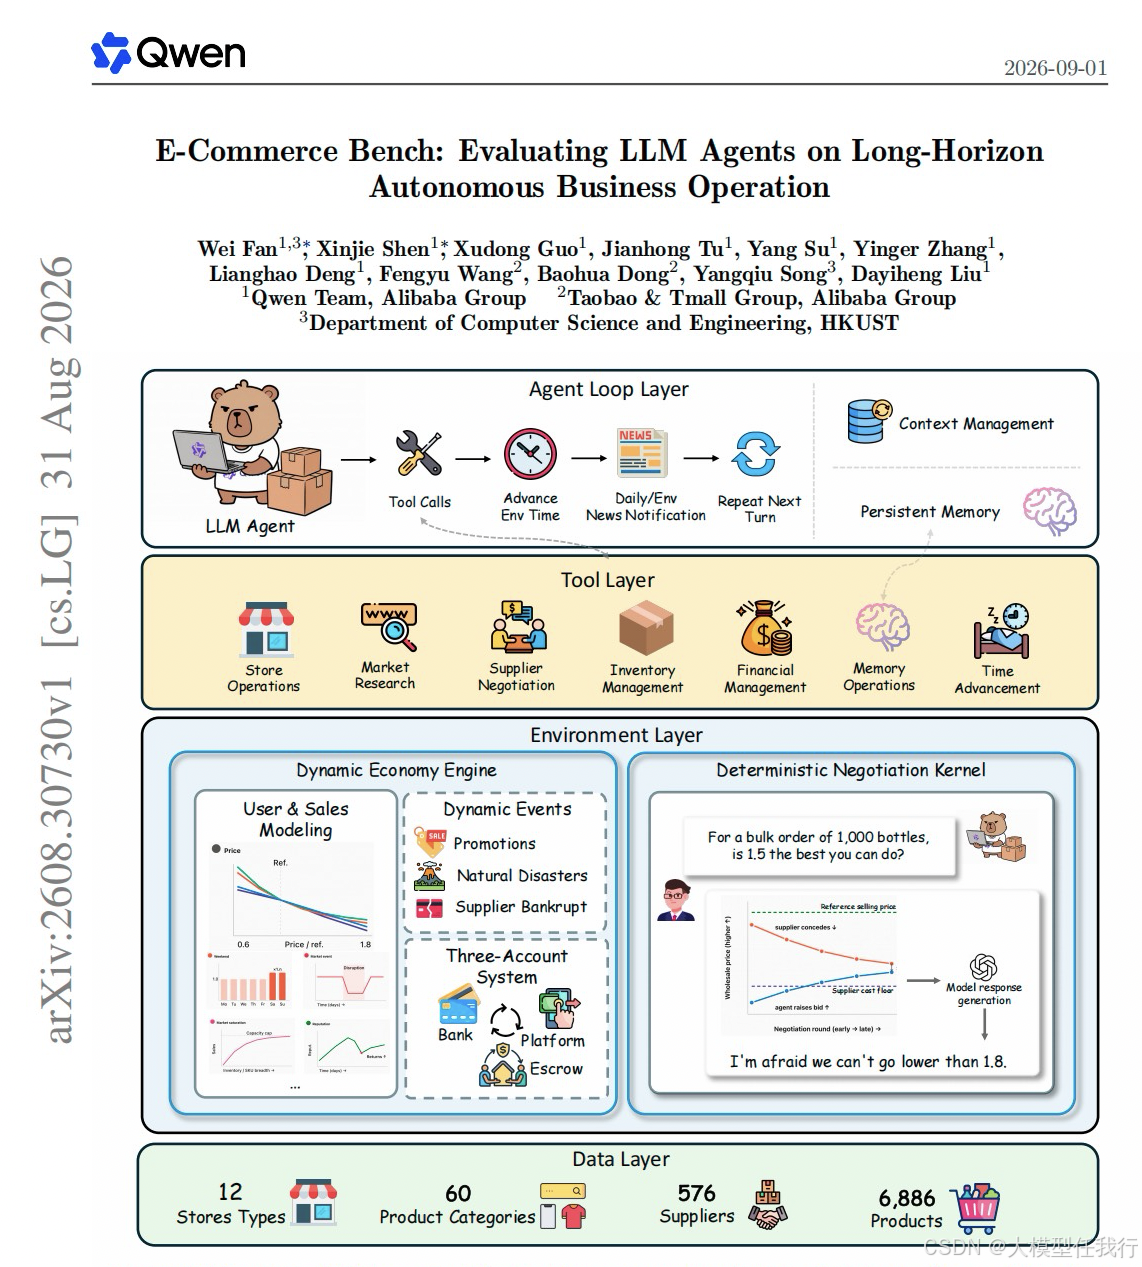
📖标题:E-Commerce Bench: Evaluating LLM Agents on Long-Horizon Autonomous Business Operation
🌐来源:arXiv, 2608.30730v1
🛎️文章简介
🔸研究问题:如何在一个动态、长周期且包含复杂交互的真实商业环境中,准确评估大语言模型智能体的持续决策与适应能力?
🔸主要贡献:论文提出了E-Commerce Bench,这是首个结合真实电商数据、确定性谈判内核及动态事件的开源长周期商业运营评测基准。
📝重点思路
🔸构建基于淘宝天猫真实数据的模拟环境,涵盖6886种商品和576家供应商,智能体需在365天内同时运营多家店铺,执行市场调研、库存采购、销售策略优化及现金流管理。
🔸引入确定性谈判引擎,将供应商的定价、让步和决策逻辑固化为确定性内核,仅由LLM负责对话渲染,消除了传统基准中因LLM扮演对手带来的随机性和不可复现性。
🔸设计包含促销、自然灾害和供应链冲击的动态事件日历,以及固定的多因素需求模型,确保市场需求变化可预测但需智能体主动探索,同时设置部分欺诈性供应商以测试风险识别能力。
🔸建立七维评估体系,除年终总资产外,还涵盖谈判质量、欺诈规避、偿债能力、运营效率、执行能力和长周期学习能力,全面剖析智能体在长期任务中的短板。
🔎分析总结
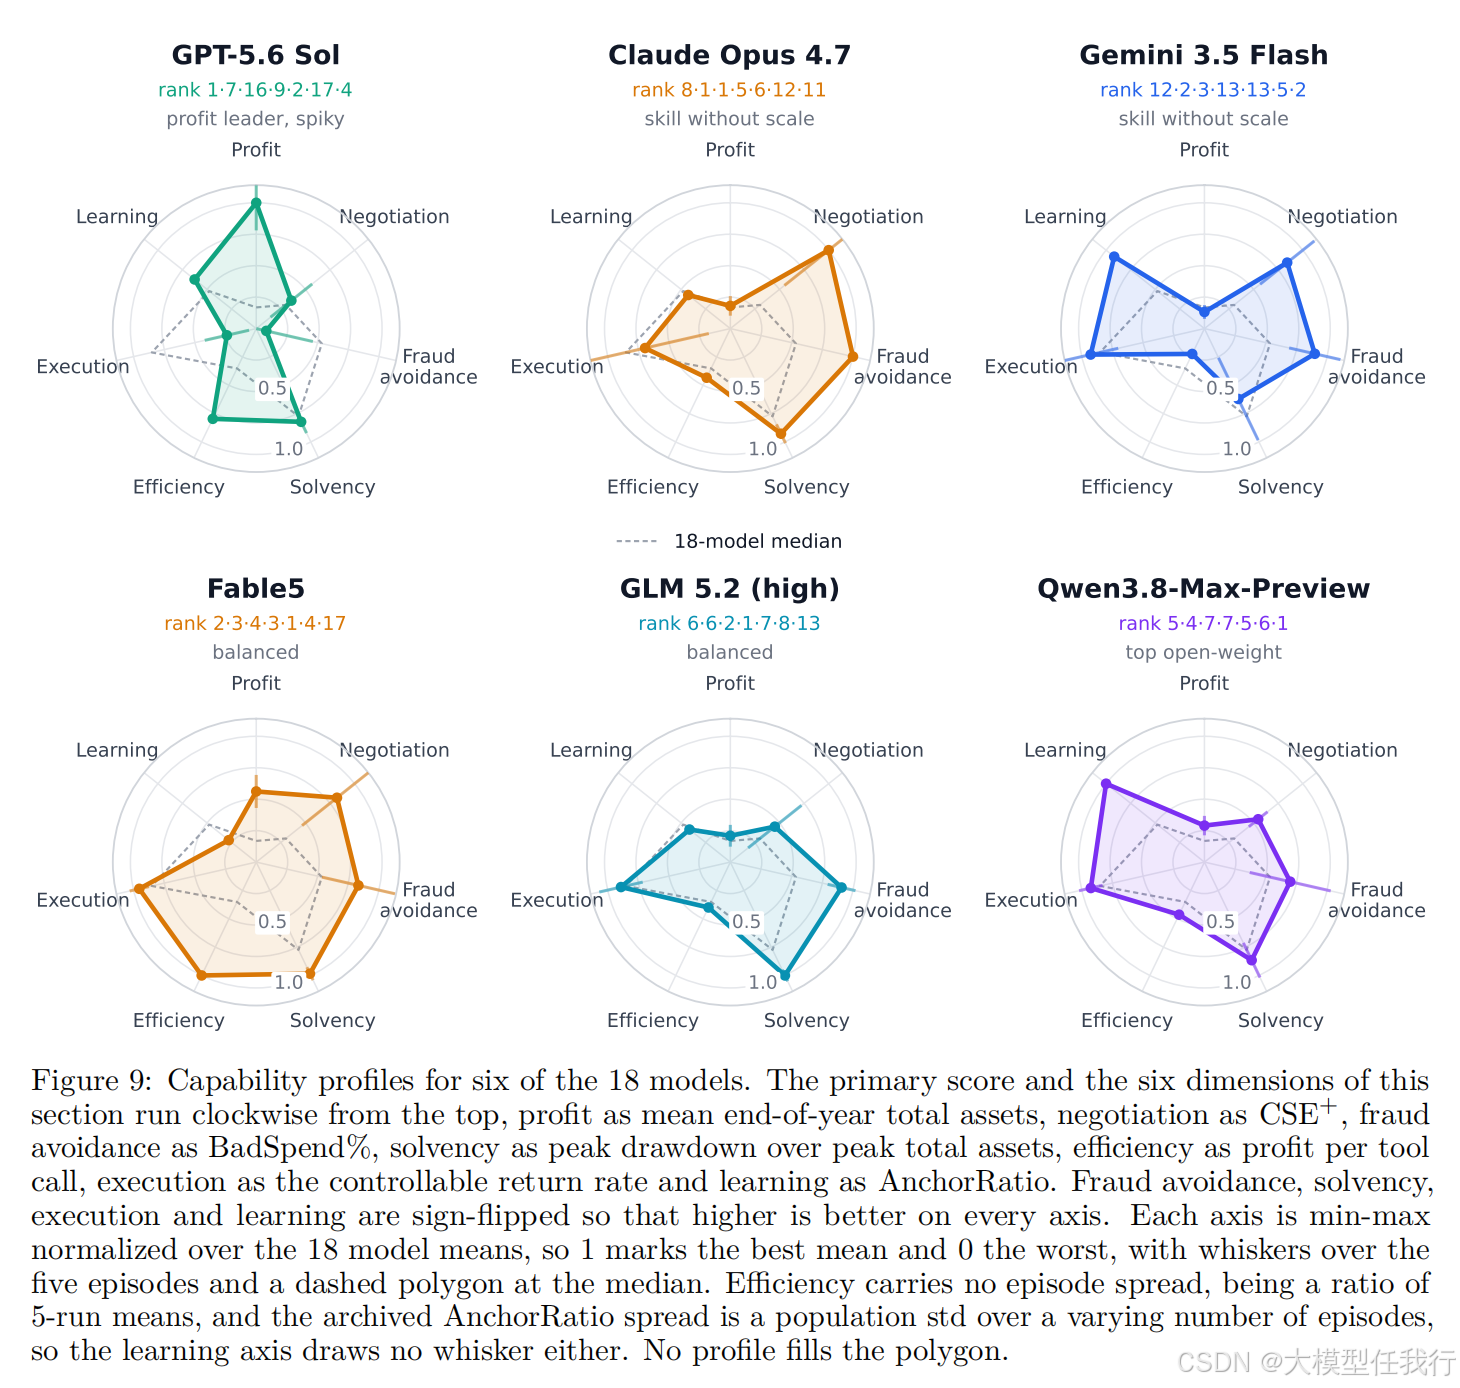
🔸没有任何单一模型在所有维度上占据主导地位,GPT-5.6 Sol虽获得最高年终资产(增长约14倍),但在欺诈规避排名倒数第三,且运营效率低于Fable5。
🔸在开源模型中,Qwen3.8-Max-Preview表现最佳,资产增长4.2倍,是唯一展现出显著长周期学习能力的模型,能在重复采购中逐步压低价格,而其他16个模型未能有效利用历史经验。
🔸多数模型存在严重的长周期记忆缺陷,如忽视持久化记忆模块的使用,导致重复查询信息;部分顶尖模型甚至因现金流管理不善而在年初破产,暴露出其在长期规划与短期执行间的协调弱点。
🔸欺诈规避与盈利能力呈负相关,最擅长谈判和避诈的Claude Opus 4.7最终资产仅居中游,表明在当前环境下,激进的商业策略往往伴随更高的风险暴露。
💡个人观点
论文将评估重心从单次任务完成度转移到跨年度的累积收益与能力演化,揭示了当前LLM智能体在长期记忆保持、风险权衡及经验迁移上的系统性不足。
电商企业物流数字化转型必备!快递鸟 API 接口,72 小时快速完成物流系统集成。全流程实战1V1指导,营造开放的API技术生态圈。
更多推荐
 6
 0
- 0


 已为社区贡献4条内容

所有评论(0)